Corpus B2B de l'Ehrenberg-Bass : huit effectifs, aucun groupe d'achat
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
L'institut qui produit le cadre de distinctivité de marque liste neuf rapports B2B en accès libre, de mai 2021 à novembre 2025. Huit servent leur texte en entier, le neuvième ne sert qu'une préface signée par LinkedIn. J'ai relevé les huit et chaque effectif qu'ils publient : tous comptent des individus, aucun ne compte un groupe d'achat. Le mot committee y apparaît une fois, dans un cadre dont les questions n'interrogent qu'un décideur.
- Neuf rapports listés en accès libre, huit servis en entier. De mai 2021 à novembre 2025 sur le site de l'Ehrenberg-Bass Institute ; le neuvième ne sert qu'une préface de huit cent dix mots, signée par l'équipe du B2B Institute de LinkedIn et non par les chercheurs de l'institut.
- Tous les effectifs publiés comptent des individus. Sept effectifs fermes plus une borne inférieure, et aucune mesure n'a pour dénominateur un groupe d'achat ; aucun de ces rapports ne déclare combien de personnes d'une même entreprise ont été interrogées.
- Le mot committee apparaît une seule fois dans ce corpus. Dans le seul rapport de juillet 2022, où les trois questions d'enquête proposées n'interrogent qu'une personne sur ce qu'elle sait des autres ; douze termes voisins de la décision collective en sont absents.
L’institut qui produit le cadre de distinctivité de marque liste neuf rapports sur le B2B, consultables sans abonnement. Je les ai comptés, et ce qu’ils mesurent n’est pas ce que la littérature commerciale décrit.
- Neuf rapports B2B sont listés en accès libre sur le site de l’institut, de mai 2021 à novembre 2025. Huit servent leur texte en entier dans la page, sans mur payant, dont le plus récent, celui de novembre 2025. Le neuvième ne sert qu’une préface de huit cent dix mots, signée par l’équipe du B2B Institute de LinkedIn et non par les chercheurs de l’institut.
- Tous les effectifs publiés dans ces rapports comptent des individus. Aucune mesure n’a pour dénominateur un groupe d’achat.
- Le mot committee apparaît une fois dans les vingt-six mille sept cent quatre-vingt-quinze mots de ce corpus. Douze autres termes de la décision collective en sont absents.
Ce que l’institut a publié, et ce qu’il garde
L’Ehrenberg-Bass Institute publie sous un intertitre « B2B Reports » neuf rapports en accès libre, chacun daté et signé : Easy to Find: Being Where B2B Buying Happens de novembre 2025, Buyer says no? The rejection of Generative AI brands in B2B d’août 2025, How B2B Brands Grow de novembre 2023, Why you need to advertise: the best product doesn’t win de février 2023, Category Entry Points in a Business-to-Business (B2B) World de juillet 2022, puis quatre rapports de mai 2021, dont The Double Jeopardy Law in B2B shows the way to grow et Brand Rejection in B2B.
Le texte entier est servi dans la page pour huit d’entre eux, sans abonnement ni téléchargement conditionné. Le neuvième, How B2B Brands Grow de novembre 2023, fait exception : la page ne sert qu’une préface de huit cent dix mots, signée « An introduction to the How B2B Brands Grow report from the LinkedIn B2B Institute Team », et le rapport lui-même n’est pas à cette adresse. Tous les comptages qui suivent portent donc sur les huit rapports servis en entier, et sur cette préface pour ce qu’elle vaut.
Cela ne veut pas dire que tout est ouvert. L’institut écrit lui-même que ses sponsors ont un accès exclusif à « hundreds of reports like this », et il présente la mise en accès libre comme une exception : « Occasionally the Ehrenberg-Bass Institute will provide public access to a research report. » Ce corpus fermé existe, son contenu m’est inconnu, et rien de ce qui suit ne prétend dire ce qu’il contient.
Neuf effectifs, neuf comptes de personnes
Ce que les données établissent. J’ai relevé le texte des huit rapports servis en entier et tous les effectifs qu’ils publient en prose, avec l’unité que chacun déclare. Quatre d’entre eux n’en publient aucun, la préface du neuvième non plus. Les autres en donnent sept fermes, plus une borne inférieure.
Le rapport de juillet 2022 en publie trois : six cent six « Business Insurance customers in the USA », six cent neuf « business customers surveyed », et trois cent onze « online advertising decision-makers in the United States » pour une enquête menée pour LinkedIn Marketing Solutions. Celui de mai 2021 sur le rejet de marque en publie deux : six cent neuf « buyers of business banking in the UK » et six cent seize « buyers of business insurance in the USA ». Celui d’août 2025 en publie un, deux mille huit cent trente-cinq « professional users of Generative AI in 13 countries ». Et celui de novembre 2025 donne un échantillon de quatre cent quinze utilisateurs de canaux de vente. S’y ajoute une borne inférieure, et non un effectif : « over 500 B2B marketers in the USA and UK », qui compte des marketeurs de marques et non des acheteurs.
Un effectif de plus existe, et je ne peux pas le citer. Le rapport de novembre 2025 donne pour un même tableau trois valeurs qui ne s’accordent pas : « six cent vingt-quatre » dans le titre du tableau, « over 400 B2B category buyers » dans le corps du texte, et une ligne de source qui répète l’échantillon de quatre cent quinze du tableau précédent. Les trois figurent dans la page, rien ne permet de trancher, et je n’en retiens aucune.
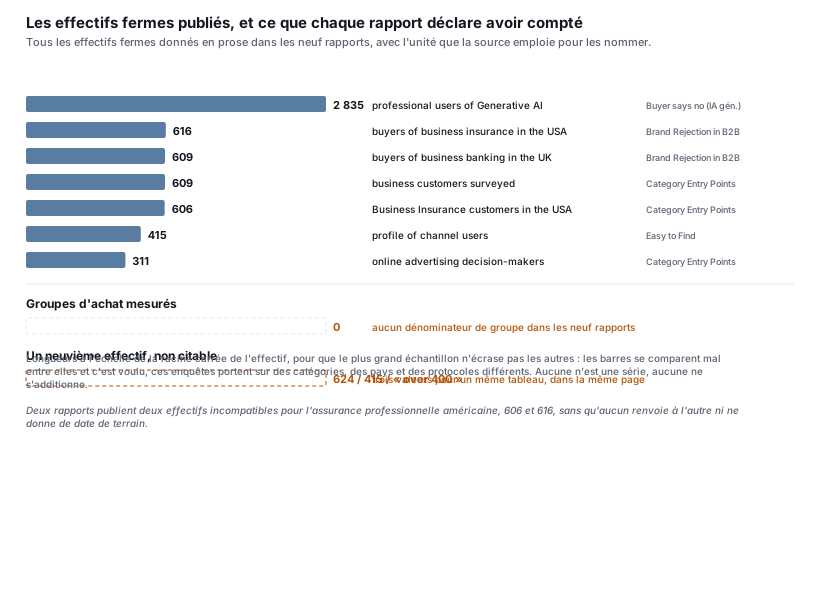
Ce que la méthode interprète. Huit dénominateurs fermes, huit comptes d’individus, aucun compte de groupes d’achat. Le mode de recrutement, quand il est donné, est un panel en ligne, qui recrute des personnes. Et aucun de ces rapports ne déclare combien de personnes d’une même entreprise ont été interrogées, ni s’il y en a eu plusieurs ou une seule. Le protocole n’est pas déclaré, dans un sens ni dans l’autre.
Les métriques le montrent par leur construction, et il faut être précis sur ce qu’elles montrent. Le rapport de juillet 2022 définit trois indicateurs de disponibilité mentale par formule. Deux ont un dénominateur qui compte des personnes : la pénétration mentale est le nombre d’acheteurs ayant au moins un lien avec la marque divisé par la taille totale de l’échantillon, soit quatre cent soixante-douze sur six cent neuf pour Barclays, 78 %, et trois cent vingt et un sur six cent neuf pour RBS, 53 % ; la taille de réseau divise les liens d’une marque par ses acheteurs. Le troisième, la part de marché mentale, ne compte pas des personnes du tout : il divise les liens d’une marque par le total des liens de toutes les marques, trois mille sept cent trente-deux sur trente-sept mille neuf cent quarante-huit. Son dénominateur n’est ni un individu ni un groupe.
Limite de mesure : ces chiffres portent sur des personnes interrogées, pas sur des entreprises clientes. Écrire que 78 % des entreprises clientes associent Barclays à un point d’entrée changerait l’unité et fausserait la mesure.
Le comité apparaît une fois, et il apparaît dans une tête
Ce que les données établissent. Le corps des huit rapports servis en entier, plus la préface du neuvième, fait vingt-deux mille quatre cent quatre-vingt-treize mots. Le mot committee y apparaît une seule fois, dans le seul rapport de juillet 2022. Douze termes voisins n’y apparaissent pas du tout : buying group, buying centre, buying center, consensus, group decision, collective, decision unit, DMU, stakeholder, unanimity, sign-off, veto.
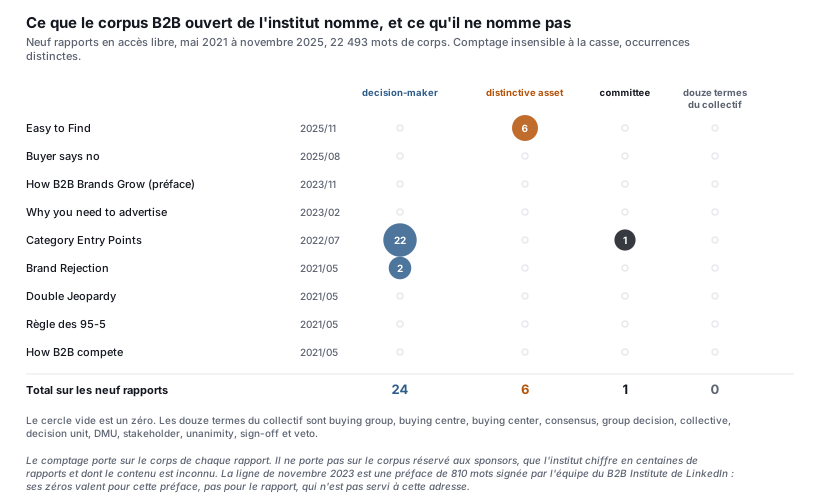
Cette occasion unique n’est pas un aparté. Elle est l’un des sept axes du cadre que le rapport propose pour faire produire des points d’entrée de catégorie, celui qu’il nomme with/for Whom : « With whom is especially important in B2B, where the complex nature of buying committees heavily influences the buying situation. » Suivent quatre catégories de personnes à considérer, la direction, les pairs, les équipes juniors et les clients de l’entreprise.
Ce que la méthode interprète. Le statut de ce passage est ce qui compte, et il se lit dans ses verbes. La direction est quelque chose que le décideur « can have in mind ». La réaction des équipes juniors « can shape decision-makers thoughts about suppliers ». Et les trois questions d’enquête proposées à la suite interrogent une personne sur ce qu’elle sait des autres : « Are senior management involved in the process of buying <insert category/service>? If so, how? » Le comité est là, et il y est comme un indice qui entre dans la mémoire d’un décideur, jamais comme une unité qu’on observe. Ces trois questions n’en interrogent qu’une, sur ce qu’elle sait des autres ; ce que le rapport a fait des autres membres, il ne le dit pas.
Le même rapport pose d’ailleurs sa convention en toutes lettres, dès son résumé : « For consistency the term ‘decision-maker’ will be used to describe the buyer whose memory we want to influence. » C’est un usage de vocabulaire, déclaré pour la commodité, pas une thèse sur la nature de la décision. Mais il dit l’objet de la mesure : une mémoire, au singulier. Le corpus compte vingt-quatre occurrences de decision-maker pour une de committee.
Le cadre décline même chaque axe selon deux perspectives, que le rapport appelle The Business et The Professional. Les deux ont le même sujet grammatical : le décideur. La première désigne les objectifs de l’entreprise que le décideur a en tête, pas la position d’autres personnes recueillie auprès d’elles.
Ce que l’institut a bien fait, et qu’il faut dire avant le reste
Ce que les données établissent. L’institut pose la question du transfert, et il la pose deux fois. Le rapport de juillet 2022 l’énonce en prémisse : « While the specific CEPs may change, buyers in B2C or B2B environments go through similar memory processes, because all buyers draw on the same brain. » Le rapport de mai 2021 sur la double pénalité la reçoit comme une objection et la nomme : « We’ve been asked many times over the years, “Surely B2B is different to consumer marketing, will your empirical laws like Double Jeopardy hold up there?” », puis déclare avoir constitué la liste des différences supposées en interrogeant des marketeurs.
Il produit aussi des données B2B, et une comparaison chiffrée avec le B2C. Sur le rejet de marque, il mesure 11 % en banque professionnelle britannique et 7 % en assurance professionnelle américaine, qu’il rapproche d’une médiane de 9 % relevée en B2C sur cinq cent trente-cinq marques et vingt-quatre catégories. Ce corpus B2C de comparaison n’est ni référencé ni décrit dans le rapport, et je ne peux donc pas le remonter.
Il a recommencé en 2025, sur un terrain plus large : deux mille huit cent trente-cinq utilisateurs professionnels d’IA générative dans treize pays, vingt entreprises testées, un taux de rejet moyen de 6 %, un maximum de 15 %, et la méconnaissance comme première cause de rejet à 22 %.
Ce que la méthode interprète. Il serait donc faux d’écrire que l’institut n’a pas testé son cadre en B2B, ou qu’il ne pose pas la question du transfert. Il fait les deux, publiquement, et il faut le lire avant ma lecture.
Ce que je relève est plus étroit. La liste des raisons pour lesquelles le B2B pourrait différer, celle que l’institut a recueillie auprès de marketeurs et entrepris de traiter, ne contient pas le comité d’achat. Elle contient la valeur d’achat, le cycle structuré, les motivations d’acheteurs professionnels, les contrats longs, les coûts de changement. Pas la décision à plusieurs. Elle n’y est pas écartée : elle n’y est pas posée.
Et l’argument avancé pour le transfert, celui du cerveau commun, a la forme d’une prémisse, pas d’un résultat. Le mot qui le porte est because. Aucune donnée n’est convoquée à cet endroit, et aucune comparaison B2C contre B2B n’y est menée sur un même protocole.
Le corpus ouvert parle des actifs distinctifs sans en mesurer aucun
Ce que les données établissent. Le terme distinctive asset apparaît six fois dans le corpus, toutes dans le seul rapport de novembre 2025. Un comptage brut sur la page en rend sept, parce que le site y sert deux fois le même bloc de texte. Les mots par lesquels ces actifs se mesurent, eux, sont absents du corpus entier : recognition, attribution, fame et uniqueness sont à zéro occurrence sur les vingt-six mille sept cent quatre-vingt-quinze mots.
Le rapport de novembre 2025, dont deux des enquêtes portent la mention « Survey conducted for Linkedin », les range sous le nom d’« owned prominence », par opposition à la notoriété qu’on loue : « These are the Distinctive Assets that work as branding devices in sales environments. » Et il pose un constat sur l’équipement des marques B2B : « while every B2B brand has a logo, there is often not much else to boost branding effects. This means B2B brands are often ill-equipped to cut through environmental, mental, or competitive clutter. »
Ce que la méthode interprète. Ces deux phrases sont sans effectif, sans échantillon et sans période. Elles disent ce qu’il faut faire, elles ne rapportent pas ce qui a été mesuré. Les seuls actifs que le rapport montre le sont dans un jeu, « Prominence Challenge: Which brands do these assets belong to? », dont aucun résultat n’est publié et où personne n’est interrogé. Un seul des rapports du corpus ouvert parle des actifs distinctifs en B2B, il les recommande, et il n’en publie aucune mesure.
Je ne peux pas en conclure que ces actifs n’ont jamais été mesurés en B2B. Deux ensembles échappent à mon comptage. Le corpus réservé aux sponsors, d’abord. Ensuite une étude conduite avec le prestataire Distinctive BAT par Peter Weinberg et Jon Lombardo, alors au B2B Institute de LinkedIn : plus de trois cents actifs de marque sur cinquante-neuf marques et six catégories B2B. Je ne connais ce périmètre que par un billet de praticien qui le rapporte, et ses résultats me sont restés fermés.
Deux autres instruments, deux autres unités, toujours pas le groupe
Ce que les données établissent. L’audit de l’agence STFO, signé Louis Grenier, qui note cent entreprises B2B SaaS et IA, le fait sur huit actifs distinctifs, chacun noté de 0 à 3, pour un total maximal de vingt-quatre, sur une échelle que son auteur déclare « built on Jenni Romaniuk’s work at the Ehrenberg-Bass Institute ». Dans ce protocole, aucun acheteur n’est interrogé, et son auteur le décrit lui-même : l’échantillon a été choisi par un modèle de langage, les actifs notés par un dispositif automatisé, et chaque score relu à la main par lui. Aucune enquête, aucun panel, aucune question posée à un client.
Ce même audit n’aborde ni le comité d’achat, ni la comparaison au B2C, ni le processus de décision : committee, B2C et decision sont à zéro occurrence dans son texte intégral. Il applique un cadre, il ne le discute pas, et ce silence d’application n’est pas une prise de position sur la transposabilité.
Du côté de la description de l’achat, Gartner, qui produit ces données et vend le conseil qu’elles justifient, décrit une décision qui n’est ni linéaire ni individuelle, et nomme la création du consensus comme l’une des six tâches d’achat, « we need to get everyone on board ».
Ce que la méthode interprète. Trois instruments, trois unités d’observation. L’audit note un actif jugé par un évaluateur. Le corpus de l’institut mesure la mémoire d’un acheteur, un par un. Le cabinet, lui, décrit un processus de groupe. L’objet décrit est collectif, les objets mesurés sont un actif et une mémoire individuelle, et rien dans ce dossier ne mesure ce qui se passe entre les deux.
Un score d’audit ne peut donc rien établir sur la façon dont un décideur, seul ou en groupe, reconnaît une marque : aucun acheteur ne voit ces actifs dans ce protocole.
Limite de mesure : le cabinet qui décrit la décision de groupe ne chiffre aucun effectif de comité sur la page relevée, et je n’en cite donc aucun. Ce qui est établi est la nature collective de la décision, pas son nombre de participants.
Ce que ce comptage ne permet pas de conclure
Extrapolation prudente. Ce comptage porte sur neuf rapports en accès libre, pas sur la production de l’institut. Le corpus réservé aux sponsors existe, l’institut le chiffre lui-même en centaines de rapports, et je ne peux dire ni qu’il traite la décision collective ni qu’il l’ignore. La formulation exacte est celle-ci, et elle suffit : dans le corpus B2B ouvert de l’institut, la décision collective n’est pas l’unité mesurée.
Test de falsification. Un rapport publiant une mesure dont le dénominateur serait un groupe d’achat, plusieurs membres d’une même organisation interrogés séparément puis rapprochés, suffirait à retirer ce constat. Rien dans ce que j’ai relevé ne s’en approche : aucun tableau, aucune figure ne rapproche les réponses de plusieurs membres d’une même organisation.
Mes réserves
Périmètre. Mon comptage porte sur les neuf rapports en accès libre, dont j’ai relevé le texte intégral et dont les neuf adresses sont en bibliographie. Il ne porte pas sur la production de l’institut : celui-ci chiffre son corpus réservé aux sponsors en centaines de rapports, et je n’y ai pas accès. Une mesure de groupe d’achat peut s’y trouver.
Aucune de mes sources ne dit vraiment où elle s’arrête. Aucun de ces rapports ne comporte de section de limites. Le seul énoncé de portée que j’y trouve est méthodologique et adressé au lecteur qui voudrait refaire le travail : « There is no one single sample size recommendation ». La borne de leur validité, je l’établis à partir de la méthode qu’ils déclarent, je ne la cite pas depuis eux.
Les tableaux et figures de ces rapports sont des images. Tout ce que je rapporte vient donc de la prose courante. Un chiffre présent dans une figure et absent du texte m’a échappé.
Deux effectifs incompatibles pour un même objet. L’assurance professionnelle américaine est portée à six cent six personnes dans le rapport de juillet 2022 et à six cent seize dans celui de mai 2021, avec dix-sept unités d’assurance de part et d’autre, mais nommées produits dans l’un et marques dans l’autre. Aucun des deux rapports ne renvoie à l’autre, aucun ne donne de date de terrain. Je ne peux dire ni que c’est la même enquête, ni que ce sont deux enquêtes distinctes.
Une incohérence interne que je ne répercute pas. Le rapport de juillet 2022 donne deux valeurs différentes pour le même effectif de liens, trois mille sept cent trente-deux à un endroit et trois mille sept cent quarante-deux à un autre. Les six métriques se recalculent par ailleurs sur les chiffres publiés.
Une source du dossier ne dit rien de ce sujet. La page « Answering critics », par laquelle Byron Sharp répond aux contradicteurs de l’institut, ne traite pas du B2B. Elle n’établit ni qu’il a répondu à l’objection de la décision collective, ni qu’il ne l’a pas fait, et je ne la cite dans aucun des deux sens.
Un argument qu’on prête souvent au camp du transfert direct ne le porte pas. Le billet de Paul Bailey, directeur de stratégie de marque en agence, soutient que l’achat B2B est aussi émotionnel, mais sur d’autres émotions que le B2C, ce qui affirme une différence et non une identité. Sa formule sur les entreprises devenues « Business to People » est au conditionnel, en dernière ligne.
ISP-M35/100· 31-55 % · Preuves limitées · La preuve centrale de cette page est double, et les deux moitiés ne se notent pas pareil. La première est un relevé documentaire : le comptage des termes et des effectifs sur le texte des huit rapports servis en entier et sur la préface du neuvième, refaisable par quiconque avec curl et grep, les neuf adresses étant publiques et portées en bibliographie. Ce relevé n'a pas de barreau propre dans l'échelle marketing, et ce n'est pas lui qui commande la note. La seconde moitié est ce que ces rapports mesurent, et c'est elle qui fixe le barreau : des enquêtes déclaratives par panel en ligne sur échantillons décrits, six cent six, six cent neuf deux fois, six cent seize, trois cent onze, quatre cent quinze et deux mille huit cent trente-cinq répondants. C'est exactement ce que désigne le barreau de la mesure déclarative : un instrument réel, dont l'écart entre déclaration et comportement est lui-même un résultat du champ. Cinq des neuf rapports ne publient aucun effectif, et ne portent donc que le comptage. Il n'y a pas de barreau au-dessus parce qu'aucune de ces mesures n'assigne, ne compare un groupe témoin ni n'observe un comportement d'achat sur transaction. Le plafond de partie prenante s'applique de surcroît, l'institut étant l'auteur du cadre qu'il étend, mais il ne mord pas ici : il plafonne à un barreau plus haut que celui où cette page est notée. La convergence est donnée pour modérée. Elle est réelle sur ce qui porte la thèse : les quatre rapports qui publient des effectifs donnent tous des comptes de personnes, et les cinq autres ne portent aucune mesure qui le contredirait. Elle n'est pas forte, et pour cinq raisons que je préfère écrire. L'un des neuf rapports n'est pas servi, seule sa préface l'est. Ces rapports viennent d'un émetteur unique, et une même autrice en signe sept sur neuf, les deux autres étant signés du seul John Dawes. Deux d'entre eux publient des effectifs incompatibles pour la même catégorie et le même pays, six cent six contre six cent seize, sans qu'aucun ne renvoie à l'autre. Un troisième donne trois valeurs incompatibles pour un même tableau. Et les deux instruments extérieurs du dossier ne confirment rien : l'audit d'agence déclare lui-même appliquer le cadre de l'institut, donc il ne lui est pas extérieur sur le fond, et la description du parcours d'achat ne mesure pas l'objet, ce qui ne vaut ni confirmation ni contradiction. La réplication est nulle : ce relevé d'unités d'observation est un comptage que je fais moi-même sur des documents publics, et je ne l'adosse à aucun travail antérieur. L'effectif observé est modéré parce que les unités sont ici les rapports eux-mêmes, neuf documents dont j'ai relevé le texte intégral, et les sept échantillons fermes qu'ils déclarent, dont le plus grand compte deux mille huit cent trente-cinq personnes.
L'Indice de solidité des preuves évalue la base empirique de cette analyse sur quatre critères pondérés : type de preuve (40 %), convergence (30 %), réplication (20 %), puissance (10 %). L'axe type de preuve est calibré par champ : 100 y désigne le meilleur dispositif que l'échelle ISP-M sache produire, et non une preuve absolue.
La preuve centrale de cette page est double, et les deux moitiés ne se notent pas pareil. La première est un relevé documentaire : le comptage des termes et des effectifs sur le texte des huit rapports servis en entier et sur la préface du neuvième, refaisable par quiconque avec curl et grep, les neuf adresses étant publiques et portées en bibliographie. Ce relevé n'a pas de barreau propre dans l'échelle marketing, et ce n'est pas lui qui commande la note. La seconde moitié est ce que ces rapports mesurent, et c'est elle qui fixe le barreau : des enquêtes déclaratives par panel en ligne sur échantillons décrits, six cent six, six cent neuf deux fois, six cent seize, trois cent onze, quatre cent quinze et deux mille huit cent trente-cinq répondants. C'est exactement ce que désigne le barreau de la mesure déclarative : un instrument réel, dont l'écart entre déclaration et comportement est lui-même un résultat du champ. Cinq des neuf rapports ne publient aucun effectif, et ne portent donc que le comptage. Il n'y a pas de barreau au-dessus parce qu'aucune de ces mesures n'assigne, ne compare un groupe témoin ni n'observe un comportement d'achat sur transaction. Le plafond de partie prenante s'applique de surcroît, l'institut étant l'auteur du cadre qu'il étend, mais il ne mord pas ici : il plafonne à un barreau plus haut que celui où cette page est notée. La convergence est donnée pour modérée. Elle est réelle sur ce qui porte la thèse : les quatre rapports qui publient des effectifs donnent tous des comptes de personnes, et les cinq autres ne portent aucune mesure qui le contredirait. Elle n'est pas forte, et pour cinq raisons que je préfère écrire. L'un des neuf rapports n'est pas servi, seule sa préface l'est. Ces rapports viennent d'un émetteur unique, et une même autrice en signe sept sur neuf, les deux autres étant signés du seul John Dawes. Deux d'entre eux publient des effectifs incompatibles pour la même catégorie et le même pays, six cent six contre six cent seize, sans qu'aucun ne renvoie à l'autre. Un troisième donne trois valeurs incompatibles pour un même tableau. Et les deux instruments extérieurs du dossier ne confirment rien : l'audit d'agence déclare lui-même appliquer le cadre de l'institut, donc il ne lui est pas extérieur sur le fond, et la description du parcours d'achat ne mesure pas l'objet, ce qui ne vaut ni confirmation ni contradiction. La réplication est nulle : ce relevé d'unités d'observation est un comptage que je fais moi-même sur des documents publics, et je ne l'adosse à aucun travail antérieur. L'effectif observé est modéré parce que les unités sont ici les rapports eux-mêmes, neuf documents dont j'ai relevé le texte intégral, et les sept échantillons fermes qu'ils déclarent, dont le plus grand compte deux mille huit cent trente-cinq personnes.
- Une régularité d'achat B2B serait mesurée sur des achats réellement enregistrés, avec le groupe d'achat pour dénominateur et non le répondant individuel, formulée assez précisément pour pouvoir être fausse, et reproduite sur plusieurs catégories et plusieurs pays.L'Ehrenberg-Bass Institute, auteur du cadre étendu au B2B et des lois de panel qu'il a établies en grande consommation. Ses sept échantillons fermes en B2B, de trois cent onze à deux mille huit cent trente-cinq répondants, comptent tous des personnes. · un dispositif approchant existe, sans remplir la condition
- Cette régularité serait vérifiée sur des données qui n'ont pas servi à la calibrer, le protocole, les effectifs et les dénominateurs étant ouverts à un lecteur extérieur capable de refaire le calcul.L'Ehrenberg-Bass Institute, qui déclare réserver à ses sponsors l'accès exclusif à des centaines de rapports et n'en publie que neuf en accès libre sur le B2B. · existe, mais n’est pas consultable
- La réplication serait signée par une équipe qui n'est pas l'auteur du cadre répliqué : l'échelle de ce domaine range une réplication cosignée par lui du côté de la partie prenante.Une équipe extérieure à l'institut. Le seul travail de ce type dont ce dossier porte la trace est une étude du B2B Institute de LinkedIn avec l'éditeur Distinctive BAT, sur plus de trois cents actifs, cinquante-neuf marques et six catégories B2B, rapportée par un billet tiers sans que ses résultats soient consultables. · existe, mais n’est pas consultable
Ce dispositif porterait l'indice à 55 sur 100, dans le palier « Preuves limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Score de 35/100 (31-55 %) établi le 31 août 2026.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Disponibilité mentale· mental availability↗
- Probabilité qu'une marque soit remémorée dans une situation d'achat ; concept central de la science marketing de l'Ehrenberg-Bass Institute, distinct de la fidélité attitudinale.
- Actifs distinctifs de marque· distinctive brand assets↗
- Éléments sensoriels ou visuels, couleur, logo, typographie, son, identité humaine, qui permettent à une marque d'être reconnue sans que son nom soit énoncé. Concept développé par Jenni Romaniuk et Byron Sharp à l'Ehrenberg-Bass Institute, distinct de la différenciation perçue de l'offre.
- Grille d'actifs distinctifs· Distinctive Asset Grid↗
- Outil développé par Jenni Romaniuk qui positionne chaque actif de marque sur deux axes mesurés par sondage consommateur, la fame, la part de personnes qui associent l'actif à la marque, et l'uniqueness, l'absence de confusion avec un concurrent. Distinct d'un audit expert qui note l'existence visuelle d'un actif sans interroger de consommateur réel.
Modification apportée · mis à jour le 31 août 2026
J'ai repris cette pièce sur ses sources le 31 août 2026, et elle en sort renversée sur son point de départ. J'écrivais que le rapport B2B de l'institut était réservé à ses sponsors, et j'en tirais que la validité du transfert restait, faute d'accès, une hypothèse. C'est faux : l'institut publie neuf rapports B2B en accès libre, et celui de novembre 2025 en fait partie. Je ne les avais pas ouverts. J'ai retiré tout l'argument fondé sur cette inaccessibilité et refait la lecture sur ces documents. Trois affirmations tombent avec lui. J'écrivais qu'aucun document consultable ne reliait le cadre à la décision collective : le rapport de juillet 2022 le fait, il consacre au comité d'achat l'un des sept axes de son cadre. J'écrivais que l'institut ne posait pas la question du transfert : il la pose dans deux rapports, une fois en prémisse et une fois comme une objection recueillie auprès de marketeurs. Et je présentais l'absence de discussion comme un résultat : ce n'en est pas un. Ce qui reste, et que je n'avais pas vu, est plus étroit et se mesure : les effectifs publiés dans ces rapports comptent tous des personnes, aucun n'a pour dénominateur un groupe d'achat, et l'unique occurrence du mot committee donne au comité le statut d'un indice dans la mémoire d'un décideur. En reprenant ce comptage, j'ai corrigé son périmètre : sur les neuf rapports listés, huit servent leur texte en entier, le neuvième ne sert qu'une préface signée par l'équipe du B2B Institute de LinkedIn, et le rapport lui-même n'est pas à cette adresse. Le total de mots, le nombre d'occurrences et le nombre d'effectifs fermes ont été refaits sur ce périmètre exact. J'ai ramené à six les occurrences de « distinctive asset », un comptage brut en rendant sept parce que le site sert deux fois le même bloc de texte. J'ai retiré « plus de cinq cents marketeurs » de la liste des effectifs fermes : c'est une borne inférieure, et elle compte des marketeurs de marques, pas des acheteurs. J'ai corrigé une affirmation qui appliquait aux autres un standard que je m'épargnais : sur les trois indicateurs de disponibilité mentale du rapport de juillet 2022, deux ont un dénominateur qui compte des personnes, le troisième compte des liens entre marques et situations d'achat. J'ai enfin dit ce que je taisais sur ma source la plus structurante, deux de ses enquêtes étant commandées par LinkedIn, quand je signalais l'intérêt commercial des autres sources du dossier. J'ai changé l'adresse de cette page : l'ancienne affirmait que le transfert n'était pas testé, ce que le dossier ne permet pas de dire. J'ai ajouté deux encadrés « En clair » : l'un sur ce que compte le dénominateur d'une enquête menée personne par personne, l'autre sur les trois unités d'observation que cette page met côte à côte.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus