Confiance dans l'IA : 58 % et 46 % ne répondent pas à la même question
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
L'étude Trust in AI de l'Université de Melbourne et KPMG mesure la confiance par deux échelles distinctes, administrées dans le même questionnaire : l'une juge les systèmes d'IA, l'autre demande de s'y fier. L'étude publie entre elles une association forte, r = .79.
- 58 % perçoivent les systèmes d'IA comme dignes de confiance. Au sens d'un accord au moins partiel sur une échelle agrégée de neuf items, dans l'étude Trust in AI de l'Université de Melbourne et KPMG.
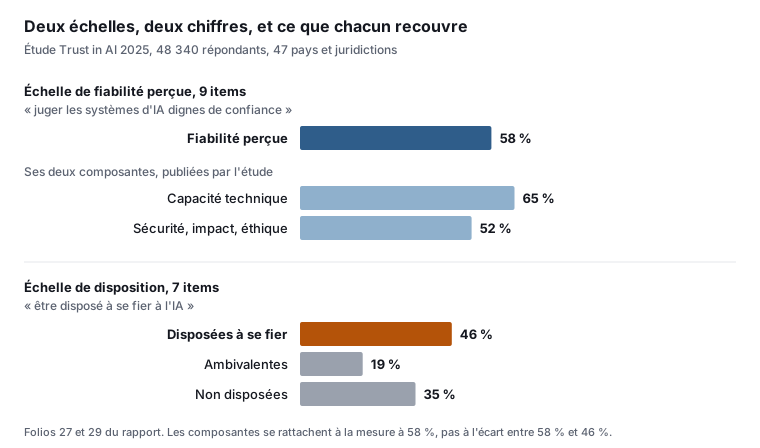
- 46 % se disent disposées à leur faire confiance, et les 54 % restants ne sont pas un bloc. 35 % ne sont pas disposées, 19 % sont ambivalentes.
- Les deux valeurs viennent de deux échelles distinctes. L'étude ne dit pas si chaque répondant a répondu aux deux, ni sur quelles bases chaque agrégat est calculé, et publie entre elles une association qu'elle qualifie de forte, r = .79, sans en donner l'unité d'analyse.
Une étude publie deux chiffres sous le même mot de confiance. 58 % des personnes interrogées dans le monde jugent les systèmes d’IA dignes de confiance. 46 % se disent disposées à leur faire confiance. Lire l’écart entre les deux comme un écart entre ce que les gens disent et ce qu’ils feraient serait une erreur : ni l’une ni l’autre n’observe un comportement, et l’explication que l’étude avance elle-même de leur différence tient en une note de fin, sans mesure à l’appui [1].
- 58 % perçoivent les systèmes d’IA comme dignes de confiance, au sens d’un accord au moins partiel sur une échelle agrégée de neuf items [1].
- 46 % se disent disposées à faire confiance à l’IA. Les 54 % restants ne sont pas un bloc : 35 % ne sont pas disposées, 19 % sont ambivalentes [1].
- Les deux valeurs viennent de deux échelles distinctes, décrites dans la même section de méthode de l’enquête. L’étude ne dit pas si chaque répondant a répondu aux deux, ni sur quelles bases chaque agrégat est calculé, et publie entre elles une association qu’elle qualifie de forte, r = .79, sans en donner l’unité d’analyse [1].
Deux instruments, pas deux mondes
Ce que les données établissent. L’étude interroge 48 340 personnes dans 47 pays et juridictions, entre novembre 2024 et la mi-janvier 2025, avec 1 001 à 1 098 répondants par pays. Chaque répondant se voit attribuer au hasard un objet parmi quatre : l’IA générative, l’IA en santé, l’IA appliquée aux ressources humaines, ou les systèmes d’IA en général. L’étude déclare des effectifs équivalents entre ces quatre groupes, sans publier l’effectif exact de chacun de ses agrégats [1].
Sur cet objet, la disposition à faire confiance est mesurée. L’étude ne précise pas si la fiabilité perçue est mesurée sur le même objet. La fiabilité perçue est mesurée par neuf items, adaptés d’un instrument publié en 2002. La disposition à faire confiance est mesurée par sept items, adaptés d’un instrument publié en 2012. L’écart entre 58 % et 46 % est un écart entre deux échelles décrites dans le même questionnaire, et non entre deux vagues ni deux périodes. L’étude ne publie ni le détail des bases de chacun de ses deux agrégats mondiaux, ni la section du questionnaire à laquelle appartient la fiabilité perçue [1].
L’étude donne son explication de cet écart, et il faut la citer telle qu’elle est écrite, en note de fin, à l’endroit exact où le chiffre de 58 % apparaît. Les perceptions de fiabilité sont typiquement plus hautes que les intentions de confiance, parce que faire confiance implique un risque et une vulnérabilité, en s’appuyant sur la sortie du système ou en lui confiant des informations, alors que juger un système fiable n’implique ni l’un ni l’autre. C’est une explication définitionnelle, pas un résultat mesuré [1].
La même note publie la grandeur que la lecture courante laisse dehors : l’association entre les deux mesures vaut r = .79, et l’étude la qualifie de forte. Les deux mesures ne varient pas indépendamment l’une de l’autre : l’étude publie entre elles une association qu’elle qualifie de forte, sans en publier l’unité d’analyse. L’explication de l’écart de niveau que l’étude propose, la vulnérabilité qu’implique le fait de se fier et que n’implique pas le fait de juger, est avancée en note de fin sans aucune mesure à l’appui. Les deux instruments diffèrent par ailleurs par leur nombre d’items, neuf contre sept, et par le libellé de leurs modalités hautes. Le rapport ne mesure pas la part de l’écart imputable à ces différences, ce qui empêche de tenir son explication pour établie [1].
Aucune des deux mesures n’est d’ailleurs uniforme. La disposition à faire confiance vaut 52 % pour l’IA en santé, 45 % pour les systèmes d’IA en général, 44 % pour l’IA générative et 42 % pour l’IA appliquée aux ressources humaines. Le chiffre agrégé de 46 % ne s’applique tel quel à aucune de ces quatre applications [1].
Elle se décompose même à l’intérieur d’une seule application. L’étude distingue deux façons de manifester sa confiance, s’appuyer sur la sortie du système et lui confier des informations, et ne les chiffre que pour l’IA en santé : 48 % pour la première, 57 % pour la seconde. Le partage y est plus élevé que le recours pour l’IA en santé, et l’étude affirme retrouver une différence entre les deux sur les applications, sans préciser si elle va dans le même sens ni la chiffrer ailleurs [1].
La troisième mesure du rapport se lit avec la même prudence. L’acceptation atteint 72 %, mais cette valeur additionne 33 points d’acceptation élevée et 39 points d’acceptation modérée, que l’étude décrit comme marquant un certain degré d’ambivalence [1].
L’étude publie aussi une décomposition, qui se rattache à la seule mesure de fiabilité perçue et non à l’écart entre les deux mesures. La confiance dans la capacité technique de l’IA à fournir un résultat exact et fiable atteint 65 %, contre 52 % pour sa sécurité, son impact sur les personnes et son caractère éthique. Ces deux valeurs sont les deux composantes de la seule mesure à 58 %. Elles ne décomposent pas l’écart entre 58 % et 46 %, et l’étude ne les applique pas à sa mesure de disposition [1].
Sur ce que produit cette confiance, l’étude publie des associations et interdit explicitement d’y lire des causes. Elle l’écrit à deux endroits distincts. Ses analyses corrélationnelles indiquent des associations et n’infèrent pas de causalité. Et ses données étant transversales et auto-déclarées, la causalité ne peut pas et ne doit pas être inférée. La confiance est associée à l’acceptation à r = .70 et à l’usage à r = .48 [1].
Ce que la méthode interprète. Son modèle d’ensemble déplace le centre de gravité du sujet. Dans la Figure 32, la voie institutionnelle est celle que l’étude désigne comme la plus importante vers la confiance, à .62 ; la figure porte par ailleurs .23, .11 et -.08 sur les autres déterminants. Cette voie réunit deux croyances : que les lois, règles et dispositifs de gouvernance actuels suffisent à rendre l’usage de l’IA sûr, et que les acteurs qui la développent et l’emploient agissent dans l’intérêt du public [1].
Un écart régional, et la question à laquelle il répond
Ce que les données établissent. L’étude publie trois grandeurs par groupe économique, selon la classification du Fonds monétaire international. La disposition à faire confiance vaut 39 % dans les économies avancées contre 57 % dans les économies émergentes. Le jugement de fiabilité vaut 52 % contre 69 %. L’acceptation vaut 65 % contre 84 % [1].
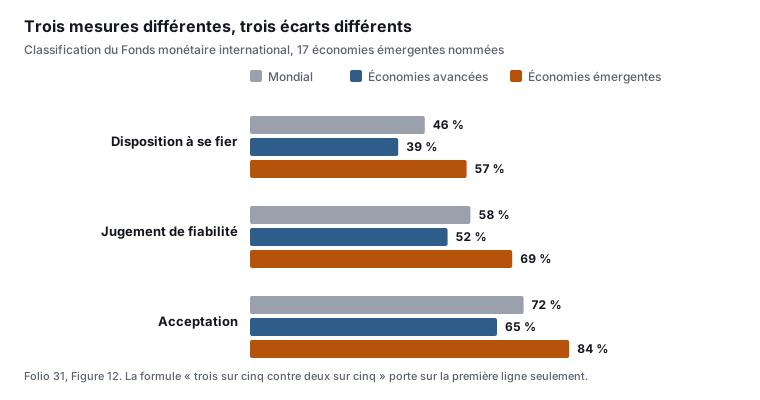
La formule retenue par le communiqué de presse, trois personnes sur cinq contre deux sur cinq, se rattache à la disposition et non au jugement de fiabilité [1] [2]. L’étude le tranche elle-même : dans les économies avancées, deux personnes sur cinq sont disposées à faire confiance aux systèmes d’IA en s’appuyant sur leur sortie et en partageant des informations avec eux, la moitié les jugent dignes de confiance, et deux tiers déclarent un niveau au moins modéré d’acceptation [1].
Un détail de rédaction mérite l’attention, parce qu’il se lit mal dans le résumé de l’étude. Deux formules « trois sur cinq » y voisinent sans désigner la même chose : l’une porte sur les personnes des économies avancées non disposées ou incertaines, l’autre sur les personnes des économies émergentes disposées, dont l’étude publie la valeur, 57 %. La symétrie de langage recouvre une asymétrie de contenu [1].
L’écart ne fait pas des économies émergentes un bloc acquis à l’IA : 43 % de leurs répondants restent ambivalents ou non disposés, ce que l’étude relève elle-même pour dire que la confiance n’y est pas acquise [1].
Quatre autres séries suivent la même pente. La formation ou l’éducation liée à l’IA atteint 50 % dans les économies émergentes contre 32 % dans les avancées. La connaissance auto-déclarée de niveau modéré ou élevé atteint 64 % contre 46 %. Le sentiment d’efficacité dans l’usage, tel que défini par l’étude, atteint 74 % contre 51 %. L’usage régulier ou semi-régulier, tel que l’étude le définit, atteint 80 % contre 58 % ; au niveau mondial, ce même seuil inclut « tous les quelques mois » [1].
Par pays, l’étude écrit que plus de la moitié des personnes interrogées se disent disposées à faire confiance aux systèmes d’IA dans 12 des 17 économies émergentes. La fourchette qu’elle donne dans la même phrase, de 41 % en Pologne à 79 % au Nigeria, couvre les 17 et non les 12 : la Pologne, borne basse, est en dessous du seuil que la phrase annonce. Du côté des économies avancées, elle cite la Norvège, l’Espagne, Israël et Singapour comme les économies avancées où la confiance est la plus haute, toutes annoncées au-dessus de 50 %, et place la Finlande et le Japon au plus bas, entre 25 % et 28 % [1].
Le relevé de la figure correspondante donne les quatre valeurs avancées : Norvège 54, Espagne 51, Israël 51 et Singapour 50. La figure affiche donc 50 pour Singapour, valeur qui n’est pas au-dessus de 50, alors que la phrase du rapport les annonce toutes au-dessus de ce seuil [1].
Ce que cet écart change pour lire un chiffre de confiance
Ce que la méthode interprète. Un chiffre de confiance agrégé mesure ce que sa question mesure, et rien de plus. Ici, la question qui produit 58 % demande de juger un objet ; celle qui produit 46 % demande d’accepter une vulnérabilité vis-à-vis de cet objet. Reprendre le premier pour parler du second revient à changer de question sans le dire [1].
Ce que les données établissent. Le même rapport en fournit une illustration. Il emploie deux libellés différents pour la même modalité de son échelle de disposition : « Willing » dans une figure, « Mostly willing » dans deux autres. Rien n’y est faux, mais toute citation doit reprendre le libellé de la figure qu’elle cite [1].
Il en fournit une seconde, sur son propre décompte. Le rapport nomme 17 économies émergentes sur les 47 pays et juridictions de son échantillon, puis écrit ailleurs que moins de la moitié font confiance aux systèmes d’IA dans 25 des 29 économies avancées. 17 plus 29 font 46, et non 47 : les deux décomptes ne s’additionnent pas à l’effectif de pays que l’étude déclare. L’écart d’une unité ne déplace aucun des ordres de grandeur publiés [1].
Ce que la méthode interprète. Avant de citer un chiffre déclaratif comme une mesure de comportement, trois vérifications suffisent, et elles ne demandent que le document primaire.
- Retrouver la question exacte posée aux répondants, son échelle et le seuil à partir duquel une réponse est comptée dans le pourcentage publié.
- Chercher, dans la même source, la mesure la plus proche de la décision réelle visée, comme l’est ici la disposition par rapport au jugement de fiabilité.
- Vérifier que chaque reprise apparemment indépendante ne remonte pas à la même source de données.
Ce type d’écart entre deux mesures voisines d’une même enquête n’est pas propre à l’IA. Probans documente un écart voisin dans le champ du marketing.
Ce qu’un second baromètre permet et ne permet pas de dire
Ce que les données établissent. Un second baromètre, produit par un émetteur distinct, mesure la confiance dans l’intelligence artificielle sur 28 marchés, avec un item unique, une échelle en 9 points et un décompte des quatre modalités hautes, posé à la moitié de son échantillon. Sa valeur agrégée est 49 sur ces 28 marchés, et la planche imprime une échelle de lecture qui borne la défiance de 1 à 49 : la valeur agrégée en occupe la borne haute [5].
Ses valeurs vont de 24 en Irlande à 77 en Inde. La France, la Suède et les États-Unis y valent 32, l’Allemagne et les Pays-Bas 29, le Royaume-Uni 28, l’Australie 25. La Chine est à 72, et le document souligne l’écart de 40 points avec les États-Unis. Il publie aussi une variation par marché d’une vague à l’autre, dont quatre seulement sont signalées comme significatives [5].
Ce que la méthode interprète. Ce baromètre titre que la confiance dans l’IA est plus élevée dans le monde en développement que dans le monde développé. Ce titre va dans le même sens que l’écart mesuré par l’étude, et il ne le corrobore pas pour autant. Le document ne publie ni liste de marchés par groupe, ni moyenne par groupe, ni source de classification : son seul appui chiffré du contraste entre les deux groupes est un couple de pays. Les deux dispositifs ne mesurent pas la même grandeur, ne couvrent pas le même périmètre, 47 pays contre 28 marchés dont 24 communs, et n’interrogent pas la même base [1] [5].
C’est le point où la triangulation échoue, et il vaut d’être dit franchement : deux mesures qui vont dans le même sens ne se confirment pas l’une l’autre tant que l’on n’a pas montré qu’elles mesurent la même chose.
Mes réserves
- Nature des données. Les deux chiffres comparés ici sont déclaratifs. Ils viennent du même questionnaire en ligne auto-administré, et aucun des deux ne mesure un comportement observé. L’écart entre eux est un écart entre deux questions, pas entre une intention et un acte [1].
- Financement. L’étude déclare avoir été soutenue par le partenariat de recherche Chair in Trust entre l’Université de Melbourne et KPMG Australia, et financée par KPMG International, KPMG Australia et l’Université de Melbourne. Elle déclare dans la même page avoir été conduite de façon indépendante par l’équipe universitaire, avec les retours d’un comité consultatif pluridisciplinaire [1].
- Intérêt commercial. Trois dirigeants de KPMG figurent à la fois au comité consultatif de l’étude et parmi les contacts du rapport [1]. Le 7 mai 2025, KPMG International a annoncé une offre de services nommée AI Trust, dont le communiqué de lancement reprend le chiffre de 46 % comme argument de besoin [3]. Ces faits se constatent ; ils n’établissent aucune intention, et rien dans les documents ne permet d’écrire que l’étude aurait été commandée pour préparer ce lancement.
- Dépendance des sources. Le rapport, le communiqué de presse, le communiqué de lancement et la chronique de presse qui les reprend remontent tous à la même enquête, et trois d’entre eux sont édités par KPMG [1] [2] [3] [4]. La chronique de presse n’interroge que deux cadres de KPMG, dont l’un siège au comité consultatif du rapport : elle reproduit fidèlement les deux chiffres, elle ne les vérifie pas [4].
- Échantillons. L’étude déclare que ses échantillons des économies émergentes surreprésentent les personnes diplômées du supérieur par rapport à leur population générale, et qu’il est courant que les répondants en ligne y soient aussi plus urbains, plus jeunes et plus aisés. Elle déclare par ailleurs avoir vérifié que l’écart entre groupes économiques subsiste après contrôle de l’âge et de l’éducation [1].
- Représentativité. Elle porte sur le sexe, l’âge et la répartition régionale, et pas sur l’éducation ni sur le revenu [1].
- Bases de calcul. Les questions sur les bénéfices vécus n’ont été posées qu’aux personnes déclarant une expérience de l’application qui leur avait été attribuée. Cette base descend à 13 % pour l’IA en santé dans les économies avancées [1].
- Ce que je ne peux pas trancher. Les deux décomptes de groupes économiques du rapport ne s’additionnent pas à son effectif de pays, à une unité près : le rapport écrit 29 économies avancées, alors que soustraire ses 17 économies émergentes nommées de son effectif total de 47 pays en donne 30. Je retiens ce second chiffre, déduit du rapport lui-même [1].
Retour au dossier Confiance dans l’IA par région · Lire la Décision possible du dossier.
ISP-IA21/100· 0-30 % · Preuves très limitées · Je range cette page au dernier barreau avant l'argument de conception, et je dois dire pourquoi. Sa preuve centrale est une enquête déclarative transversale, auto-administrée en ligne, dont l'un des financeurs vend du conseil sur l'objet même qu'elle mesure. L'échelle de ce domaine range au barreau 6 une enquête déclarative financée par un acteur qui vend du conseil sur le sujet mesuré, et elle vise nommément les enquêtes auprès de décideurs sur la diffusion d'un usage. Je transpose cette règle à une enquête d'opinion publique portée par le même type de commanditaire, et je dis que c'est une transposition, pas une application littérale. Le plafond de partie prenante, qui interdirait de dépasser le barreau médian, ne mord même pas ici, puisque le classement est déjà en dessous. La convergence est donnée pour mixte, et je dois dire que cet axe ne dispose d'aucun barreau pour l'état réel de ce dossier : il suppose plusieurs études à confronter, et il n'y en a qu'une. Je retiens donc l'avant-dernier cran plutôt que d'affirmer une divergence qui n'existe pas, et je précise ici ce que le mot recouvre. Mes cinq références ne forment que deux blocs, dont quatre remontent à la même enquête et trois sont éditées par son financeur. Le seul producteur réellement distinct est un baromètre dont j'établis, dans le corps de l'article, qu'il ne mesure pas la même grandeur, ne couvre pas le même périmètre et n'interroge pas la même base : il ne constitue donc pas un recoupement, et je refuse de le compter comme tel. La réplication est nulle : aucune équipe indépendante n'a refait cette enquête, et les seules reprises du protocole sont celles de l'équipe elle-même, dont une en 2022 sur 17 pays, en échantillons indépendants de ceux de 2024. La puissance est donnée pour faible malgré 48 340 répondants, et le libellé que cet axe affiche au lecteur, une fourchette de cent à mille observations, entre donc en contradiction apparente avec l'effectif que l'article publie. Je le laisse tel quel et je l'explique ici : le plafond de ce barreau impose cette valeur.
L'Indice de solidité des preuves évalue la base empirique de cette analyse sur quatre critères pondérés : type de preuve (40 %), convergence (30 %), réplication (20 %), puissance (10 %). L'axe type de preuve est calibré par champ : 100 y désigne le meilleur dispositif que l'échelle ISP-IA sache produire, et non une preuve absolue.
Je range cette page au dernier barreau avant l'argument de conception, et je dois dire pourquoi. Sa preuve centrale est une enquête déclarative transversale, auto-administrée en ligne, dont l'un des financeurs vend du conseil sur l'objet même qu'elle mesure. L'échelle de ce domaine range au barreau 6 une enquête déclarative financée par un acteur qui vend du conseil sur le sujet mesuré, et elle vise nommément les enquêtes auprès de décideurs sur la diffusion d'un usage. Je transpose cette règle à une enquête d'opinion publique portée par le même type de commanditaire, et je dis que c'est une transposition, pas une application littérale. Le plafond de partie prenante, qui interdirait de dépasser le barreau médian, ne mord même pas ici, puisque le classement est déjà en dessous. La convergence est donnée pour mixte, et je dois dire que cet axe ne dispose d'aucun barreau pour l'état réel de ce dossier : il suppose plusieurs études à confronter, et il n'y en a qu'une. Je retiens donc l'avant-dernier cran plutôt que d'affirmer une divergence qui n'existe pas, et je précise ici ce que le mot recouvre. Mes cinq références ne forment que deux blocs, dont quatre remontent à la même enquête et trois sont éditées par son financeur. Le seul producteur réellement distinct est un baromètre dont j'établis, dans le corps de l'article, qu'il ne mesure pas la même grandeur, ne couvre pas le même périmètre et n'interroge pas la même base : il ne constitue donc pas un recoupement, et je refuse de le compter comme tel. La réplication est nulle : aucune équipe indépendante n'a refait cette enquête, et les seules reprises du protocole sont celles de l'équipe elle-même, dont une en 2022 sur 17 pays, en échantillons indépendants de ceux de 2024. La puissance est donnée pour faible malgré 48 340 répondants, et le libellé que cet axe affiche au lecteur, une fourchette de cent à mille observations, entre donc en contradiction apparente avec l'effectif que l'article publie. Je le laisse tel quel et je l'explique ici : le plafond de ce barreau impose cette valeur.
- Les bases de calcul des deux agrégats mondiaux, l'effectif de chacun des quatre groupes d'objet et la section du questionnaire dont relève la fiabilité perçue seraient publiés, de sorte que chaque valeur soit retrouvable à sa source plutôt que lue dans le seul rapport.L'équipe de l'Université de Melbourne qui a conçu et conduit l'enquête · existe, mais n’est pas consultable
- Les deux mêmes échelles seraient administrées sur un échantillon distinct par une équipe sans lien de financement avec un vendeur de conseil sur la confiance dans l'IA, de sorte que l'écart entre les deux mesures cesse de reposer sur un producteur unique.Institut statistique public, laboratoire académique financé hors du marché mesuré, ou organisation internationale · un dispositif approchant existe, sans remplir la condition
- Un second producteur mesurerait la même grandeur que l'une des deux échelles, sur le même périmètre et la même base de répondants, de sorte qu'un recoupement devienne possible entre deux sources primaires indépendantes l'une de l'autre.Edelman, ou tout producteur d'un baromètre de confiance dans l'IA · un dispositif approchant existe, sans remplir la condition
Ce dispositif porterait l'indice à 33 sur 100, dans le palier « Preuves limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Score de 21/100 (0-30 %) établi le 3 septembre 2026.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Trust in AI (KPMG/Université de Melbourne)↗
- Étude mondiale conçue par l'Université de Melbourne et publiée avec KPMG en 2025, qui mesure la confiance, les attitudes et l'usage de l'intelligence artificielle auprès de 48 340 répondants dans 47 pays, collecte novembre 2024 à mi-janvier 2025.
Modification apportée · mis à jour le 3 septembre 2026
J'ai repris cet article contre le rapport primaire de 118 pages, que je n'avais pas ouvert en entier lors des versions précédentes. Ce que j'écrivais reposait sur une opposition entre confiance déclarée et confiance réelle : elle ne tient pas, les deux mesures sont déclaratives et viennent du même questionnaire. Le titre, le sous-titre, l'adresse de la page et le fil de l'article portaient cette opposition, et je les ai tous refaits. Trois autres affirmations sont tombées. J'attribuais à l'étude un écart de douze points qu'elle ne calcule ni ne commente nulle part. Je présentais 65 % et 52 % comme la décomposition de cet écart, alors que ce sont les deux composantes de la seule mesure à 58 %. J'écrivais que 58 % se rapproche davantage du chiffre technique que du chiffre éthique, ce qui est faux dans les deux sens : 58 est à 7 points de 65 et à 6 points de 52. Je déclarais aussi ouverte la question de savoir à laquelle des deux mesures se rattache l'écart entre économies avancées et émergentes, en annonçant que je la reprendrais si le détail était publié : le rapport la tranche lui-même, la formule trois sur cinq contre deux sur cinq porte sur la disposition. J'ai retiré ma triangulation par le baromètre Edelman telle qu'elle était écrite. J'ai cette fois lu le rapport Edelman lui-même au lieu d'une reprise de presse, et il ne corrobore pas l'écart régional : il en titre un de même sens sans publier ni classification, ni moyenne par groupe, sur un autre instrument et un autre périmètre. Sa valeur agrégée de 49 n'est pas une confiance mondiale, c'est une moyenne non pondérée de 28 marchés que son éditeur classe lui-même en défiance. Je comptais enfin l'article de Forbes comme une reprise indépendante : ses deux seules sources interrogées sont des cadres de KPMG, dont l'un siège au comité consultatif du rapport, et j'ai corrigé son statut en bibliographie. Dans l'autre sens, j'ai ajouté ce que le rapport porte et que je n'exploitais pas : l'association de .79 entre les deux mesures, l'explication que l'étude donne elle-même de leur écart, son modèle qui place le levier institutionnel en premier prédicteur de la confiance, la décomposition du 54 % en 35 % de non-disposition et 19 % d'ambivalence, les valeurs par application, et les limites que l'étude déclare sur ses propres échantillons. L'indice de solidité des preuves est publié pour la première fois sur cette page, à 20 sur 100. J'ai ajouté deux encadrés de vulgarisation, l'un sur ce qui sépare les deux échelles de l'enquête, l'autre sur le seuil de comptage qui fabrique un pourcentage.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus