L'attention d'un Transformer : 42 Go de cache pour un contexte de 128 000 tokens
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
Le mécanisme qui a rendu les Transformers redoutables sur le texte a un coût qui grossit plus vite que le contexte lui-même : précisément le problème que Mamba a été conçu pour contourner.
- Doubler le contexte multiplie le travail par quatre. Doubler la longueur du contexte ne double pas le nombre de comparaisons, il le multiplie par quatre. Une séquence de 8 tokens produit 64 paires à évaluer plutôt que les 16 d'une séquence de 4 tokens.
- 320 kilo-octets par token, 42 gigaoctets à pleine fenêtre. Chaque token du contexte ajoute 2 × 80 × 8 × 128 × 2 = 327 680 octets au cache, soit 320 kilo-octets par token pour ce modèle. Sur la fenêtre de contexte maximale documentée de Llama 3.1 70B, 128 000 tokens, et en précision FP16 sans quantification, le cache KV d'une seule requête atteint donc environ 42 gigaoctets de mémoire GPU pour ce modèle.
- Sur la majorité des usages, ce coût ne se manifeste pas. Le problème ne se manifeste vraiment qu'à partir de contextes très longs, de l'ordre de dizaines à centaines de milliers de tokens : un rapport financier complet, un corpus juridique, plusieurs heures de transcription. Sur un échange conversationnel ou un document de quelques pages, la charge quadratique reste modeste.
Un Transformer lit un document long token par token, mais ne les traite pas les uns après les autres comme un lecteur humain. Il compare chaque token à tous ceux qui le précèdent, pour décider où porter son attention. Ce mécanisme explique une bonne part de la performance des grands modèles de langage sur le texte. Il explique aussi pourquoi la facture de calcul grimpe vite dès que le document dépasse quelques dizaines de milliers de tokens.
Ce qui existe déjà, et ce que j’ajoute. Le coût quadratique de l’attention est largement expliqué ailleurs, et le calcul du cache KV en gigaoctets pour un grand modèle ouvert circule aussi dans des guides techniques que je ne cite pas nommément ici, sans revue exhaustive de ma part. Ce qui manque le plus souvent à ce calcul, à ma connaissance : un indicateur unique et des seuils explicites pour juger si ce coût pèse réellement sur un déploiement donné, plutôt qu’un chiffre isolé à une seule longueur de contexte. C’est mon apport propre ici : le ratio cache sur poids, calculé à plusieurs longueurs de contexte à partir des spécifications publiées de Llama 3.1 70B, avec des zones de lecture vérifiées sur ce cas et une formule réapplicable à un autre modèle.
Ce que fait le mécanisme d’attention
Ce que les données établissent. Vaswani et al. (2017), dans “Attention Is All You Need”, introduisent l’architecture Transformer : pour chaque token d’une séquence, le modèle calcule un score de compatibilité avec chacun des tokens précédents, puis pondère l’information à retenir en fonction de ces scores. Cette comparaison systématique permet de capter des dépendances à longue distance sans la limite des réseaux récurrents antérieurs, qui faisaient transiter l’information séquentiellement et la perdaient souvent en chemin.
Le problème : un coût qui grossit plus vite que le contexte
Ce que les données établissent. Comparer chaque token à tous les précédents a un coût arithmétique simple : sur une séquence de n tokens, le nombre de paires à évaluer est proportionnel à n². Doubler la longueur du contexte ne double pas le nombre de comparaisons, il le multiplie par quatre. Une séquence de 8 tokens produit 64 paires à évaluer plutôt que les 16 d’une séquence de 4 tokens : à l’échelle d’un document de plusieurs dizaines de milliers de tokens, ce facteur négligeable sur une phrase devient une facture de calcul considérable.
Un second coût s’ajoute, de nature différente. Pour ne pas recalculer l’intégralité de la séquence à chaque nouveau token généré, un Transformer conserve en mémoire les représentations (“clés” et “valeurs”) de tous les tokens déjà traités : c’est le cache KV. Cette mémoire d’inférence croît de façon linéaire avec la longueur du contexte, moins brutal que la croissance quadratique du calcul, mais un coût qui s’accumule sans jamais se stabiliser tant que le contexte s’allonge.

Ce que ça pèse en gigaoctets, sur un cas concret
Ce que les données établissent, calcul original. Le cache KV n’est pas qu’une notion abstraite : sa taille se calcule directement à partir de l’architecture publiée d’un modèle. La formule standard est : 2 (une clé et une valeur) × nombre de couches × nombre de têtes clé-valeur × dimension de chaque tête × taille en octets du format numérique utilisé, pour chaque token du contexte. Meta publie l’architecture exacte de Llama 3.1 70B dans le rapport technique de la famille Llama 3 : 80 couches, 64 têtes d’attention pour une dimension de modèle de 8192 (soit une dimension de 128 par tête), mais seulement 8 têtes clé-valeur distinctes, une optimisation appelée attention par requêtes groupées qui réduit déjà la taille du cache par rapport à une tête clé-valeur par tête de requête.
En appliquant la formule aux spécifications publiées de Llama 3.1 70B, en précision FP16 (2 octets), chaque token du contexte ajoute 2 × 80 × 8 × 128 × 2 = 327 680 octets au cache, soit 320 kilo-octets par token pour ce modèle. Sur la fenêtre de contexte maximale documentée de Llama 3.1 70B, 128 000 tokens, et en précision FP16 sans quantification, le cache KV d’une seule requête atteint donc environ 42 gigaoctets de mémoire GPU pour ce modèle. À titre de comparaison, les poids du modèle lui-même, en FP16, pèsent environ 140 gigaoctets (70 milliards de paramètres × 2 octets). Traiter un seul document proche de la limite de contexte de Llama 3.1 70B mobilise ainsi, pour le seul cache KV de cette requête en FP16, l’équivalent d’environ 30 % de la mémoire nécessaire pour charger ce modèle entier. Ce chiffre ne compte même pas la mémoire d’une deuxième requête simultanée, dont le cache s’ajoute indépendamment au premier.
Ce que la méthode interprète. Ce chiffre donne un ordre de grandeur plausible de ce qui pousse les fournisseurs d’inférence à limiter le nombre de requêtes à contexte long traitées en parallèle sur un même GPU : je n’ai pas vérifié cette pratique auprès d’un fournisseur, c’est une hypothèse explicative, pas une donnée observée. Il éclaire aussi pourquoi une architecture à mémoire constante comme Mamba (section suivante) changerait, en principe, l’équation économique d’un déploiement : sur ce même cas, son cache resterait de taille fixe, indépendant de la longueur du contexte, là où celui d’un Transformer continue de croître tant que le document n’est pas entièrement traité.
Le ratio cache/poids : un indicateur pour trancher avant de changer d’architecture
Ce que les données établissent, calcul original. Un chiffre isolé à 128 000 tokens ne dit rien d’un déploiement qui sert des contextes plus courts. La même formule, appliquée à plusieurs longueurs de contexte pour Llama 3.1 70B, donne un ratio comparable d’un cas à l’autre : le cache KV d’une requête, rapporté aux 140 gigaoctets de poids du modèle en FP16.
| Longueur de contexte | Cache KV (une requête, Llama 3.1 70B, FP16) | Ratio cache/poids |
|---|---|---|
| 4 000 tokens | 1,3 Go | environ 1 % |
| 32 000 tokens | 10,5 Go | environ 7 % |
| 64 000 tokens | 21,0 Go | environ 15 % |
| 128 000 tokens | 41,9 Go | environ 30 % |
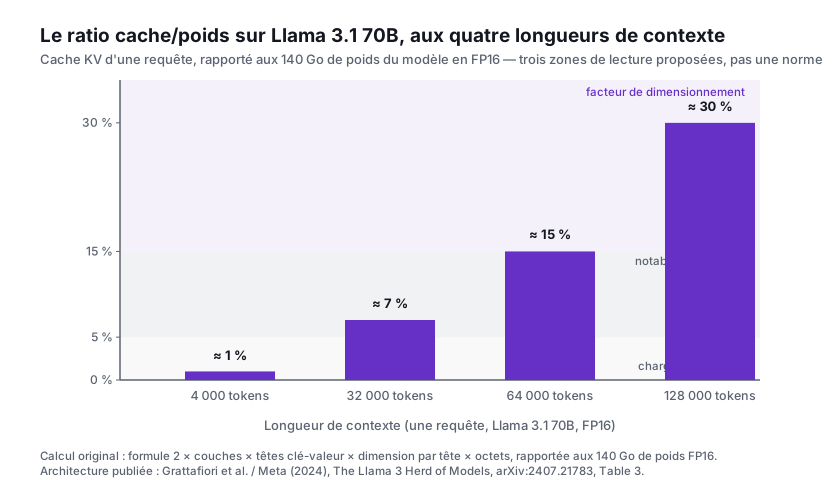
Ce que la méthode interprète. Trois zones de lecture, une proposition de ma part et non une norme du secteur, définies ici sur ce seul cas (Llama 3.1 70B, attention par requêtes groupées à 8 têtes clé-valeur) : en dessous de 5 %, le cache reste une charge négligeable face au modèle lui-même. Entre 5 et 15 %, il devient notable dès que plusieurs requêtes à contexte long tournent en parallèle sur le même GPU. Au-delà de 15 %, chaque requête isolée mobilise à elle seule une fraction du poids du modèle entier : c’est la zone où le cache cesse d’être un détail d’inférence pour devenir un facteur de dimensionnement à part entière. La formule de calcul est transposable à tout modèle dense dont l’architecture est publiée ; les seuils en pourcentage, eux, n’ont été vérifiés que sur ce cas : ils servent à le situer, pas à remplacer un calcul de capacité réel.
Une nuance qui compte : ce n’est pas un problème sur la majorité des usages
Ce que la méthode interprète. Cette mécanique ne rend pas l’attention inefficace en général : elle reste, à ce jour, le standard qui a produit la quasi-totalité des grands modèles de langage en production. Le problème ne se manifeste vraiment qu’à partir de contextes très longs, de l’ordre de dizaines à centaines de milliers de tokens : un rapport financier complet, un corpus juridique, plusieurs heures de transcription. Sur un échange conversationnel ou un document de quelques pages, la charge quadratique reste modeste, et la majorité des usages actuels des LLM se situe dans cette zone où le problème décrit ici reste largement théorique.
Ce que Mamba a été conçu pour changer
Ce que les données établissent. C’est exactement ce goulot d’étranglement, coût de calcul quadratique et mémoire d’inférence qui croît avec le contexte, que Gu et Dao (2023) visent avec Mamba : une architecture à espace d’état sélectif, dont la mémoire reste de taille fixe quelle que soit la longueur du contexte traité, et dont le coût de calcul croît linéairement plutôt que quadratiquement. Le mécanisme précis par lequel Mamba y parvient, et les compromis que ce choix implique, font l’objet d’une fiche dédiée plutôt que d’être détaillés ici.
Le coût de l’attention n’est pas un défaut d’implémentation à corriger : c’est une conséquence directe de ce qui fait sa force : comparer chaque token à tous les précédents. Le problème n’apparaît que lorsque cette liste de “tous les précédents” devient très longue.
Mes réserves
- J’isole ici la charge théorique du mécanisme d’attention lui-même. Des optimisations d’implémentation (fenêtres glissantes, attention parcimonieuse, mise en cache optimisée) atténuent ce coût en pratique sur de nombreux déploiements réels, sans changer la courbe de croissance asymptotique décrite ici, un point que je ne développe pas.
- Le coût quadratique concerne l’attention elle-même ; un Transformer complet inclut aussi des couches de réseau à propagation avant dont le coût croît linéairement avec la longueur du contexte. Le coût quadratique domine à mesure que le contexte s’allonge, mais il ne représente pas la totalité du calcul d’un Transformer sur un contexte court.
- L’exemple “doubler le contexte multiplie le calcul par quatre” est une illustration mathématique du mécanisme d’attention pur, pas une mesure de temps de traitement observée sur un modèle déployé, qui dépend aussi du matériel et de l’implémentation logicielle utilisés.
- Le calcul du cache KV (environ 42 Go à 128 000 tokens pour Llama 3.1 70B) suppose une précision FP16 sans quantification et une seule requête traitée à la fois : un déploiement en production quantifie souvent le cache (INT8, par exemple), ce qui réduit ce chiffre d’un facteur proche de deux, et sert en réalité plusieurs requêtes en parallèle, ce qui le multiplie d’autant. C’est un ordre de grandeur pour une requête isolée en précision de référence, pas un chiffre d’exploitation observé chez un fournisseur donné.
Concrètement, un lecteur qui évalue un déploiement à contexte long peut appliquer la même formule à son propre modèle : 2 × couches × têtes clé-valeur × dimension par tête × octets par token, multiplié par la longueur de contexte visée, puis rapporter le résultat au poids total du modèle pour situer son cas sur les mêmes zones que le tableau ci-dessus. Passé 15 % de ratio cache/poids, deux leviers existent avant de changer d’architecture : réduire la précision du cache (quantification INT8, qui divise ce ratio par environ deux) ou plafonner la longueur de contexte réellement servie en production. Ce compromis coût/contexte ne devient un critère de choix d’architecture (Mamba ou hybride, voir plus haut) que si ces deux leviers restent insuffisants pour un usage à documents longs et récurrents ; sous 5 % de ratio, il reste théorique.
Retour au dossier Comprendre les modèles post-LLM. Voir aussi Qu’est-ce que Mamba ?
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Transformer↗
- Architecture de réseau de neurones fondée sur le mécanisme d'attention, à la base des grands modèles de langage actuels.
- Mécanisme d'attention↗
- Composant permettant à un modèle de pondérer l'importance relative des différentes parties d'une séquence d'entrée.
- Fenêtre de contexte· Context window↗
- Quantité maximale de texte qu'un modèle peut prendre en compte simultanément pour produire une réponse.
Modification apportée · mis à jour le 4 septembre 2026
J'ai corrigé une affirmation de rareté factuellement fausse sur le calcul du cache KV : ce chiffre figure déjà sur plusieurs guides en ligne. À la place du chiffre isolé à 128k tokens, j'ai ajouté l'apport qui manquait vraiment, le ratio cache/poids calculé à quatre longueurs de contexte, avec trois zones de lecture nommées et chiffrées. J'ai ajouté deux encadrés « En clair » : l'un sur la pondération de chaque mot par sa pertinence, l'autre sur le nombre de paires qui enfle plus vite que le texte. J'ai revérifié la source du chiffre de fenêtre de contexte (128 000 tokens) : je l'attribuais au même tableau que les couches et les têtes d'attention, alors qu'il vient d'une autre section du même rapport, une coïncidence avec la taille du vocabulaire qui porte le même nombre. J'ai aussi précisé le modèle et les conditions (Llama 3.1 70B, FP16) directement dans les phrases qui donnent un chiffre, pour qu'elles restent correctes reprises isolément ; corrigé « mots » en « tokens » dans l'introduction ; aligné deux arrondis du même chiffre (« un tiers » et « environ 30 % ») ; et nuancé deux phrases qui présentaient une explication plausible mais non vérifiée comme un fait établi. J'ai ajouté un graphique du ratio cache/poids aux quatre longueurs de contexte du tableau.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus