Le TPU de Google a deux prix, pas un
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
La multimodalité native et la fusion Brain/DeepMind sont connues depuis 2023 et largement documentées ailleurs. Ce qui reste sous-exploré : ce qu'une seule analyse indépendante, non auditée par un tiers, estime pour l'avantage de coût du TPU de Google, et pourquoi une autre mesure indépendante trouve l'inverse sur ce point précis.
- Le coût interne est chiffré à environ 44 % de moins. Une analyse de coût total de possession, publiée fin novembre 2025 par SemiAnalysis, non auditée par un tiers, chiffre à environ 44 % l'écart de coût interne entre une puce Ironwood (TPU v7), pour la configuration complète en tore 3D, et un serveur Nvidia GB200 comparable, pour Google exploitant ses propres puces.
- Un client externe ne paie pas ce prix-là. Pour un contrat de la taille de celui d'Anthropic, un client qui loue ces mêmes TPU sur Google Cloud paie la marge que Google ajoute à la location : l'avantage se réduit alors à environ 30 % moins cher qu'un GB200 comparable, et environ 41 % moins cher qu'un GB300, une puce plus récente et plus chère.
- Une autre mesure indépendante trouve l'inverse. Un autre indicateur indépendant, mesuré sur le débit d'inférence réel en usage interactif, à un débit cible de 30 tokens/s par requête, plutôt que sur le coût total de possession, trouve l'inverse sur cette charge de travail précise : Nvidia y conserverait un avantage d'environ 5x en tokens produits par dollar sur le TPU v6e (Trillium), la génération précédente du TPU v7 analysé plus haut.
Quand deux laboratoires publient chacun un modèle, la comparaison la plus commode consiste à les mettre côte à côte sur un même banc d’essai. Cette lecture rate ce qui compte pour un décideur qui doit choisir un fournisseur : la structure de coût qui porte chaque modèle, génération après génération. Pour Google, trois choix forment le décor, posés entre avril 2023 et mars 2024. Un seul reste sous-documenté, alors qu’il conditionne directement ce que Google peut facturer ou non à ses clients : l’économie réelle du TPU.

Trois choix déjà documentés, en bref
- Une recherche unifiée. En avril 2023, Google fusionne Google Brain et DeepMind sous une même direction, Google DeepMind, unifiant la recherche en IA jusque-là répartie entre les deux entités et lui donnant accès aux ressources de calcul de Google.
- Le multimodal dès l’entraînement. Le rapport technique de Gemini décrit un modèle entraîné conjointement sur texte, image, audio et vidéo dans un même espace de représentation, plutôt qu’un module image ajouté après coup sur un modèle texte.
- Une fenêtre de contexte durablement large. Depuis plusieurs générations, Gemini figure parmi les fenêtres de contexte les plus longues du marché, de plusieurs centaines de milliers de tokens jusqu’à plus d’un million sur certaines versions.
Ces trois points sont couverts ailleurs en détail. Ce qui l’est moins : ce que vaut, en chiffres, l’avantage TPU.
Le TPU a deux prix, pas un
Ce qu’une analyse indépendante estime. Une analyse de coût total de possession, publiée fin novembre 2025 par SemiAnalysis, non auditée par un tiers, chiffre à environ 44 % l’écart de coût interne entre une puce Ironwood (TPU v7), pour la configuration complète en tore 3D, et un serveur Nvidia GB200 comparable, pour Google exploitant ses propres puces. La cause n’est pas que la puce : Nvidia vend des serveurs complets avec une marge élevée sur le calcul et le réseau, tandis que Google achète ses TPU à un fournisseur tiers (Broadcom) à marge plus faible et intègre lui-même cartes, racks et réseau optique. Epoch AI, cabinet de recherche indépendant qui documente séparément le marché des puces IA, confirme le principe comptable retenu : pour une puce personnalisée comme le TPU, le coût retenu est le prix payé au fournisseur (Broadcom), par opposition au prix de vente grand public que facture Nvidia sur ses propres serveurs, sans chiffrer lui-même l’écart de 44 % avancé par SemiAnalysis.
Ce que la méthode interprète. Ce chiffre de 44 % n’est pas celui que paierait un client externe. Pour un contrat de la taille de celui d’Anthropic, un client qui loue ces mêmes TPU sur Google Cloud paie la marge que Google ajoute à la location : l’avantage se réduit alors à environ 30 % moins cher qu’un GB200 comparable, et environ 41 % moins cher qu’un GB300, une puce plus récente et plus chère. Ce chiffre ne vaut pas pour un contrat de taille standard. Le chiffre à retenir dépend donc de qui paie, et à quelle échelle.
Deux mesures indépendantes, deux verdicts
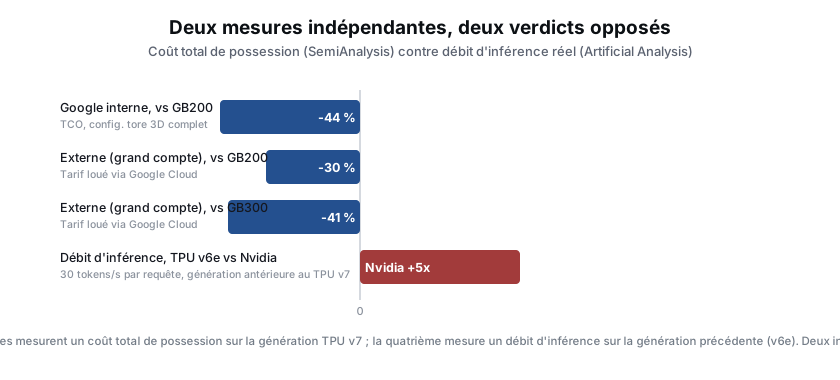
Ce que les données établissent, et où elles se contredisent. Un autre indicateur indépendant, mesuré sur le débit d’inférence réel en usage interactif, à un débit cible de 30 tokens/s par requête, plutôt que sur le coût total de possession, trouve l’inverse sur cette charge de travail précise : Nvidia y conserverait un avantage d’environ 5x en tokens produits par dollar sur le TPU v6e (Trillium), la génération précédente du TPU v7 analysé plus haut.
Ce que la méthode interprète. Les deux mesures ne se contredisent pas nécessairement : SemiAnalysis compare un coût total de possession sur des contrats de grands comptes et la dernière génération de puce, Artificial Analysis compare un débit réel en usage interactif sur une génération antérieure, où le logiciel d’inférence Nvidia (CUDA, TensorRT) est réputé plus mature que la chaîne logicielle TPU pour de nombreuses charges de travail. Cette explication est vérifiable, pas seulement plausible : si elle est juste, l’écart entre les deux mesures devrait se resserrer sur la génération la plus récente (v6e testé par Artificial Analysis n’est pas le v7 chiffré par SemiAnalysis) et sur des contrats de la taille de celui d’Anthropic, où le client absorbe lui-même le travail d’optimisation logicielle. Le contrat du 23 octobre 2025 (jusqu’à un million de TPU pour 2026) est compatible avec ce deuxième scénario, sans l’établir seul : d’autres motifs restent possibles (pénurie de GPU Nvidia, diversification des fournisseurs, relation commerciale plus large entre les deux entreprises). C’est un indice, pas une preuve isolée, que l’avantage du TPU survit au passage à l’échelle réelle.
Le TPU de Google n’a pas un prix, il en a deux : le coût interne que Google paie lui-même, et le tarif de location qu’il facture à ses clients externes, dont Anthropic. Confondre les deux fausse toute comparaison avec Nvidia.
Mes réserves
- L’avantage de coût du TPU provient d’une seule analyse indépendante (SemiAnalysis, novembre 2025), pas d’un audit tiers vérifié ni d’une moyenne de plusieurs cabinets ; elle porte sur les contrats de grands comptes et la génération de puce la plus récente, pas sur l’ensemble du marché de la location de GPU. Une autre mesure indépendante, sur une génération antérieure et un indicateur de débit réel, trouve l’inverse : je réconcilie les deux résultats ci-dessus plutôt que de les masquer sous un chiffre unique.
- L’intégration profonde de Gemini dans des produits existants (Recherche, Workspace, Android) est un atout de distribution que je ne développe pas ici, faute d’apporter un chiffre nouveau sur ce point précis par rapport à ce que documentent déjà d’autres analyses de la trajectoire Google.
Pour un acheteur de calcul IA, la question à poser à Google Cloud n’est donc pas « le TPU est-il moins cher que le GPU ? » mais « moins cher pour qui, sur quelle génération, mesuré par quel indicateur ? ». Concrètement, cela veut dire exiger du commercial Google Cloud une ventilation du TCO par génération de puce et par taille de contrat, plutôt qu’un pourcentage moyen unique. SemiAnalysis avance une estimation de 1,60 $ par puce-heure pour le contrat négocié d’Anthropic sur le TPU v7 (Ironwood), chiffre que nous n’avons pas retrouvé ailleurs ; il reste distinct des pourcentages de TCO (44 %, 30 %, 41 %) cités plus haut du même rapport, sans lien de calcul démontré entre les deux dans la partie que nous avons pu consulter. Un acheteur qui n’a pas la taille de contrat d’Anthropic doit donc obtenir son propre prix par la négociation directe, pas par une grille tarifaire publique.
Retour au dossier « Comprendre les modèles post-LLM ». Voir aussi DeepSeek : la direction choisie et Convergence ou divergence des labs IA ?.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Fenêtre de contexte· Context window↗
- Quantité maximale de texte qu'un modèle peut prendre en compte simultanément pour produire une réponse.
Modification apportée · mis à jour le 15 août 2026
J'ai corrigé les dates, l'URL et la terminologie autour de SemiAnalysis et d'Artificial Analysis, ajouté une source de triangulation indépendante (Epoch AI, citation datée) sur le mécanisme de coût TPU, ajouté un test de falsification explicite à la réconciliation SemiAnalysis/Artificial Analysis, retitré la pièce pour qu'elle annonce fidèlement son sujet réel (l'économie du TPU, pas la direction stratégique de Gemini dans son ensemble), retiré une affirmation sur le rattachement organisationnel de la conception du TPU que mes sources ne permettent pas de trancher, resitué les trois piliers illustrés sur leurs dates réelles (avril 2023 à mars 2024, pas un jalon unique), retiré une clause sur le statut d'investisseur de Google dans Anthropic non établie par ma source, et scopé les chiffres de 30 %/41 % et le contrat Anthropic aux contrats de grands comptes plutôt qu'à tout client externe. J'ai ajouté deux encadrés de vulgarisation qui expliquent en langue courante le mécanisme de deux sections, sans rien changer au corps de l'analyse.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus