Management · 8 juillet 2026 · mis à jour le 15 octobre 2026
Leadership serviteur, transformationnel, ROWE : des preuves pour diriger des experts ?
Servir ses équipes, les inspirer ou ne les juger que sur leurs résultats : trois façons de diriger qui ont leurs défenseurs, mais ont-elles fait leurs preuves auprès d'experts ? Parmi les quinze documents que nous avons réunis, des synthèses statistiques aux pages d'une société de conseil, aucun ne compare empiriquement des dirigeants experts et non experts ; un seul, un modèle théorique calibré sur un cas hospitalier, fait de l'expertise du dirigeant un paramètre du modèle.
Dans les documents que nous avons réunis, les chiffres de productivité du ROWE viennent d'un entretien de magazine et de pages de la société fondée pour le promouvoir, sans source ; les trois études universitaires réunies sur le ROWE portent sur un seul employeur et ne mesurent pas la productivité.
 Axel Morel · Fondateur & analyste, Probans
L'essentiel en 3 points
- Aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts. Un seul, un modèle théorique calibré sur un cas hospitalier, fait de l'expertise du dirigeant un paramètre du modèle [15]. Les quatre méta-analyses, ces synthèses qui agrègent les résultats de nombreuses études, ne donnent aucune estimation séparée pour des experts [1][2][5][12]. Les salariés décrits de plus près travaillent dans la division informatique d'une organisation américaine ou au siège d'une entreprise de distribution, Best Buy [4][9].
- Les styles de leadership reposent sur beaucoup d'études, mais essentiellement sur des corrélations difficiles à séparer. La validité du leadership transformationnel passe de .44, une corrélation, à .24, un coefficient de régression, une fois les autres dimensions du leadership prises en compte, dont la récompense contingente (échanger des récompenses contre des résultats), avec laquelle il est corrélé à .80 [2]. Dans deux méta-analyses [2][12], le lien du transformationnel est plus fort quand le style et le résultat viennent de la même source (.55 contre .28 [2]) ; [1] ne trouve pas d'écart selon que la performance est auto-évaluée ou évaluée par un tiers (sept échantillons) ; [5], qui n'a retenu que des performances non auto-déclarées, ne trouve pas d'écart entre mesure objective et notation par un superviseur pour la performance de tâche et la performance d'équipe. Le seul essai tiré au sort du dossier sur un style porte sur une formation de cadets [13].
- Les trois études universitaires du ROWE portent sur un seul employeur, Best Buy, et aucune des études réunies ici ne mesure sa productivité. Dans les documents réunis, les 41 % puis 35 % de productivité en plus viennent d'un entretien de magazine et de pages de la société de ses conceptrices, sans source [6][7][8]. Les études universitaires mesurent d'autres résultats [3][4][9][10], dont le départ des salariés [3] : 6,1 % dans le groupe ROWE contre 11,1 % dans le groupe de comparaison, en huit mois, sans tirage au sort [3] ; STAR, tirée au sort, ne le mesure pas [4].
Quand on dirige des gens qui connaissent leur métier mieux que soi, que vaut-il mieux faire : les servir, les inspirer, ou ne regarder que leurs résultats ? Trois méthodes portent chacune une réponse. Le leadership serviteur donne la priorité aux besoins de chaque collaborateur [1]. Le leadership transformationnel élargit les objectifs des suiveurs et leur donne confiance pour aller au-delà de ce qui était convenu [13]. Le ROWE, pour Results-Only Work Environment (« environnement de travail fondé uniquement sur les résultats »), juge le travail sur ses résultats et non sur le temps passé ou la présence [3][9].
Nous avons voulu vérifier ce que les preuves publiées permettent vraiment d’en dire, parce qu’un dirigeant qui adopte l’une de ces méthodes engage son équipe sur la foi de ces preuves. Deux d’entre elles ont des défenseurs déclarés. CultureRx, la société fondée par les deux conceptrices du ROWE [6], présente la méthode comme « éprouvée » [7]. Les auteurs de ce qu’ils présentent comme la plus grande méta-analyse sur le leadership serviteur, c’est-à-dire une synthèse qui agrège les résultats de nombreuses études, recommandent aux organisations de former leurs dirigeants à ce style [1].
La réponse courte
Aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts [1] à [15] ; un seul, un modèle théorique calibré sur un cas hospitalier, fait de l’expertise du dirigeant un paramètre du modèle [15]. Les liens que les méta-analyses établissent entre style de leadership et performance sont des corrélations, c’est-à-dire des liens statistiques [1][2][5][12]. Le seul essai tiré au sort du dossier sur un style, où le hasard répartit des escouades entre deux formations, porte sur des cadets de l’armée israélienne [13]. Pour le ROWE, dans les documents réunis, les chiffres de productivité viennent d’un entretien de magazine et de pages de la société de ses conceptrices, sans source [6][7][8], et aucune des études universitaires du dossier sur le ROWE ou sur STAR, une initiative voisine, ne mesure la productivité [3][4][9][10].
Où sont les experts ?
Notre dossier réunit quinze documents : quatre méta-analyses [1][2][5][12] ; une comparaison de douze questionnaires de leadership [11] ; une expérience tirée au sort dans l’armée [13] ; trois articles universitaires sur le ROWE, menés au siège de Best Buy, une entreprise de distribution [3][9][10], et une étude sur STAR, une initiative voisine testée dans une autre entreprise [4] ; deux pages de CultureRx et un entretien du magazine TIME avec les conceptrices du ROWE [6][7][8] ; une revue de synthèse sur le financement des recherches sur les médicaments et les dispositifs médicaux [14] ; enfin un modèle théorique, accompagné d’une simulation, sur les équipes dirigées par des experts [15].
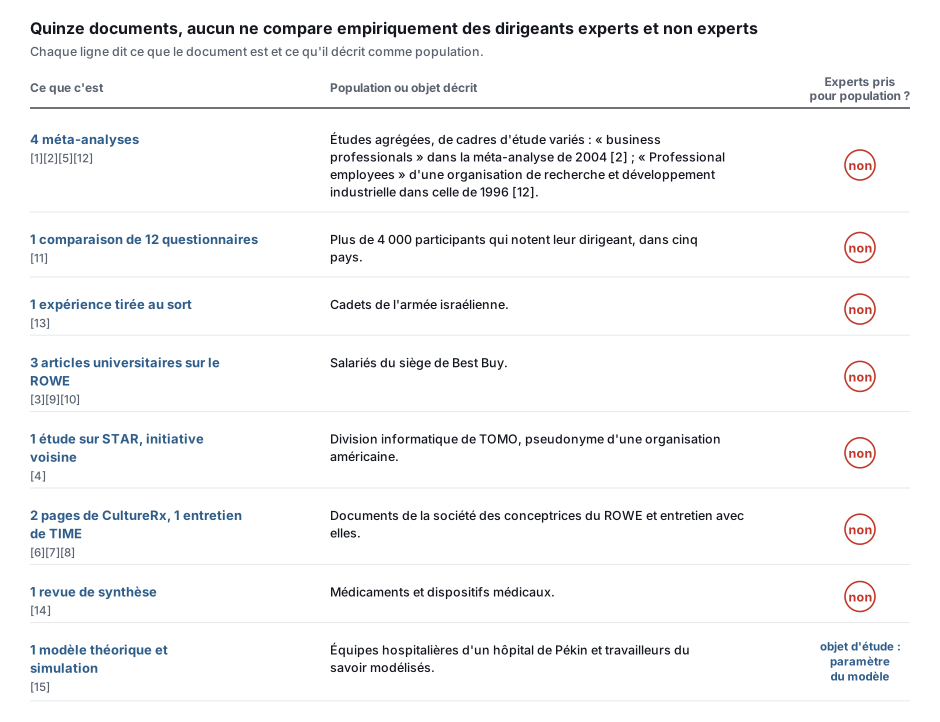
Schéma 1. Les quinze documents du dossier, par nature, et la population ou l’objet que chacun décrit. « Experts pris pour population » signifie ici que le document sélectionne ou code ses participants selon leur expertise ; [15], dont l’étude n’implique pas de participants humains, fait de l’expertise du dirigeant un paramètre de son modèle. Sources : [1] à [15].
Qui sont alors les salariés observés ? À TOMO, pseudonyme d’une organisation américaine, la division informatique réunit des développeurs, des testeurs, des chefs de projet et du personnel administratif [4]. Au siège de Best Buy, les répondants sont des employés de bureau : 86 % ont un diplôme du supérieur et l’âge moyen est de 32 ans [9]. Les méta-analyses mêlent des cadres d’étude : des « business professionals » (des professionnels de l’entreprise) dans celle de 2004 [2], des évaluateurs décrits comme « Professional employees » (des salariés professionnels) d’une organisation de recherche et développement industrielle dans celle de 1996 [12].
Un seul document du dossier fait de l’expertise du dirigeant son objet d’étude : un article de 2024 paru dans Humanities and Social Sciences Communications, qui définit les dirigeants experts comme des managers dotés à la fois de connaissances spécialisées du cœur de métier et de compétences de gestion [15]. Ce n’est pas une étude empirique du leadership, mais un jeu évolutionnaire simulé, sans participants humains, dont les valeurs initiales viennent des équipes d’experts du service d’ophtalmologie de l’hôpital Tongren de Pékin, l’expertise y étant codée par des titres et des distinctions [15]. L’avantage de l’équipe dirigée par un expert y est une propriété du modèle, et non un effet mesuré : le modèle pose notamment par hypothèse qu’un travailleur de haute capacité produit le double d’un travailleur de basse capacité [15]. Le cas hospitalier qui le calibre compare, de façon descriptive et sans test statistique, des membres et des non-membres d’équipes dirigées par des experts [15]. Ses auteurs renvoient à la recherche future la comparaison entre des équipes dirigées par des experts du domaine et des équipes dirigées par des non-experts aux meilleures compétences de direction [15].
Servir d’abord, pour quel résultat ?
Le leadership serviteur repose sur une prémisse : en aidant d’abord les collaborateurs à réaliser leurs ambitions, on atteint ensuite les objectifs de long terme de l’organisation. Définir et mesurer ce style ne fait pas consensus dans la littérature [1].
La plus vaste synthèse sur le sujet, de l’aveu de ses auteurs, rassemble 130 échantillons indépendants tirés de 124 publications, où les collaborateurs notent leur dirigeant. Chaque lien y est résumé par un chiffre, la corrélation corrigée, notée ρ [1]. Le principe, tel que la méta-analyse de 2004 le décrit : on corrige chaque corrélation de l’imprécision des mesures, puis on moyenne en pondérant par la taille des échantillons [2].
Dans cette synthèse, le leadership serviteur est associé positivement à six résultats : la performance individuelle, celle que prescrit la fiche de poste ; la créativité ; la prise de parole, c’est-à-dire les recommandations et les préoccupations que les salariés expriment d’eux-mêmes ; la citoyenneté, ces comportements volontaires qui dépassent le rôle prescrit ; la performance d’équipe ; la citoyenneté d’équipe. Il l’est négativement aux comportements contre-productifs. Pour quatre de ces résultats, la fourchette du lien d’une étude à l’autre, que les statisticiens appellent l’intervalle de crédibilité à 95 %, touche zéro ou le franchit [1].
| Résultat | Lien moyen (ρ) | Fourchette d’une étude à l’autre |
|---|---|---|
| Performance individuelle | .25 | de 0,00 à 0,50 |
| Prise de parole | .25 | de −0,02 à 0,52 |
| Créativité | .40 | de −0,04 à 0,83 |
| Comportements contre-productifs | −.27 | de −0,74 à 0,21 |
Tableau 1. Quatre résultats dont l’intervalle de crédibilité à 95 % touche ou franchit zéro. Source : [1].
Les tests de contexte donnent peu. Le lien avec la performance d’équipe est plus fort dans les cultures à forte distance hiérarchique et collectivistes, et le lien avec la performance individuelle et les comportements contre-productifs croît avec l’ancienneté des salariés, à l’inverse de ce qu’attendaient les auteurs [1].
Serviteur ou transformationnel ?
Le leadership serviteur est-il vraiment un style à part ? Il est corrélé à .52 avec le leadership transformationnel, à .84 avec le leadership authentique et à .82 avec le leadership éthique, deux autres approches. Les auteurs écrivent que ces fortes corrélations confirment la possibilité d’une redondance empirique, et, plus loin dans le même paragraphe, après un « However », défendent la valeur propre du concept par sa validité prédictive relative, c’est-à-dire sa capacité à prédire un résultat au-delà des trois autres styles, sur tous les résultats sauf les comportements contre-productifs [1].
Les deux analyses qui suivent sont menées à partir de corrélations venant en partie d’autres méta-analyses [1]. Quand on ajoute le leadership serviteur aux autres styles disponibles dans le calcul (les trois autres styles, mais seulement le transformationnel et l’éthique pour la citoyenneté d’équipe), la part de variance expliquée, c’est-à-dire la part des écarts de résultat que les styles permettent d’expliquer, passe de 14 % à 24 % pour la performance individuelle et de 24 % à 37 % pour la citoyenneté d’équipe ; elle ne change pas pour les comportements contre-productifs. Mais dans l’analyse des poids relatifs, qui évalue la contribution de chaque style au résultat, le transformationnel pèse plus que le serviteur pour la performance individuelle (30,79 contre 27,72) et pour la prise de parole (38,81 contre 20,94) [1].
Une étude de 2025 pose la question autrement : les douze questionnaires de styles de leadership, dont ceux du serviteur et du transformationnel, mesurent-ils des choses distinctes ? Les douze partagent une large part de ce qu’ils mesurent et ne captent pas de manière systématique ce qui serait propre à chaque style [11].
Le facteur général, c’est-à-dire la variance commune à tous les styles, est lié à 42 des 49 relations covariable-échantillon testées, une même variable pouvant être mesurée dans plusieurs échantillons. Les facteurs spécifiques, ce qui reste propre à chaque questionnaire une fois cette part commune retirée, ne le sont que dans 18,75 % des relations, 108 sur 576. La part propre du leadership serviteur l’est dans 11 de ces 49 relations, celle du transformationnel dans 10, surtout dans une seule des quatre études [11].
Le transformationnel : un lien qui fond ?
Pour saisir le transformationnel, il faut son voisin, le transactionnel. Le dirigeant transactionnel influence en fixant des objectifs, en clarifiant les résultats attendus, en donnant du retour et en échangeant des récompenses contre les réalisations ; la récompense contingente est cette forme d’échange [2][13]. Le dirigeant transformationnel exerce une influence supplémentaire, par quatre dimensions : le charisme, un comportement admirable qui pousse les collaborateurs à s’identifier au dirigeant ; la motivation inspirante, une vision attrayante ; la stimulation intellectuelle, qui remet en cause les présupposés et sollicite les idées ; la considération individualisée, l’attention aux besoins de chacun, en mentor ou en coach. Le laissez-faire, lui, est l’évitement ou l’absence de leadership [2].
La méta-analyse de Judge et Piccolo, parue en 2004, agrège 626 corrélations issues de 87 sources : 68 articles, 18 thèses et un jeu de données non publié. La corrélation corrigée d’ensemble du leadership transformationnel avec les critères retenus est de .44, avec une fourchette d’une étude à l’autre de .10 à .78 ; celle de la récompense contingente est de .39. Le transformationnel est plus fortement lié à la satisfaction envers le dirigeant (.71) qu’à la performance du dirigeant (.27). La récompense contingente a un coefficient plus élevé que lui sur trois critères sur six ; les auteurs jugent l’écart d’ensemble, .39 contre .44, relativement faible : les deux styles sont valides, et la supériorité de l’un ou de l’autre semble dépendre du contexte [2].
Surtout, les deux styles se séparent mal dans les données : le transformationnel et la récompense contingente sont corrélés à .80, un niveau que les auteurs jugent aussi élevé que celui de deux mesures du même concept. Quand on contrôle les styles les uns par les autres, c’est-à-dire quand on regarde ce qui reste de chacun une fois les autres pris en compte, la validité du transformationnel passe de .44 (corrélation) à .24 (coefficient de régression standardisé, les quatre autres dimensions du modèle contrôlées). Sur les mêmes bases, celle de la récompense contingente passe de .39 à .11 et celle du laissez-faire de −.37 à −.09. Les auteurs concluent que les deux styles sont si liés qu’il est difficile de séparer leurs effets propres [2].
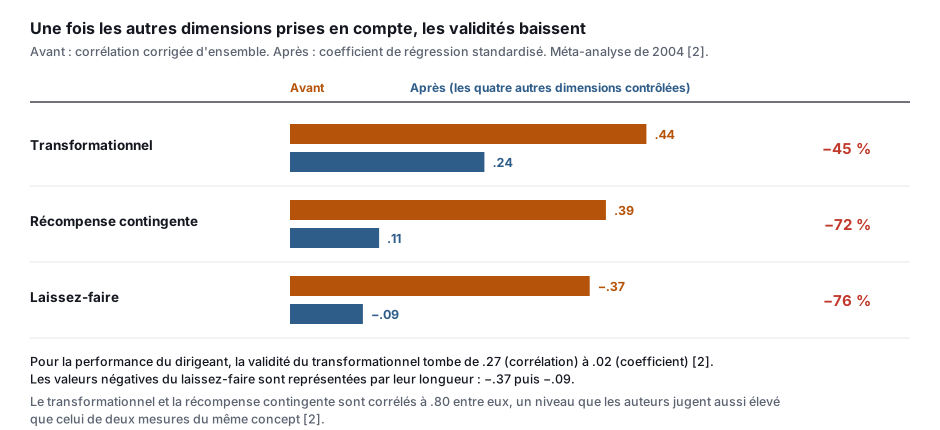
Schéma 2. La validité d’ensemble de trois styles : avant, la corrélation corrigée ; après, le coefficient de régression standardisé, les quatre autres dimensions du modèle prises en compte. Le transformationnel garde .24 : sa validité baisse sans disparaître. Source : [2].
Qui note quoi ?
La méta-analyse de 1996 ne porte que sur le MLQ (Multifactor Leadership Questionnaire), un questionnaire que Bass a développé [12]. Quand le subordonné note à la fois le style de son dirigeant et l’efficacité de ce dirigeant, au même moment, ces mesures sont critiquées pour un « biais de méthode commune » [12]. Et les chiffres bougent selon qui mesure quoi.
Dans la méta-analyse de 2004, la corrélation corrigée du transformationnel est de .55 quand le style et le résultat viennent de la même source, et de .28 quand les sources diffèrent ; elle est de .50 dans les études transversales et de .27 dans les études suivies dans le temps, où le résultat est mesuré après le leadership. La récompense contingente chute davantage (.54 contre .15 selon la source ; .49 contre .13 selon le devis), et seule la corrélation du transformationnel se généralise aux études suivies dans le temps et à sources distinctes [2].
La méta-analyse de 1996 agrège 39 études où le MLQ est rempli par les subordonnés. Quand l’efficacité est notée par ces mêmes subordonnés, les trois échelles transformationnelles atteignent de .68 à .81, et la récompense contingente .56. Quand elle est mesurée par l’organisation, avec des mesures « dures » comme le profit ou les objectifs atteints et des évaluations de la hiérarchie, ces chiffres tombent de .26 à .35, et à .08. Les trois échelles transformationnelles restent positives dans les deux cas. Ses auteurs attribuent l’écart en partie à un biais de méthode unique qui gonfle les corrélations, situent la relation « vraie » entre les deux valeurs, et voient dans le recours à un seul instrument la plus grande limite de leur étude [12].
La méta-analyse de 2004 rapporte d’ailleurs que celle de 1996 trouvait une corrélation composite de .73 pour les dimensions transformationnelles, contre .44 pour la sienne, et attribue probablement l’écart à des études plus rigoureuses, avec davantage de corrélations où style et résultat viennent de sources distinctes [2]. Ce .73 n’est pas imprimé tel quel dans la version de 1996 que nous avons lue [12].
L’étude de 2025 sur les douze questionnaires soulève un autre problème de mesure. Dans l’une de ses quatre études, menée aux États-Unis, le facteur général des questionnaires est corrélé à .85 avec la qualité de la relation entre dirigeant et collaborateur, dite LMX (leader-member exchange) ; dans une autre, menée en Chine, il l’est à .81 avec l’affect du collaborateur envers son dirigeant. Selon les auteurs, la variance commune correspond surtout à la qualité affective de la relation ; cette lecture repose sur deux échantillons, des déclarations de collaborateurs et un devis en partie transversal. Ils précisent que cela ne veut pas dire que le leadership se réduit à l’affect, et jugent que les questionnaires seuls ne devraient pas servir à mesurer les styles [11].
Pour le leadership serviteur, toujours noté par les collaborateurs, la corrélation avec la performance individuelle ne diffère pas significativement selon que le résultat est auto-évalué ou évalué par un tiers, sur sept échantillons [1]. La méta-analyse de 2011, qui écarte d’emblée les performances auto-déclarées, ne trouve pas de différence significative entre une performance de tâche ou d’équipe mesurée objectivement et subjectivement [5].
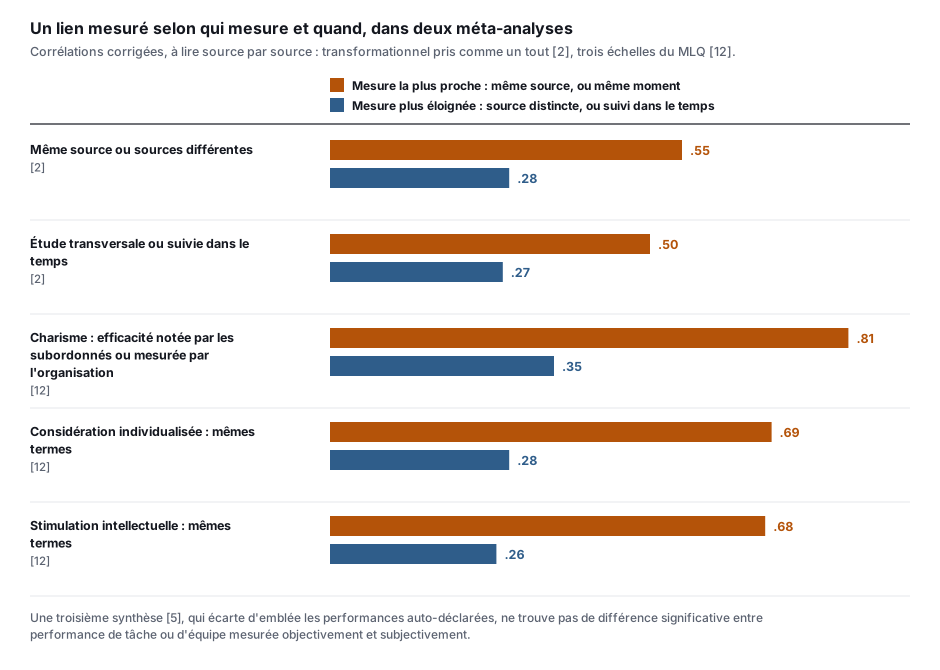
Schéma 3. Le lien du transformationnel avec un résultat, selon la façon de le mesurer. Les deux premières paires viennent de [2], qui porte sur le transformationnel pris comme un tout et sur l’ensemble de ses critères ; les trois suivantes de [12], qui porte sur trois échelles du questionnaire et sur l’efficacité du dirigeant. Les écarts se lisent source par source : ils ne s’additionnent pas ni ne se moyennent.
L’équipe plutôt que l’individu ?
La méta-analyse de 2011, signée Wang et ses coauteurs, regroupe 117 échantillons issus de 113 études de terrain, sans manipulation expérimentale du leadership et sans performances auto-déclarées. Les corrélations corrigées du transformationnel sont de .25 avec la performance individuelle, de .33 avec la performance d’équipe et de .27 avec celle de l’organisation, dont la fourchette à 80 % (de −.04 à .59) inclut zéro. Contrairement à l’attente des auteurs, il n’apporte rien au-delà de la récompense contingente pour prédire la performance de tâche individuelle, c’est-à-dire les comportements que prescrit la fiche de poste ; c’est la récompense contingente qui apporte une part en plus. En revanche, il apporte une part en plus pour la performance contextuelle, ces comportements volontaires qui dépassent le rôle prescrit et nourrissent le contexte social du travail, et pour la performance d’équipe [5].
Côté leadership serviteur, la corrélation avec la performance d’équipe est de .33 sur 11 échantillons [1], la même valeur que celle du transformationnel, .33 sur 34 échantillons [5]. Ce second chiffre est celui de la méta-analyse de 2011, repris tel quel dans le tableau de la synthèse sur le leadership serviteur [1][5].
Et le niveau du dirigeant ? Trois méta-analyses examinent si la relation entre le leadership transformationnel, ou la récompense contingente, et les résultats varie selon que le dirigeant est un encadrant de proximité ou un cadre de niveau intermédiaire ou supérieur [2][5][12]. Deux méta-analyses testent la différence et ne la trouvent pas [2][12] ; la troisième conclut à l’absence de modération par chevauchement d’intervalles, sans test [5]. Les corrélations du transformationnel sont de .48 contre .37 dans celle de 2004 et de .26 contre .19 dans celle de 2011 [2][5]. La synthèse sur le leadership serviteur ne teste pas le niveau hiérarchique [1].
Que prouve l’expérience des cadets ?
Une seule expérience tirée au sort du dossier porte sur un style de leadership. Dans l’armée israélienne, douze escouades de cadets ont été tirées au sort : sept ont reçu une formation de trois jours au leadership transformationnel, cinq une formation « éclectique » de même durée. Devenus chefs de section, 54 d’entre eux ont été suivis avec leurs 90 subordonnés directs et 724 recrues, tous des hommes de 18 à 22 ans [13].
Les sections des chefs formés ont fait mieux dans tous les domaines de performance des recrues : l’effet est significatif sur l’ensemble des cinq mesures prises ensemble, significatif séparément pour deux d’entre elles, proche du seuil pour une troisième, non significatif pour les deux autres. Chez les subordonnés directs, l’effet de la formation sur le développement tient en partie à un déclin évité : l’approche critique et indépendante et l’effort supplémentaire baissent chez les témoins, sans changement significatif dans le groupe formé. Chez les recrues, la formation n’a pas d’effet significatif sur le développement [13].
Un doute pèse pourtant sur ces résultats : seul le groupe formé a reçu une séance de rappel, faute de budget pour les témoins, ce qui laisse ouvert un effet Hawthorne, c’est-à-dire l’effet de l’attention reçue, ou du simple fait de participer à une étude, sur les réponses, les attitudes et la performance [13][10]. Les auteurs ne peuvent exclure que cette séance explique une part des effets [13].
ROWE : d’où viennent les chiffres ?
Le ROWE est né en interne au siège de Best Buy, où les salariés peuvent changer quand et où ils travaillent sans demander la permission d’un responsable, ni même le prévenir. Le déploiement passe par quatre séances collectives et une séance pour les managers, environ six heures au total. Cali Ressler et Jody Thompson, les deux salariées de Best Buy qui l’ont conçu, ont ensuite fondé CultureRx pour le promouvoir [6][9].
Trois documents donnent des chiffres. Dans un entretien du 30 mai 2008 avec les deux conceptrices, TIME avance que Best Buy a vu la productivité « s’envoler » de 41 % entre 2005 et 2007 dans les équipes ROWE, que la rotation volontaire du personnel, c’est-à-dire les départs choisis par les salariés, a chuté de 90 %, faisant économiser à l’entreprise quelque 16 millions de dollars par an [6]. Une page de CultureRx, non datée et archivée en 2012, attache à Best Buy une baisse de la rotation volontaire « allant jusqu’à » 90 %, une hausse « moyenne » de 41 % de la productivité, et une économie de 2,2 millions de dollars sur deux ans pour une seule équipe, non nommée [8]. Sur la page actuelle de la société, les équipes ROWE « rapportent » une hausse moyenne de productivité de 35 % et une baisse de 90 % de la rotation volontaire, sans que Best Buy soit nommé ; le ROWE y est présenté comme une méthode « éprouvée » [7].
| Document | Productivité | Rotation volontaire |
|---|---|---|
| TIME, 30 mai 2008 [6] | +41 % entre 2005 et 2007, équipes ROWE de Best Buy | −90 % |
| CultureRx, page archivée en 2012 [8] | +41 % en moyenne, équipes ROWE | jusqu’à −90 % |
| CultureRx, page actuelle [7] | +35 % en moyenne, rapportée par les équipes ROWE | −90 % |
Tableau 2. Les trois formulations du chiffre de productivité, deux sur les pages de la société des conceptrices du ROWE, une dans le chapô d’un entretien de magazine, sans source, et la rotation volontaire qui les accompagne. Sources : [6][7][8].
Ce que les chercheurs ont mesuré
Trois articles universitaires étudient le ROWE au siège de Best Buy ; ils sont tirés, selon toute apparence, d’une même collecte de 2006 (mêmes taux de réponse, et 659 répondants aux deux vagues pour [9] et [10], dont 608 retenus dans [9]) [3][9][10]. Leur méthode est une « expérience naturelle » : elle exploite un changement qui aurait eu lieu de toute façon, ici le déploiement progressif du ROWE. Les départements qui ont démarré pendant la période d’étude (les tout premiers étaient exclus [3]) forment le groupe traité, ceux qui attendent encore le groupe de comparaison, sans tirage au sort [9][10].
Le premier suit 775 salariés du siège pendant huit mois : 6,1 % des participants au ROWE ont quitté Best Buy, contre 11,1 % du groupe de comparaison. Toutes choses égales par ailleurs dans le modèle, le passage au ROWE est associé à un rythme de départ inférieur de 45,5 % (rapport de risque de .545) [3].
Le deuxième interroge 608 salariés avant, puis environ six mois après l’arrivée du ROWE. Le passage au ROWE y est associé à un contrôle des horaires plus élevé, c’est-à-dire le sentiment de pouvoir décider du moment, du nombre d’heures et du lieu de son travail, et à un conflit travail-famille déclaré plus faible [9].
Le troisième interroge 659 salariés sur leurs comportements de santé : le ROWE prédit environ 28 minutes de sommeil en plus avant un jour travaillé dans le premier modèle, et aucun effet direct sur les mesures de bien-être ; en tenant compte du passage par le contrôle des horaires et le débordement, l’effet total estimé sur le sommeil est d’environ 52 minutes [10]. Le groupe ROWE dormait toutefois environ 33 minutes de moins au départ [10].
STAR (« Support. Transform. Achieve. Results. »), conçue par des chercheurs avec des consultants extérieurs, associe une formation des encadrants au soutien de la vie personnelle des salariés à des séances participatives, pour donner aux salariés plus de maîtrise de leur temps de travail et les concentrer sur les résultats plutôt que sur la présence. Ses auteurs la disent « assez semblable » au ROWE [4]. Elle a été évaluée par un essai randomisé par groupes : on tire au sort des unités de travail entières, et non des individus, les autres continuant « comme d’habitude » [4].
Dans la division informatique de TOMO (694 salariés, 56 groupes), STAR améliore le contrôle des horaires (taille d’effet de 0,342) et le soutien perçu du supérieur à la vie personnelle (0,160) ; les améliorations du conflit travail-famille et du temps pour la famille sont « modestes », et celle du conflit du travail vers la famille, 0,122, n’est que marginalement significative (p = .059). La taille d’effet rapporte l’effet de STAR à l’écart-type du résultat au départ, c’est-à-dire à la dispersion habituelle des réponses. Rien n’indique une hausse des heures ou des exigences du travail, et le rachat de l’entreprise a été annoncé pendant l’étude [4].
Best Buy a-t-il gardé le ROWE ?
Les articles de 2011 notent que Best Buy a poursuivi le ROWE à son siège, et qu’une personne des ressources humaines y est chargée de continuer à le déployer et à le suivre [3][10]. Puis, selon les auteurs de l’essai STAR, qui citent la presse, un nouveau dirigeant de Best Buy a déclaré le ROWE terminé au printemps 2013 [4]. Les auteurs de STAR notent que ce type d’initiative peut être annulé quand la direction change ou réévalue ses coûts et ses bénéfices, comme toute politique que la loi n’impose pas. Ils jugent aussi que l’étude du ROWE chez Best Buy a trouvé des effets positifs sans tirage au sort, et qu’une évaluation randomisée d’une initiative semblable pourrait ne trouver aucun changement dans une autre organisation [4].
Les conceptrices disent avoir mis au point le ROWE pour l’environnement de bureau [6]. Les chercheurs bornent leurs résultats aux salariés de bureau : dans ces emplois, la maîtrise de l’horaire, du volume d’heures et du lieu vont ensemble, ce qui n’est pas forcément le cas dans les emplois au contact direct des clients [4] ; on ignore comment le ROWE fonctionnerait en magasin ou à l’hôpital [10].
Qui finance, qui mesure ?
Qui paie une recherche influence-t-il ce qu’elle conclut ? Une revue Cochrane sur les recherches sur des médicaments et des dispositifs médicaux trouve que les études financées par le fabricant rapportent plus souvent des résultats favorables que les autres, avec une preuve de qualité modérée à faible [14].
Qui a financé les études du dossier ? Les trois articles sur le ROWE ont été menés dans le cadre du Work, Family and Health Network (réseau « travail, famille et santé »), financé par un accord de coopération passé par quatre organismes américains de santé et de recherche, avec un soutien complémentaire de la fondation Alfred P. Sloan [3][9][10]. La conclusion de l’article sur les départs cite l’effort de cette fondation pour promouvoir des politiques qui donnent aux salariés plus de maîtrise de leur temps de travail [3]. Dans l’étude sur les horaires, l’invitation à l’enquête ne mentionnait pas le ROWE [9].
Les autres documents déclarent ceci :
| Document | Soutien ou lien déclaré |
|---|---|
| Étude sur STAR [4] | Conçue par des chercheurs avec des consultants extérieurs ; les remerciements citent CultureRx pour sa collaboration à l’intervention |
| Méta-analyse de 2011 [5] | Aucun financement reçu et aucun conflit d’intérêts, selon ses auteurs |
| Comparaison de douze questionnaires [11] | Aucun conflit d’intérêts connu ; deux auteurs ont publié sur le leadership serviteur |
| Expérience sur les cadets [13] | Fonds et faculté de management de l’université de Tel Aviv ; une chaire pour D. Eden |
| Entretien de TIME et pages de CultureRx [6][7][8] | CultureRx, société fondée par les conceptrices, est propriétaire des marques ROWE |
Tableau 3. Soutien financier ou lien déclaré, document par document. Sources : [4][5][11][13][6][7][8], dans l’ordre des lignes.
Un résultat, mais lequel ?
Les chercheurs décrivent le ROWE comme une réorientation des salariés et des managers vers des résultats mesurables ; dans la troisième séance, les salariés clarifient les résultats dont ils ont la charge [3][9][10]. CultureRx promet d’apprendre à fixer des attentes mesurables, fondées sur les résultats [7]. Du côté des méta-analyses de leadership, « résultat » recouvre des mesures très différentes : dans celle de 2011, la performance de tâche est mesurée objectivement dans 7 études sur 30, celle d’équipe dans 15 sur 34, celle de l’organisation dans toutes [5].
Posture plutôt que recette ?
Les auteurs de la comparaison de douze questionnaires écrivent que le « bon » leadership prend des formes variées aux résultats positifs semblables, plus proches entre elles que beaucoup de consultants ne le font croire. Ils ajoutent que les organisations gagneront davantage à renforcer les comportements existants de leurs dirigeants, alignés sur leurs valeurs et leur mission, qu’à adopter le dernier style à la mode, et que prioriser la relation avec les collaborateurs peut être un levier puissant [11].
Trois approches, quatre questions
Quatre questions suffisent à comparer les trois approches : sont-elles étudiées sur des experts, éprouvées par un essai tiré au sort, reliées par la mesure à la performance, et d’où viennent les chiffres cités ?
| Question | Leadership serviteur | Leadership transformationnel | ROWE |
|---|---|---|---|
| Experts pris pour population ? | Non [1] | Non [2][5][12][13] | Non [3][9][10] |
| Un essai tiré au sort dans le dossier ? | Aucun [1] | Oui : une formation de cadets [13] | Aucun ; STAR, initiative voisine, en est un [3][4][9][10] |
| Un lien mesuré avec la performance ? | Oui, par corrélation [1] | Oui, par corrélation [2][5][12] | Non : aucune des quatre études ne la mesure [3][4][9][10] |
| D’où viennent les chiffres cités ? | Une méta-analyse de 130 échantillons [1] | Des méta-analyses, dont une de 87 sources [2][5] | La société de ses conceptrices et un magazine, sans source [6][7][8] |
Tableau 4. Les trois approches face à quatre questions. Un « aucun » à l’essai tiré au sort signifie qu’aucun essai de ce type ne figure parmi les quinze documents. Sources : [1] à [15].
Application par profil de décision
Avant d’adopter l’une de ces trois méthodes pour des experts, demandez-vous ce que ses preuves portent réellement : aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts [1] à [15] ; un seul, un modèle théorique calibré sur un cas hospitalier, fait de l’expertise du dirigeant un paramètre du modèle [15]. Selon votre place, la lecture change :
| Profil | Ce que cette analyse implique | Enjeu | Réversibilité |
|---|---|---|---|
| Manager de proximité d’une petite équipe d’experts | Lire ces résultats comme des pistes : aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts [1] à [15] ; un seul, un modèle théorique calibré sur un cas hospitalier, fait de l’expertise du dirigeant un paramètre du modèle [15]. Deux méta-analyses testent et ne trouvent pas de modération par le niveau du dirigeant [2][12] ; une troisième l’écarte par chevauchement d’intervalles [5]. Ces synthèses se recoupent peut-être. Les auteurs de la comparaison de douze questionnaires conseillent de renforcer les comportements existants alignés sur les valeurs et de prioriser la relation avec les collaborateurs [11]. | Modéré | Réversible |
| Encadrement de plusieurs équipes expertes | Le lien du transformationnel avec la performance d’équipe est de .33 sur 34 échantillons [5], celui du serviteur de .33 sur 11 échantillons [1] : deux corrélations numériquement égales, mais tirées de corpus aux critères de mesure différents, qui ne prouvent pas une équivalence. La synthèse sur le serviteur les compare dans son analyse de poids relatifs, à partir de corrélations venant en partie d’autres méta-analyses, et non sur un même échantillon [1]. Les auteurs de la méta-analyse sur 113 études jugent que le transformationnel apporte le plus dans le travail d’équipe et la collaboration, un style transactionnel pouvant être préférable quand le travail implique peu d’interdépendance ; cette implication n’est pas testée [5]. | Élevé | Partiellement réversible |
| Dirigeant qui définit la politique managériale | Demander qui a produit un chiffre et comment : dans les documents du dossier, les 41 %, 35 % et 90 % du ROWE viennent d’un entretien de magazine et de pages de la société de ses conceptrices, sans source [6][7][8], et aucune étude universitaire du dossier sur le ROWE ou sur STAR ne mesure la productivité [3][4][9][10]. La seule mesure universitaire du départ, sur huit mois et sans tirage au sort, donne 6,1 % contre 11,1 % [3]. Selon les auteurs de l’essai STAR, qui citent la presse, un nouveau dirigeant de Best Buy a déclaré le ROWE terminé au printemps 2013 [4]. Pour un style, le seul essai tiré au sort est une formation chez des cadets [13]. | Critique | Partiellement réversible |
Tableau 5. Lecture par profil. Sources : [1] à [15].
Mes réserves
- Aucune comparaison empirique des dirigeants selon leur expertise. Aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts [1] à [15] ; un seul, un modèle théorique calibré sur un cas hospitalier, fait de l’expertise du dirigeant un paramètre du modèle [15], et la transposition à votre cas reste une hypothèse.
- Un constat borné à ce dossier. Ce constat ne vaut que pour les quinze documents réunis ici : la recherche sur les dirigeants experts existe au-delà, et l’article de 2024 cite d’autres travaux sur le sujet, que nous n’avons pas lus [15].
- Des liens, pas des causes. Les méta-analyses reposent sur des corrélations, et les auteurs de deux d’entre elles le disent [1][5].
- Un seul employeur dans les études du ROWE. Trois articles tirés, selon toute apparence, d’une même collecte de 2006, des groupes non tirés au sort, six à huit mois de suivi, un échantillon jeune, diplômé et du Midwest américain [3][9][10].
- Des chiffres sans source. Les 41 %, 35 % et 90 % sont ceux de leurs auteurs, sans méthode ni source publiée [6][7][8]. Pour la rotation, la seule mesure universitaire du départ, un rythme inférieur de 45,5 %, donne selon notre calcul un ordre de grandeur environ deux fois moindre que les 90 %, sans comparabilité stricte [3].
- Des méta-analyses qui se recoupent peut-être. Les trois méta-analyses qui s’accordent sur le niveau du dirigeant agrègent peut-être en partie les mêmes études, et je ne sais pas dans quelle mesure [2][5][12]. L’une d’elles ne mène aucune analyse du biais de publication [2].
- Des intervalles non comparables. Les intervalles de crédibilité et de confiance sont fixés à des niveaux différents selon les sources (80 %, 90 % ou 95 %) : je ne les compare pas d’une méta-analyse à l’autre [1][2][5][12].
- Des lectures partielles. Pour le leadership serviteur, j’ai lu le manuscrit accepté, pas la version publiée [1]. Pour la méta-analyse de 2011, j’ai lu une extraction du texte, le site d’origine bloquant le téléchargement [5].
- Un lien avec CultureRx. L’essai STAR, cosigné par E. L. Kelly et P. Moen, remercie CultureRx pour sa collaboration à l’intervention [4], et ces deux chercheurs signent aussi les trois articles sur le ROWE [3][9][10] ; l’article sur la santé nomme CultureRx sans préciser de lien [10], et nous n’en avons pas relevé d’autre dans les documents lus.
Indice de solidité des preuves · le détail
40 / 100 · Preuves limitées · fourchette 31-55 %
Score établi le 15 octobre 2026. Une révision ultérieure est une réévaluation datée, pas une correction masquée.
Pourquoi ce score. Deux méta-analyses trouvent un lien plus fort quand la même source note le style et le résultat. Une troisième trouve, pour la performance individuelle, un lien plus fort quand les deux sont mesurés au même moment : ce résultat porte sur le moment de la mesure, pas sur la source de notation. Sur la comparaison des styles, les résultats changent selon le critère : la récompense contingente a un coefficient plus élevé que le transformationnel sur trois critères sur six dans une méta-analyse, et c'est elle seule qui apporte une part en plus pour la performance de tâche individuelle dans une autre, où le transformationnel en apporte une pour la performance d'équipe. Ces synthèses se recoupent peut-être : les trois méta-analyses qui s'accordent sur le niveau du dirigeant agrègent peut-être en partie les mêmes études, dans une mesure que nous ne connaissons pas. Pour le ROWE, les trois articles universitaires reposent sur un même terrain et sont tirés, selon toute apparence, d'une même collecte de 2006 (mêmes taux de réponse, et 659 répondants aux deux vagues pour deux d'entre eux, dont 608 retenus dans l'un) ; dans les documents réunis, les chiffres de productivité ne viennent que d'un entretien de magazine et de pages de la société de ses conceptrices, sans source.
- Une assignation aléatoire d'équipes ou de sites à l'une des trois approches comparées ici, documentée y compris en grappes, dans une organisation civile en activité.Une équipe académique conduisant un essai avec un employeur partenaire · un dispositif approchant existe, sans remplir la condition
- Un résultat central lu sur un registre plutôt que sur un score de questionnaire : départs enregistrés, promotions, production, absences.La même équipe, à partir de la paie et du registre du personnel de l'organisation d'accueil · un dispositif approchant existe, sans remplir la condition
- Un dispositif qui compare ces approches sur un même résultat d'entreprise, de sorte que l'affirmation centrale repose sur l'essai et non sur la littérature déclarative.Une équipe académique sans lien avec les sociétés qui commercialisent ces protocoles · personne ne l’a produit
Ce dispositif porterait l'indice à 54 sur 100, dans le palier « Preuves limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Modification apportée · mis à jour le 15 octobre 2026
- Pièce reconstruite sur les textes sources des quatorze documents, relus en entier, puis remise en forme selon la charte éditoriale du 2026-10-09 : titre, chapô, intertitres, encadrés de statut, trois schémas.
- Population étudiée : la version précédente écrivait qu'aucune méta-analyse ne code de catégorie « experts » ou « professions qualifiées ». Deux d'entre elles incluent pourtant des études auprès de « business professionals » ou de « Professional employees » ; le texte dit maintenant qu'aucune ne donne d'estimation séparée pour des experts.
- Expérience sur des cadets : l'effet de la formation sur le développement des subordonnés directs était décrit comme une progression. Il tient en partie à un déclin évité chez les témoins, et le texte le dit.
Voir les 48 autres
- STAR : la comparaison entre ses effets est remplacée par les valeurs publiées, car l'effet sur le soutien du supérieur n'est pas plus fort que ceux sur le conflit travail-famille.
- Les relevés de sources ont été refaits ; le tableau par profil garde ses trois profils.
- Chiffres de productivité du ROWE : la présentation, la réponse courte et les tableaux 2, 4 et 5 disaient qu'ils venaient de ses promoteurs. Le 41 % donné par TIME figure dans le chapô de l'article, sans source ni attribution ; seules les deux pages de CultureRx viennent de la société des conceptrices. Le texte le dit maintenant partout.
- Productivité : la réponse courte écrivait qu'aucune étude universitaire du dossier ne la mesure, alors que la méta-analyse de 2011 agrège des indicateurs de productivité d'organisations. La phrase porte maintenant sur les études du ROWE et de STAR.
- Contrôle des styles les uns par les autres : .24, .11 et −.09 étaient présentés comme des corrélations. Ce sont des coefficients de régression standardisés, obtenus en contrôlant les quatre autres dimensions du modèle, et non « les deux autres » styles. Le texte, le résumé et le schéma 2 le disent.
- Leadership serviteur : pour la citoyenneté d'équipe, le calcul n'ajoute le serviteur qu'au transformationnel et à l'éthique, pas aux trois autres styles.
- Comparaison des douze questionnaires : les « 49 variables » sont 49 relations covariable-échantillon. Les corrélations de .85 et .81 viennent de deux études distinctes, l'une aux États-Unis, l'autre en Chine.
- Méta-analyse de 2004 : elle attribue « probablement » l'écart avec celle de 1996 à des études plus rigoureuses, elle ne « l'explique » pas ; le .73 qu'elle rapporte n'est pas imprimé tel quel dans la version de 1996 lue.
- Mesure : la méta-analyse de 2004 n'attribuait pas l'écart de .55 contre .28 à la variance de source commune, et l'étude de 2025 ne compare pas source commune et source distincte. L'encadré dit ce que chaque source écrit vraiment.
- STAR : l'effet sur le conflit du travail vers la famille n'est que marginalement significatif (p = .059).
- Financement : les organismes cités pour les trois articles sur le ROWE sont maintenant ceux que ces articles déclarent eux-mêmes, et non ceux de l'étude sur STAR. Pour deux méta-analyses, l'absence de déclaration de financement est bornée à ce que nous avons relevé.
- Corrections plus courtes : la ligne de la méta-analyse de 2011 reprise dans celle sur le serviteur compte six valeurs, et non cinq ; la définition de l'effet Hawthorne et la séance de rappel ont chacune leur source ; le schéma 1 dit qu'aucun des documents ne prend des experts pour population ; le schéma 3 précise que ses deux méta-analyses n'ont pas les mêmes critères.
- Sous-titre : il écrivait qu'aucun des quatorze documents ne dit si ses participants sont des experts. Deux méta-analyses décrivent pourtant leurs cadres d'étude comme des « business professionals » ou des « Professional employees ». Le sous-titre dit maintenant, comme le corps, qu'aucun ne prend des experts pour population, et la description du schéma 1 aussi.
- Description et résumé : ils écrivaient que les styles de leadership reposent sur des liens statistiques, sans réserve, alors que le dossier contient un essai tiré au sort sur une formation au leadership transformationnel. Ils disent maintenant que ces liens reposent essentiellement sur des corrélations, et le résumé nomme l'essai sur des cadets.
- Gestion par exception : le texte la décrivait comme le fait de corriger « après coup ». Cela ne vaut que pour sa forme passive ; dans sa forme active, le dirigeant agit avant que le problème n'éclate. « Après coup » est retiré.
- Récompense contingente : les deux paires de corrélations étaient données dans l'ordre inverse de celles du transformationnel. Elles sont maintenant attribuées : .54 contre .15 selon la source de notation, .49 contre .13 selon le devis.
- ROWE : le texte écrivait que le ROWE « réduit » le rythme de départ, « augmente » le contrôle des horaires et « réduit » le conflit travail-famille. Ces études ne tirent pas les groupes au sort, et le groupe ROWE différait du groupe de comparaison avant le dispositif. Le texte dit maintenant que le passage au ROWE est associé à ces résultats.
- Tableau 4 : la ligne « D'où viennent les chiffres de gain ? » mettait en parallèle des corrélations, pour les deux styles, et des gains annoncés, pour le ROWE. Elle devient « D'où viennent les chiffres cités ? ».
- Indice : la note de convergence dit maintenant que les trois méta-analyses qui s'accordent sur le niveau du dirigeant agrègent peut-être en partie les mêmes études.
- Résumé, source de notation : il écrivait que le lien est plus fort quand la même personne note le style et le résultat, sans réserve. C'est vrai pour le transformationnel dans deux méta-analyses. La synthèse sur le serviteur ne trouve pas d'écart selon que la performance est auto-évaluée ou évaluée par un tiers ; celle de 2011, qui n'a retenu que des performances non auto-déclarées, compare mesure objective et notation par un superviseur, et ne teste donc pas la source commune. Le résumé dit maintenant ce que chacune compare.
- Serviteur et transformationnel sur la performance d'équipe : le texte et le tableau par profil écrivaient qu'aucune source ne compare directement les deux styles. La synthèse sur le serviteur les compare dans son analyse de poids relatifs, à partir de corrélations venant en partie d'autres méta-analyses. Le texte le dit, avec les poids qu'elle publie.
- Indice : la réplication était cotée « une fois ». Aucun document du dossier ne montre un résultat répliqué de façon indépendante : les trois articles sur le ROWE et l'essai STAR viennent du même réseau de recherche, et les méta-analyses agrègent peut-être en partie les mêmes études. La réplication est maintenant cotée « aucune », et l'indice baisse d'autant.
- Redondance du serviteur : ses auteurs ne défendent pas la valeur propre du concept dans la même phrase que celle qui évoque la redondance, mais plus loin dans le même paragraphe, après un « However ».
- Recommandation de formation : elle était présentée comme fondée sur une validité prédictive « supérieure aux autres approches ». La synthèse établit une validité incrémentale sur les trois autres styles, et le transformationnel pèse plus que le serviteur pour la performance individuelle et la prise de parole.
- Questionnaire : le texte écrivait que ces styles se mesurent avec le MLQ. Seule la méta-analyse de 1996 se limite à ce questionnaire ; d'autres sources du dossier emploient aussi d'autres questionnaires.
- Étude de 2025 : elle était présentée comme allant « dans le même sens » que l'écart selon la source de notation. Elle ne teste pas cet écart ; elle soulève un autre problème de mesure.
- CultureRx : la fondation de la société par les conceptrices est maintenant aussi attribuée à l'entretien de TIME, qui la nomme.
- ROWE, groupe traité : il était décrit comme les départements passés en premier. Ce sont ceux qui ont démarré pendant la période d'étude ; les tout premiers étaient exclus.
- Financement : l'absence de déclaration relevée ne porte plus que sur deux méta-analyses, faute d'avoir vérifié ce point dans celle de 2004.
- Sommeil : le texte donnait « près d'une heure (52,3 minutes) » comme l'effet du ROWE dans le modèle complet. Ce chiffre additionne l'effet direct et l'effet qui passe par le contrôle des horaires et le débordement ; ce n'est pas un coefficient du modèle. Le texte parle maintenant d'un effet total estimé d'environ 52 minutes, et rappelle que le groupe ROWE dormait environ 33 minutes de moins au départ.
- Productivité du ROWE : le texte écrivait qu'elle n'a « été que racontée ». Les documents réunis ici ne disent rien d'éventuelles mesures internes ; le texte dit maintenant que, dans ces documents, la productivité n'apparaît que dans des chiffres sans méthode.
- Réserve sur les chiffres sans source : elle écrivait que les études universitaires ne confirment ni n'infirment les 41 %, 35 % et 90 %. C'est exact pour la productivité, pas pour la rotation : l'étude sur les départs publie une mesure dont l'ordre de grandeur est environ deux fois moindre, sans comparabilité stricte. La réserve sépare maintenant les deux.
- Étude de 2025 : le texte écrivait que noter son dirigeant sur divers styles « capte surtout l'affect » envers lui. C'est une lecture des auteurs, appuyée sur des corrélations ; le texte le dit, et précise sur quoi elle repose.
- Leadership transformationnel : sa définition parlait d'élargir les objectifs « de l'équipe ». La source parle des objectifs des suiveurs.
- Chiffres et études du ROWE : le sous-titre, la description et la réponse courte parlaient des chiffres de productivité du ROWE et des études universitaires qui lui sont consacrées, sans borne. Nous ne pouvons parler que des quatorze documents réunis ; ces surfaces le disent maintenant, et précisent que les chiffres figurent dans un entretien de magazine et sur des pages de la société des conceptrices.
- Experts : le sous-titre et la légende du schéma 1 disent maintenant ce que signifie « prendre des experts pour population » : sélectionner ou coder les participants selon leur expertise.
- Une même enquête : le texte, une réserve et la note de convergence disaient que les trois articles sur le ROWE reposent sur une même enquête de 2006. Deux d'entre eux partagent bien 659 répondants, mais l'identité de leur collecte avec celle de l'article sur les départs n'est écrite nulle part, et l'un des trois n'imprime pas l'année. Ils en sont tirés selon toute apparence, d'après leurs taux de réponse identiques.
- Fin du ROWE à Best Buy : l'annonce de 2013 était présentée comme établie par l'essai STAR. Ses auteurs la rapportent d'après la presse, et le texte le dit, dans le corps et dans le tableau par profil.
- Financement par l'industrie : les fréquences de résultats favorables pour 1 000 études sont des valeurs calculées à partir du risque relatif, non des décomptes, et la preuve est de qualité modérée à faible. Le texte le précise.
- Tableau par profil : les deux corrélations de .33 étaient dites identiques sans réserve. Elles sont numériquement égales, mais viennent de corpus aux critères de mesure différents, et ne prouvent pas une équivalence.
- Départs des salariés, dans le résumé : le 6,1 % contre 11,1 % et la mention « sans tirage au sort » étaient rattachés aux quatre études universitaires. Ils ne viennent que de l'étude sur les départs, et STAR, tirée au sort, ne mesure pas le départ. Le résumé le dit, et précise lequel des deux chiffres est celui du groupe ROWE.
- Leadership serviteur, variance expliquée et poids relatifs : la synthèse mène ces deux analyses à partir de corrélations venant en partie d'autres méta-analyses. Le texte ne le disait que plus bas ; il le dit maintenant à l'endroit des chiffres.
- Étude de 2025 : le texte prêtait aux auteurs une réserve qu'ils n'écrivent pas, en disant qu'ils ne démontrent pas leur lecture affective. Le texte dit maintenant sur quoi repose cette lecture : deux échantillons (une corrélation avec la LMX dans l'un, avec l'affect dans l'autre), des déclarations de collaborateurs et un devis en partie transversal.
- Schéma 3 : son titre opposait seulement la même personne et une autre, alors qu'une des paires oppose une mesure au même moment et une mesure suivie dans le temps. Il dit maintenant « selon qui mesure et quand ».
- Lien avec CultureRx : la réserve disait que nous ne savions pas si les auteurs des études sur le ROWE avaient un lien avec la société. L'essai STAR la remercie pour sa collaboration, et deux de ses auteurs signent aussi les trois articles sur le ROWE. La réserve le dit maintenant.
- Allègement : le passage sur la revue Cochrane et l'inventaire des financeurs sont réduits, la baisse de validité du transformationnel n'est plus donnée en pourcentage mais par ses deux valeurs, .44 puis .24, et plusieurs répétitions entre le corps, les encadrés et les réserves sont retirées. Aucune affirmation ni aucun chiffre n'ont été ajoutés.
- Un quinzième document entre au dossier : un modèle théorique de 2024, accompagné d'une simulation, sur les équipes dirigées par des experts, calibré sur un cas hospitalier. La formule selon laquelle aucun document ne prend des experts pour population, ni ne sélectionne ou ne code ses participants selon leur expertise, ne valait que pour les quatorze premiers : ce document porte sur des équipes dirigées par des experts. Le sous-titre, la description, le résumé, la réponse courte, le schéma 1, les tableaux 4 et 5 et les réserves disent maintenant qu'aucun des quinze documents ne compare empiriquement des dirigeants experts et non experts, et qu'un seul fait de l'expertise du dirigeant un paramètre de son modèle. Un court passage décrit ce document, et la note sur les colonnes « Enjeu » et « Réversibilité » ne porte plus d'affirmation d'absence sur l'ensemble des documents.
- Niveau du dirigeant : le texte et le tableau par profil écrivaient que, dans trois méta-analyses, le niveau du dirigeant ne modifie pas significativement le lien du transformationnel avec les résultats. Deux d'entre elles, celles de 2004 et de 1996, testent la différence et ne la trouvent pas ; celle de 2011 ne la teste pas et conclut à l'absence de modération parce que les intervalles de confiance se chevauchent largement. Le texte le dit maintenant, et le tableau par profil rappelle que ces synthèses se recoupent peut-être. Même collecte du ROWE : les 659 répondants sont ceux qui ont répondu aux deux vagues ; l'article sur les horaires en retient 608, et le texte comme la note de convergence le précisent.
Axel Morel · Fondateur & analyste, Probans
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plusNewsletter Probans
Recevoir les prochaines analyses
Choix par catégorie · Sans spam · Désabonnement en 1 clic