Jusqu'où JEPA planifie-t-il avant que l'erreur ne s'accumule ?
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
Le papier V-JEPA 2 ne chiffre pas l'horizon au-delà duquel l'erreur devient prohibitive ; il n'exécute qu'une action avant de replanifier, et découpe sa tâche de dépose d'objet (pick-and-place : saisir, déplacer, déposer) en trois sous-objectifs, poursuivis 4, 10 puis 4 pas de temps. C'est une architecture non générative, qui prédit des représentations plutôt que des pixels ; avant d'y engager un cas d'usage, l'horizon de planification que le modèle tient sans réamorcer est un critère à vérifier, à lire comme une grille d'analyse plutôt que comme un standard établi par les auteurs de JEPA.
- Le modèle devine une représentation, pas des pixels. Un premier bloc, l'encodeur, transforme ce qui est observé, une image ou une séquence vidéo, en une représentation abstraite qu'on appelle un embedding. Un second bloc, le prédicteur, essaie ensuite de deviner, dans ce même espace abstrait, l'embedding d'une partie masquée de l'observation (une autre région de l'image), ou, pour le modèle d'action V-JEPA 2-AC, de l'état suivant, sans jamais chercher à en reconstituer les pixels exacts.
- 62 heures de données robot, 65 % de réussite sur une tasse. Après ce pré-entraînement massif sur de la vidéo générale, moins de 62 heures de données robot ont suffi pour la phase de contrôle. Le papier rapporte un taux de réussite moyen de 65 % pour la saisie d'une tasse (70 % et 60 % selon le laboratoire), contre seulement 25 % pour une boîte.
- Une seule action exécutée avant de replanifier. Dans le papier, la dépose d'objet (pick-and-place) est décomposée en trois sous-objectifs, poursuivis 4, 10 puis 4 pas de temps. Le système n'exécute qu'une action avant de replanifier (contrôle à horizon glissant) ; le dossier ne dit pas sur combien de pas il anticipe à chaque planification.
JEPA n’est ni un chatbot, ni un générateur d’images. C’est un cadre de conception de modèles qui part d’un pari différent de celui des grands modèles de langage (LLM) : plutôt que de générer du texte ou des images, un modèle devrait apprendre à prédire une représentation abstraite de ce qu’il n’observe pas. En 2023, une équipe de Meta, dont Yann LeCun, a présenté I-JEPA, une approche non générative qui prédit des représentations plutôt que des pixels. AMI Labs, cofondé par Yann LeCun après son départ de Meta, a depuis levé plus d’un milliard de dollars pour construire des « world models », sans que les sources de cette fiche établissent la part de JEPA dans ce projet ; cette levée et la course aux world models sont traitées dans une autre fiche de ce dossier, « La course aux world models : qui lève quoi ». Cette fiche-ci répond à une question plus étroite et plus opérationnelle : jusqu’où, concrètement, le modèle sait-il planifier avant que l’erreur ne s’accumule ?
Ce que JEPA change par rapport à un LLM
Ce que le rapport écrit. JEPA (Joint Embedding Predictive Architecture, ou « architecture prédictive à embarquement conjoint »), que les auteurs d’I-JEPA présentent comme une approche non générative (non-generative approach), fait autre chose : un premier bloc, l’encodeur, transforme ce qui est observé, une image ou une séquence vidéo, en une représentation abstraite qu’on appelle un embedding. Un second bloc, le prédicteur, essaie ensuite de deviner, dans ce même espace abstrait, l’embedding d’une partie masquée de l’observation (pour I-JEPA, « les représentations de différents blocs cibles dans la même image »), ou, pour le modèle d’action V-JEPA 2-AC, de l’état suivant, sans jamais chercher à en reconstituer les pixels exacts.
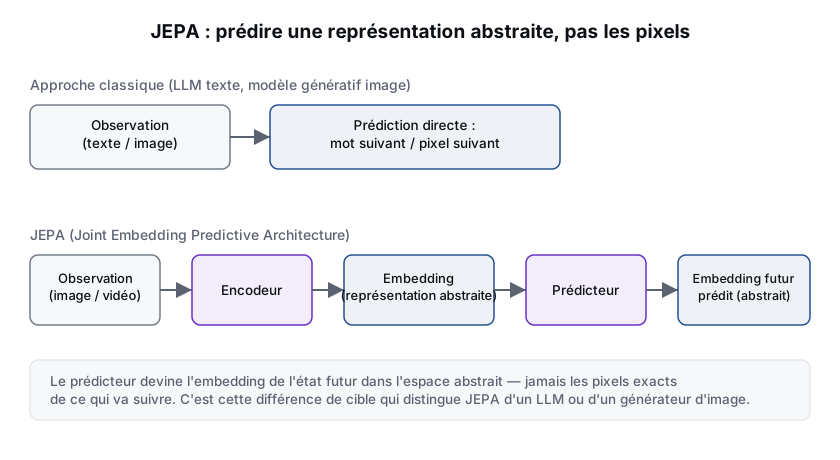
I-JEPA, V-JEPA 2 : ce qui a été publié
Ce que le rapport écrit. I-JEPA (2023) applique l’idée aux images fixes ; V-JEPA 2 (2025) l’applique à la vidéo. V-JEPA 2 est publié par l’équipe Meta FAIR à laquelle appartenait alors Yann LeCun, avant que celui-ci ne quitte Meta pour fonder AMI Labs. L’encodeur de V-JEPA 2 compte jusqu’à 1 milliard de paramètres, entraîné sur plus d’un million d’heures de vidéo. Le résultat le plus concret mis en avant par les auteurs porte sur la robotique : après ce pré-entraînement massif sur de la vidéo générale, moins de 62 heures de données robot ont suffi pour la phase de contrôle. Le modèle qui en résulte, V-JEPA 2-AC, permet à un bras robotisé de planifier la saisie d’un objet nouveau, dans un environnement absent des 62 heures de données robot utilisées pour la phase de contrôle, en anticipant dans l’espace latent ce que différents mouvements produiraient plutôt qu’en générant une image de chaque scénario possible ; le papier rapporte un taux de réussite moyen de 65 % pour la saisie d’une tasse (70 % et 60 % selon le laboratoire), contre seulement 25 % pour une boîte. L’analyse de fond du dossier détaille ces chiffres poste par poste, y compris le gain d’entraînement de 8,4x revendiqué par les auteurs : « Après les LLM : ce que TRM, Mamba et JEPA prouvent vraiment ».
Jusqu’où le modèle planifie-t-il vraiment ?
Ce que le rapport écrit. Le papier V-JEPA 2 lui-même signale, parmi ses limites, un point que la démonstration de robotique, prise seule, ne montre pas : la prédiction autorégressive souffre d’une accumulation d’erreur, et la précision des prédictions dans l’espace latent se dégrade à mesure que l’horizon de rollout s’allonge. Les auteurs ajoutent qu’un horizon de planification plus long fait croître l’espace de recherche de façon exponentielle, pour une hausse seulement linéaire de l’horizon. Ils ne chiffrent pas l’horizon au-delà duquel cette dégradation devient prohibitive. Le système ne planifie pas une longue séquence d’un bloc : il exécute une seule action, puis réamorce entièrement sa planification avant la suivante, une méthode que les auteurs eux-mêmes nomment le contrôle à horizon glissant (receding horizon control).
Ce que les données établissent. Dans le papier, la tâche de dépose d’objet (pick-and-place : saisir, déplacer, déposer) est découpée en trois sous-objectifs, poursuivis 4, 10 puis 4 pas de temps avant de passer au suivant, pour des taux de réussite moyens de 80 % sur la tasse et 65 % sur la boîte.
Ce que la méthode interprète. Les auteurs signalent eux-mêmes que l’erreur s’accumule avec l’horizon ; le papier ne démontre pas de planification longue sans replanification intermédiaire. Il replanifie à chaque pas, ce qui revient à demander au modèle une nouvelle prédiction avant chaque geste plutôt qu’un plan d’ensemble qu’il exécuterait tel quel. Ce n’est pas un détail d’implémentation isolé : au moins un article de suivi (FF-JEPA, arXiv:2606.09311) s’attaque spécifiquement à ce problème d’horizon dans les world models à embedding, ce qui suggère qu’il ne s’agit pas d’une lecture isolée de ma part, sans qu’une seule référence permette de parler d’un courant de recherche constitué ou d’un verrou reconnu par le champ. La saisie de deux objets nouveaux a été montrée dans deux laboratoires absents des données robot : 65 % en moyenne pour une tasse, 25 % pour une boîte, sur dix essais par laboratoire ; une tâche qui enchaînerait plusieurs gestes indépendants sans réamorçage intermédiaire, comme assembler deux pièces, reste un horizon que le papier ne démontre pas.
La matrice horizon-réamorçage : situer un cas d’usage plutôt que juger l’architecture en bloc
Ce que la méthode interprète. La limite documentée plus haut se lit à travers deux variables, pas une seule : la longueur de l’horizon que la tâche exige, et la fréquence à laquelle le modèle reçoit une observation fraîche pour recaler sa prédiction (le réamorçage). Croiser ces deux axes donne une grille de lecture, construite à partir de ce seul cas et qui n’a pas été éprouvée : la matrice horizon-réamorçage.
| Réamorçage fréquent | Réamorçage rare | |
|---|---|---|
| Horizon court (tâche décomposable en quelques pas) | Zone confort (hypothèse de lecture) : le cas démontré par V-JEPA 2 s’y range ou relève de la zone à instrumenter selon l’échelle retenue (voir ci-dessous) | Zone tolérée (hypothèse de lecture) : dérive supposée limitée par la brièveté de l’horizon |
| Horizon long (trajectoire continue, non découpée) | Zone à instrumenter (hypothèse de lecture) : découper la tâche en sous-objectifs réamorcés | Zone à risque (hypothèse de lecture) : aucun réamorçage n’y recale l’accumulation d’erreur documentée par les auteurs |
Ce que le rapport écrit. Les auteurs ont découpé la tâche de dépose d’objet (pick-and-place) en trois sous-objectifs, poursuivis 4, 10 puis 4 pas de temps, avec une replanification après chaque action.
Ce que la méthode interprète. Ce découpage tombe dans la colonne du réamorçage fréquent : zone confort si l’on tient chaque sous-objectif pour un horizon court, zone à instrumenter si l’on tient la dépose entière pour un horizon long découpé en sous-objectifs. La grille ne tranche pas entre les deux, et rien au dossier de cette fiche n’isole la part de ce découpage dans le taux de réussite.
Ce qui manque encore, et la question à poser avant d’évaluer un cas d’usage
Ce que la méthode interprète. Avant d’évaluer une démonstration ou un pitch construit sur JEPA ou V-JEPA 2 pour un cas d’usage propre, quatre questions permettent de l’examiner, les trois premières pour le placer sur la matrice horizon-réamorçage plutôt que de rester dans l’abstrait : sur combien de pas d’action successifs la planification a-t-elle été démontrée sans réamorçage intermédiaire (l’axe horizon), la démonstration fonctionne-t-elle en boucle fermée avec replanification à chaque étape ou en boucle ouverte sur la séquence complète (l’axe réamorçage), que se passe-t-il quand l’horizon de la tâche s’allonge (la confirmation de zone), et le code et les poids du modèle sont-ils accessibles, sous quelle licence, pour ce cas d’usage. Pour V-JEPA 2 lui-même, le papier renvoie à un dépôt de code public (github.com/facebookresearch/vjepa2), sans donner de licence de code dans son texte. Un cas d’usage qui atterrit en zone à risque n’est pas nécessairement impossible : il suggère, dans cette grille non éprouvée, de chercher d’abord à réduire l’horizon requis ou à ajouter du réamorçage.
Mes réserves
- Le papier V-JEPA 2 signale lui-même, parmi ses limites, l’accumulation d’erreur sur les horizons longs, ce qui en fait une source primaire plutôt qu’une critique extérieure ; les auteurs ne quantifient toutefois pas précisément à partir de combien de pas la dégradation devient prohibitive pour un cas d’usage donné, seulement que l’erreur s’accumule et que l’espace de recherche croît de façon exponentielle avec l’horizon.
- Le gain d’efficacité de 8,4x annoncé par les auteurs de V-JEPA 2 est une réduction de temps GPU obtenue par une montée en résolution progressive pendant le pré-entraînement, mesurée contre un entraînement direct à pleine résolution. C’est un rapport entre deux stratégies d’entraînement, pas une valeur absolue : aucun coût énergétique ne s’en déduit, et le dossier de cette fiche n’en porte aucun.
Retour au dossier « Comprendre les modèles post-LLM ». Voir aussi les fiches sœurs : Qu’est-ce que le TRM ? et Qu’est-ce que Mamba ?.
→ Voir l’analyse complète : après les LLM, ce que TRM, Mamba et JEPA prouvent vraiment
ISP-IA16/100· 0-30 % · Preuves très limitées · Cinq entrées, dont une seule paire mesure le même objet, et cet objet n'est pas celui que la page argumente. I-JEPA (2023) et V-JEPA 2 (2025) sont signés par l'équipe Meta qui a conçu les architectures qu'ils décrivent : ils ne sont pas indépendants l'un de l'autre. Tout ce que cette page chiffre du modèle vient du second : les taux de réussite de la saisie, 70 % et 60 % selon le laboratoire pour une tasse, 30 % et 20 % pour une boîte, moyennés sur dix essais par tâche avec permutations de l'emplacement de l'objet et de la pose de départ ; le découpage de la tâche de dépose, pick-and-place dans le tableau du papier, en trois segments de 4, 10 puis 4 pas de temps, cette tâche-là réussissant en moyenne 80 % sur la tasse et 65 % sur la boîte ; le contrôle à horizon glissant, terme des auteurs eux-mêmes ; l'accumulation d'erreur avec l'horizon, que les auteurs signalent en limite sans donner aucune valeur de bascule. FF-JEPA (KU Leuven, juin 2026) est indépendante de Meta, mais elle ne porte rien sur V-JEPA 2 : elle propose une architecture hiérarchique à planificateur latent contre l'échec des JEPA à long horizon, elle ne ré-exécute ni ne réévalue le modèle de Meta. TechCrunch et Sifted rapportent le même tour de table : c'est la seule paire du dossier qui mesure le même objet, et elle converge sur l'ordre de grandeur, plus d'un milliard de dollars, sans se recouper à la décimale, le second écrivant « more than $1bn » là où le premier écrit 1,03 milliard. Mais ce tour de table n'est pas un résultat de modèle, et cette page ne lui fait porter qu'un ordre de grandeur, sans le rattacher à JEPA. Sur tout ce que la page chiffre du modèle lui-même, il n'y a qu'un producteur, qui est aussi celui du modèle : aucune entrée ne peut y confirmer ni y contredire une autre, et la convergence ne s'y mesure pas. Le type de preuve est celui de la démonstration isolée : des taux moyennés sur dix essais, sans intervalle publié, et une matrice horizon-réamorçage qui est une grille de lecture de ma part, appuyée sur un dispositif documenté à sa source mais jamais éprouvée sur la question qu'elle pose. La réplication est nulle : rien au dossier ne ré-exécute la démonstration robotique ni n'isole par ablation la part attribuable à la prédiction dans l'espace latent. L'axe puissance se note sur les unités observées, et ce sont dix essais par tâche dans deux laboratoires, sur un modèle unique.
L'Indice de solidité des preuves évalue la base empirique de cette analyse sur quatre critères pondérés : type de preuve (40 %), convergence (30 %), réplication (20 %), puissance (10 %). L'axe type de preuve est calibré par champ : 100 y désigne le meilleur dispositif que l'échelle ISP-IA sache produire, et non une preuve absolue.
Cinq entrées, dont une seule paire mesure le même objet, et cet objet n'est pas celui que la page argumente. I-JEPA (2023) et V-JEPA 2 (2025) sont signés par l'équipe Meta qui a conçu les architectures qu'ils décrivent : ils ne sont pas indépendants l'un de l'autre. Tout ce que cette page chiffre du modèle vient du second : les taux de réussite de la saisie, 70 % et 60 % selon le laboratoire pour une tasse, 30 % et 20 % pour une boîte, moyennés sur dix essais par tâche avec permutations de l'emplacement de l'objet et de la pose de départ ; le découpage de la tâche de dépose, pick-and-place dans le tableau du papier, en trois segments de 4, 10 puis 4 pas de temps, cette tâche-là réussissant en moyenne 80 % sur la tasse et 65 % sur la boîte ; le contrôle à horizon glissant, terme des auteurs eux-mêmes ; l'accumulation d'erreur avec l'horizon, que les auteurs signalent en limite sans donner aucune valeur de bascule. FF-JEPA (KU Leuven, juin 2026) est indépendante de Meta, mais elle ne porte rien sur V-JEPA 2 : elle propose une architecture hiérarchique à planificateur latent contre l'échec des JEPA à long horizon, elle ne ré-exécute ni ne réévalue le modèle de Meta. TechCrunch et Sifted rapportent le même tour de table : c'est la seule paire du dossier qui mesure le même objet, et elle converge sur l'ordre de grandeur, plus d'un milliard de dollars, sans se recouper à la décimale, le second écrivant « more than $1bn » là où le premier écrit 1,03 milliard. Mais ce tour de table n'est pas un résultat de modèle, et cette page ne lui fait porter qu'un ordre de grandeur, sans le rattacher à JEPA. Sur tout ce que la page chiffre du modèle lui-même, il n'y a qu'un producteur, qui est aussi celui du modèle : aucune entrée ne peut y confirmer ni y contredire une autre, et la convergence ne s'y mesure pas. Le type de preuve est celui de la démonstration isolée : des taux moyennés sur dix essais, sans intervalle publié, et une matrice horizon-réamorçage qui est une grille de lecture de ma part, appuyée sur un dispositif documenté à sa source mais jamais éprouvée sur la question qu'elle pose. La réplication est nulle : rien au dossier ne ré-exécute la démonstration robotique ni n'isole par ablation la part attribuable à la prédiction dans l'espace latent. L'axe puissance se note sur les unités observées, et ce sont dix essais par tâche dans deux laboratoires, sur un modèle unique.
- Les taux de réussite de la saisie seraient republiés avec un intervalle, sur un protocole complet et un banc daté, au lieu de moyennes sur dix essais par tâche et par laboratoire.L'équipe qui publie le modèle, ou toute équipe disposant du code et des poids · un dispositif approchant existe, sans remplir la condition
- L'horizon à partir duquel la dégradation devient prohibitive serait chiffré, là où le document se borne à écrire que l'erreur s'accumule dans l'espace latent et que l'espace de recherche croît de façon exponentielle pour une hausse linéaire de l'horizon.L'équipe qui publie le modèle, ou toute équipe disposant du code et des poids · personne ne l’a produit
- La licence du code et des poids serait donnée, de sorte qu'une équipe tierce puisse rejouer la démonstration dans des conditions déclarées : le texte du papier ne donne aucune licence de code.L'équipe qui publie le modèle, sur le dépôt public qui héberge le code · un dispositif approchant existe, sans remplir la condition
Ce dispositif porterait l'indice à 22 sur 100, dans le palier « Preuves très limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Score de 16/100 (0-30 %) établi le 18 septembre 2026.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- LLM· Grand modèle de langage↗
- Modèle d'intelligence artificielle entraîné sur de vastes corpus de texte pour prédire et générer du langage, capable de tâches d'analyse, de synthèse et de génération de texte en langage naturel sans avoir été explicitement programmé pour la tâche demandée.
Modification apportée · mis à jour le 24 septembre 2026
J'ai relu cette fiche phrase par phrase contre les documents qu'elle cite, et j'y ai trouvé plusieurs endroits où j'en disais plus qu'eux. Le sous-titre répondait à la question du titre par « quelques pas » : les 4, 10 et 4 pas de temps mesurent le temps passé sur chacun des trois sous-objectifs de la dépose, pas un horizon de planification, que le papier ne chiffre pas ; le modèle, lui, n'exécute qu'une action avant de replanifier. Le sous-titre, le résumé et le corps le disent désormais de la même façon. J'écrivais que le prédicteur devine l'embedding de « l'état futur » : pour I-JEPA, la cible est une autre région de la même image, et seul le modèle d'action V-JEPA 2-AC anticipe l'état suivant ; le résumé, le corps, l'encadré, la figure et son texte alternatif sont corrigés ensemble. La typologie des modèles génératifs d'image (GAN, VAE, diffusion) n'était portée par aucune de mes sources : elle sort, du texte comme de la figure. La bibliographie attribuait le papier V-JEPA 2 à « Meta AI / AMI Labs » alors qu'il est signé par l'équipe FAIR de Meta. J'ai retiré plusieurs formulations qui dépassaient mes sources : une hiérarchie des critères (« pèse le plus »), une grille présentée comme « testée » alors qu'elle n'a jamais été éprouvée, un découpage qui « explique » un succès sans qu'aucune ablation ne le montre, un superlatif (« la limite la plus concrète »), une saisie d'objet « inconnu » là où le papier établit des objets nouveaux dans des laboratoires absents des données robot, une cause attribuée à l'écart entre la tasse et la boîte, un « communiqué de financement » qu'aucune de mes sources n'est. Le JEPA n'est plus attribué à Yann LeCun seul mais à une équipe de Meta dont il fait partie. Les questions à poser avant d'évaluer un cas d'usage étaient annoncées au nombre de trois et en comptaient quatre ; la dernière reçoit maintenant la réponse que porte le papier, un dépôt de code public sans licence de code dans son texte. L'indice ne change pas. En revérifiant chaque chiffre contre le papier V-JEPA 2 lui-même, j'ai trouvé et corrigé une vraie erreur : le modèle compte jusqu'à 1 milliard de paramètres, pas 1,2 milliard comme je l'avais écrit. J'ai aussi resserré des formulations qui dépassaient ce que mes sources établissent : « un courant de recherche entier reconnu par le champ » n'est en réalité adossé qu'à un seul article de suivi, l'attribution du papier à AMI Labs (c'est son auteur qui a rejoint AMI Labs après coup, pas le papier qui a changé de bannière) était imprécise, et deux constats d'absence (produit commercial, déploiement à grande échelle) sont maintenant présentés comme ce que j'ai personnellement constaté, pas comme un fait universel. J'ai retiré une mention de « vision industrielle » et un détail de découpage temporel (« un seul pas ») que je ne pouvais pas retrouver dans mes sources. J'ai précisé la démonstration de préhension V-JEPA 2 avec les taux de réussite publiés (65 % pour une tasse, 25 % pour une boîte) et le périmètre exact de la nouveauté de l'objet, corrigé le contraste avec les modèles génératifs d'image (GAN, VAE, diffusion, pas seulement du pixel par pixel), sourcé le milliard de dollars levé, et ajouté une question sur la licence du code et des poids à la checklist finale. J'ai ajouté deux encadrés « En clair » : l'un sur la façon dont l'architecture prédit une représentation abstraite plutôt que des pixels, l'autre sur l'accumulation d'erreur qui impose de replanifier à chaque geste. Relecture ultérieure contre le tableau du papier : le découpage en trois segments de 4, 10 puis 4 pas de temps ne décrit pas la saisie (Grasp) mais la dépose (pick-and-place), deux tâches distinctes dans la taxonomie des auteurs, aux taux de réussite différents. La distinction est maintenant faite partout où le découpage apparaît, sous-titre et résumé compris, et les taux propres à la dépose (80 % sur la tasse, 65 % sur la boîte) accompagnent désormais l'exemple, pour qu'il ne soit plus lu à côté des 65 %/25 % de la préhension seule. Deux constats d'absence qui ne reposaient que sur ma propre recherche, sur le produit commercial et sur le déploiement, sont remplacés par ce que la source écrit vraiment : pas de projet de revenu pour le moment, un premier partenaire annoncé au futur. La comparaison énergétique avec les grands modèles de langage, qu'aucune de mes sources ne documente, est retirée : le passage dit maintenant seulement ce que le gain de 8,4x mesure, un temps GPU contre un entraînement direct à pleine résolution. La note de convergence disait qu'aucune paire ne mesurait le même objet tout en décrivant deux lignes plus bas une paire qui le fait : elle nomme désormais cette paire et dit pourquoi son objet, le tour de table, n'est pas celui que la page argumente. Nouvelle passe sur les étiquettes de niveau de preuve : le paragraphe qui décrit l'architecture, encodeur puis prédicteur, ne porte aucun relevé chiffré et passe de l'étiquette réservée aux données à celle qui nomme le document. La mise en regard avec « une planification jointe des dix-huit pas », qui est une comparaison de ma part et non une phrase du papier, quitte l'étiquette des données pour le paragraphe d'interprétation qui suit. Le milliard de paramètres porte sur l'encodeur seul, comme l'écrit le papier, et non sur l'architecture complète. La figure de comparaison, son texte intérieur comme son texte alternatif, opposait encore « mot suivant / pixel suivant » alors que le corps venait d'écrire que la reconstitution d'image est rarement séquentielle : les trois surfaces disent maintenant la même chose, le mot suivant pour le texte, les pixels d'un bloc ou par débruitage pour l'image, et le chapô suit. Dernière relecture : je rapprochais la levée d'AMI Labs de l'architecture, en écrivant que l'horizon de planification pèse « au moins autant que le financement » et que « la preuve produit n'est pas au rendez-vous de la levée ». Aucune de mes sources ne dit qu'AMI Labs développe JEPA ou V-JEPA 2 : le seul lien est Yann LeCun. La levée n'est plus citée qu'une fois, avec cette réserve, et le passage sur l'absence de revenu et le partenariat futur d'AMI Labs, qui ne portait que sur l'entreprise, sort de la fiche avec la réserve qui le résumait. Le sous-titre ne présente plus l'architecture comme « pensée pour comprendre et anticiper le monde physique » : dans ma source, la formule décrit les world models de l'entreprise, pas JEPA. L'idée d'« ignorer volontairement les détails qui ne comptent pas » n'est pas dans ce que j'ai relevé du papier I-JEPA : la fiche dit maintenant ce que son résumé écrit, une approche non générative qui prédit des représentations. Une saisie « démontrée et déjà notable » devient ce qui a été montré : deux objets, deux laboratoires, dix essais. Toutes les cellules de la matrice sont maintenant marquées comme hypothèses de lecture, et une dérive « bornée » devient une dérive supposée limitée, le papier disant seulement que la précision baisse quand l'horizon s'allonge. Une zone à risque ne « signale » plus ce qu'il faut faire : elle le suggère, dans une grille non éprouvée. La note d'indice ne parle plus de graines, dont mes sources ne disent rien. L'indice ne change pas.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus