Surplus de l'IA générative : 124,50 dollars de moyenne, 11,48 de médiane
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
L'équation (3) du working paper de Stanford ne mobilise que la moyenne. Le tableau 2 publie pourtant une médiane de 11,48 dollars par mois à côté d'une moyenne estimée à 124,50. Refaire la multiplication publiée avec l'une puis avec l'autre ne produit pas deux estimations concurrentes : le rapport entre les deux totaux dit ce que l'agrégat doit à la queue haute de la distribution que le modèle ajuste.
- Le total sort d'une multiplication à trois facteurs. L'équation (3) du working paper du Stanford Digital Economy Lab, daté du 13 avril 2026, multiplie un consentement à recevoir moyen de 124,50 dollars par mois par 115,33 millions d'utilisateurs, puis annualise : 172,30 milliards de dollars.
- Le même tableau publie une médiane de 11,48 dollars. L'équation (3) ne la mobilise pas ; la même formule sur cette médiane donne 15,89 milliards de dollars par an, soit un rapport de 10,8 entre les deux totaux, qui dit ce que le total doit à la queue haute de la distribution ajustée.
- Le seuil de 124,50 dollars n'existe qu'au niveau agrégé. Chaque répondant ne voit qu'un seul des sept montants proposés, en réponse binaire : la médiane est le prix auquel la probabilité d'acceptation prédite atteint 0,5, la moyenne l'aire sous la courbe ajustée.
Le chiffre de 172,3 milliards de dollars de surplus consommateur annualisé attribué à l’IA générative aux États-Unis au début 2026 sort d’un working paper du Stanford Digital Economy Lab daté du 13 avril 2026, qui ne porte aucune mention de relecture par les pairs [1]. Il vient d’une équation, numérotée (3) à la page 6 : un consentement à recevoir moyen, multiplié par un nombre d’utilisateurs, multiplié par douze [1]. Ce texte porte sur le premier de ces trois facteurs, et sur une seule question à son sujet : ce que le total doit au choix d’une moyenne plutôt que d’une médiane.
La chaîne est explicite : surplus = consentement à recevoir moyen (124,50 dollars par mois) × nombre d’utilisateurs (115,33 millions) × 12 [1]. Le tableau 2, page 7, publie dans la même colonne une médiane de 11,48 dollars par mois, que l’équation (3) n’utilise pas [1].
Le tableau 2 de l’étude Stanford publie une médiane près de onze fois plus basse que la moyenne
Ce que les données établissent. L’équation (3) ne mobilise que la moyenne : « To compute aggregate consumer surplus, we multiply mean WTA by the number of US adult generative AI users and annualize » [1]. Le tableau 2 publie pourtant les deux mesures côte à côte. Les auteurs rapprochent la médiane de la queue haute une seule fois, page 8, dans une phrase qu’ils ne relient pas à leur agrégat : « Looking at the median is also less susceptible to extreme valuations at the upper end of the distribution » [1]. Le papier ne publie aucune estimation de surplus fondée sur la médiane, ni aucun test de sensibilité de l’agrégat à sa troncature [1].
Rapprochement que je construis ici. La formule est publiée et ses paramètres aussi, donc je peux la faire tourner sur la médiane. 11,48 dollars × 115,33 millions d’utilisateurs donne 1,324 milliard de dollars par mois, soit 15,89 milliards par an, contre 172,30 sur la moyenne. Ce total de 15,89 milliards n’est publié nulle part et je ne le propose pas comme estimation du surplus : il n’existe que pour être comparé à l’autre. Rapport entre les deux totaux : 10,8. C’est un diagnostic de dispersion, pas un second chiffrage. Le papier porte deux médianes 2026 légèrement différentes, 11,48 au tableau 2 et 11,40 dans trois autres passages [1] ; sur 11,40, l’agrégat vaut 15,78 milliards et le rapport monte à 10,9. Le choix entre les deux ne change donc rien : à paramètres strictement identiques, le résultat de la multiplication publiée varie d’environ 156 milliards de dollars selon la mesure de tendance centrale qu’on y place.
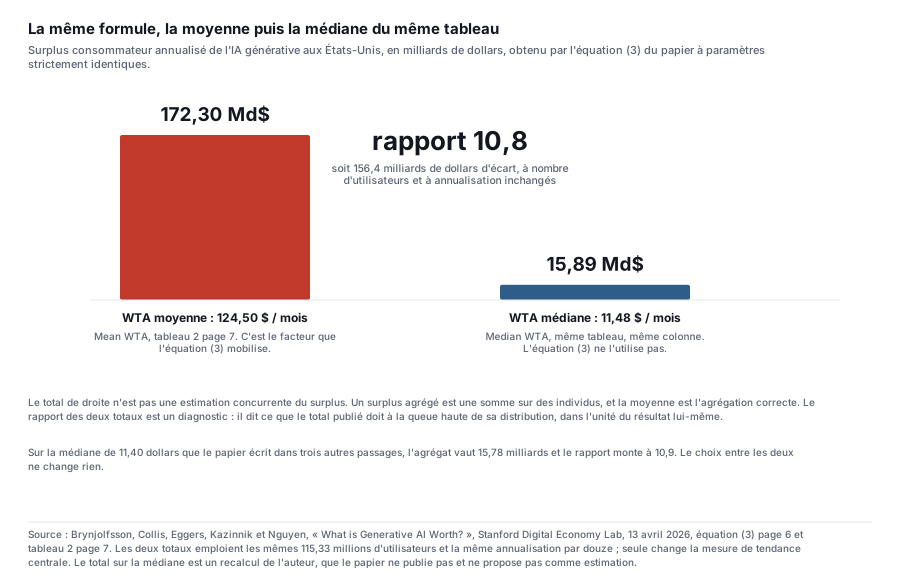
Ce que la méthode interprète. J’appelle ça le test de la médiane. Il ne se refait pas sur n’importe quel agrégat : il demande une formule d’agrégation publiée, une moyenne et une médiane issues du même ajustement, et les deux imprimées dans le même tableau. Quand ces trois conditions sont réunies, l’opération tient en trois gestes : reprendre la formule, remplacer la moyenne par la médiane, lire le rapport des deux totaux. Ce rapport ne dit pas laquelle des deux mesures est la bonne. Il dit ce que le total doit à la queue haute de la distribution. Plus il est grand, moins le total décrit l’utilisateur typique. Un rapport de près de onze est très grand.
Extrapolation prudente. Un tel écart est la signature d’une distribution fortement étirée vers le haut, ce qui est cohérent avec les « extreme valuations at the upper end » que les auteurs mentionnent [1]. Une précaution s’impose sur ce qu’il mesure vraiment : moyenne et médiane sont ici deux propriétés d’une même courbe ajustée, jamais deux résumés de valorisations observées, et leur rapport dépend donc aussi de la forme retenue pour cet ajustement. La distribution que je dis étirée est celle que le modèle produit, pas celle que l’enquête recueille, et le papier ne publie pas la seconde. Quelle part exacte des 172 milliards vient de cette queue haute, je ne peux pas la calculer : les données individuelles ne sont pas publiées, la courbe d’acceptation de la figure 2 n’est pas tabulée, et le tableau qui porte les deux estimations ne donne ni percentile ni intervalle de confiance [1].
Le seuil de 124,50 dollars n’existe qu’au niveau agrégé
Ce que les données établissent. La question qui produit tout le reste est la question 8 du questionnaire, annexe B page 17 : « Would you give up access to any AI tool like ChatGPT, Gemini, Claude, or Copilot for one month starting tomorrow morning in exchange for $1/$10/$20/$50/$100/$200/$500? » Oui ou non, rien d’autre [1]. Chaque répondant ne voit qu’un seul de ces sept montants, tiré au sort [1]. La médiane est ensuite définie comme le prix auquel la probabilité d’acceptation prédite atteint 0,5, et la moyenne comme l’aire sous la courbe ajustée [1].
Le document énonce cette question deux fois, et pas dans les mêmes termes. La section 2 de la page 4 la rapporte comme « all AI tools » et décrit le choix comme le renoncement à tous les outils d’IA générative ; l’annexe B, que le papier présente comme reproduisant le questionnaire complet, écrit « any AI tool », et les légendes des figures 2 et 5 aussi [1]. Renoncer à la catégorie entière ou à un seul outil ne mesure pas la même grandeur. Je retiens la formulation de l’annexe, parce que c’est celle que les répondants ont eue sous les yeux, et je signale l’écart parce qu’il porte sur la question dont sort le chiffre.
Ce que la méthode interprète. Aucun des 1 908 répondants retenus après nettoyage sur la vague de mars 2026 [1] n’a déclaré qu’il lui faudrait 124,50 dollars pour se passer d’IA générative pendant un mois. Le seuil n’existe qu’au niveau agrégé. Ce n’est pas un défaut de la méthode, c’est le principe d’une expérience de choix discret. Mais c’est aussi ce qui explique que les deux chiffres ne soient pas contraints d’être proches : une aire et une abscisse peuvent diverger d’un facteur dix sans que rien ne soit incohérent.
Deux usages que ce chiffre ne permet pas
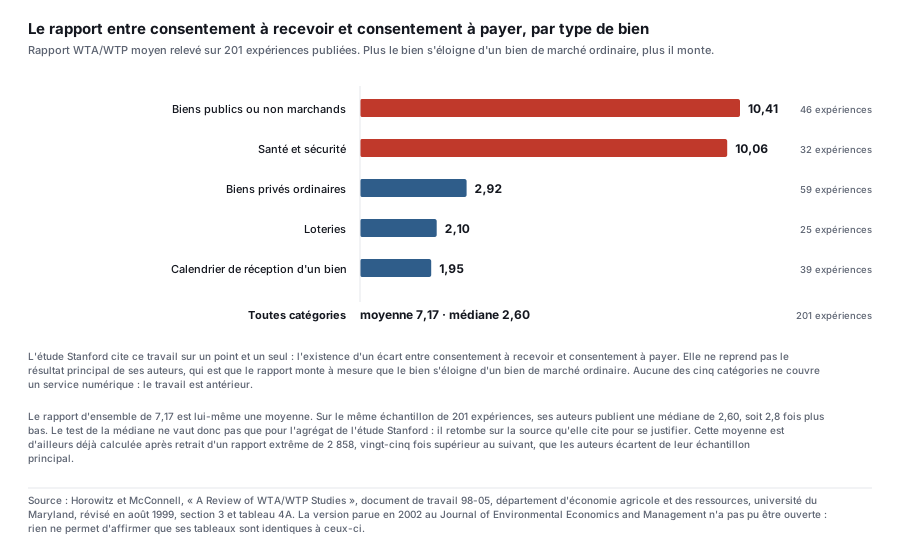
Ce que les données établissent. Les auteurs justifient le choix d’un consentement à recevoir en une phrase, page 2 : les répondants possèdent déjà l’accès à ces outils, et pour un bien déjà détenu, c’est la mesure de bien-être appropriée [1]. Ils citent Horowitz et McConnell (2002) sur un point et un seul, l’existence bien documentée d’un écart entre consentement à recevoir et consentement à payer [1][2]. Aucune question de consentement à payer ne figure dans le questionnaire de l’annexe B [1]. Dans le document de travail de 1999 dont ces chiffres sont tirés, ces deux auteurs publient bien un rapport d’ensemble entre les deux mesures, 7,17 sur 201 expériences [2]. Mais le résultat principal de Horowitz et McConnell est que ce rapport monte à mesure que le bien s’éloigne d’un bien de marché ordinaire : de 1,95 pour le calendrier de réception d’un bien à 10,41 pour les biens publics et non marchands [2]. Aucune de leurs cinq catégories ne couvre un service numérique.
Rapprochement que je construis ici. Leur 7,17 est une moyenne. Page 9, ils publient à côté la médiane du même échantillon de 201 expériences : 2,60 [2]. Le rapport entre les deux vaut 2,8, et cette moyenne est déjà calculée après retrait d’un rapport extrême de 2 858, vingt-cinq fois supérieur au suivant, que les auteurs écartent de leur échantillon principal [2]. Ce n’est pas le test décrit plus haut, il n’y a ici aucun agrégat à recalculer, et je n’en tire aucun coefficient de substitution. C’est la même dissymétrie, sur le nombre même que l’étude Stanford emprunte à ces auteurs : un rapport moyen entre deux consentements ne décrit pas l’expérience médiane.
Ce que la méthode interprète. Les deux usages hors de portée sont aussi les deux plus tentants.
Dimensionner un marché adressable, d’abord. Les 172 milliards ne sont pas un chiffre d’affaires latent : ils estiment le supplément de bien-être que les utilisateurs retirent d’un accès qu’ils ne paient pas, ou pas en totalité. Les convertir en potentiel de revenus supposerait qu’un fournisseur puisse capter cette valeur tout entière.
Fixer un prix d’abonnement, ensuite. Le montant obtenu répond à « combien faudrait-il vous verser pour que vous y renonciez », pas à « combien accepteriez-vous de payer ». L’étude ne mesure pas la seconde grandeur, et la littérature qu’elle cite documente un écart entre les deux sans fournir de coefficient applicable à un bien numérique récent [1][2]. La médiane du même tableau vaut 11,48 dollars par mois, mais c’est le prix auquel le modèle ajusté prédit une probabilité d’acceptation de 0,5, pas un prix de marché [1].
La meilleure objection à ce que j’écris
Elle ne porte pas sur le papier, elle porte sur mon calcul, et elle est théorique. Un surplus agrégé est une somme sur des individus : additionner ce que chacun retire de l’accès, c’est exactement multiplier une moyenne par un effectif. La moyenne est donc l’agrégation correcte, et pas seulement l’agrégation choisie. La médiane multipliée par le même effectif, elle, n’agrège rien : elle n’est l’estimateur d’aucune grandeur de bien-être. Un économiste qui lit mon rapprochement a raison de refuser les 15,89 milliards comme estimation concurrente.
Je l’accorde entièrement, et c’est la raison pour laquelle je n’en propose pas une. Le rapport des deux totaux n’est pas un estimateur, c’est un diagnostic. Il ne dit pas laquelle des deux opérations est la bonne, il dit ce que le total publié doit à la queue haute de sa distribution, et il le dit dans l’unité du résultat lui-même, ce qu’aucun coefficient d’asymétrie ne fait. Si la moyenne est la bonne agrégation, alors mon rapprochement ne retire rien aux 172,3 milliards : il ajoute que ce total est porté par une distribution fortement asymétrique, dont je ne peux pas chiffrer la concentration. Ces deux propositions ne s’opposent pas. La seconde manque simplement partout où le chiffre circule.
Une phrase du papier va d’ailleurs dans l’autre sens que la mienne, et elle mérite d’être citée pour cela, entière. Sa conclusion, page 10, retient l’étendue et non la concentration : l’accès à ces outils « appears to generate substantial welfare gains for a broad share of the population, far exceeding estimated consumer revenues by their vendors » [1]. Cette seconde clause compare mon chiffre américain, 172,3 milliards de dollars, à un revenu consommateur que le papier situe à l’échelle mondiale et qualifie lui-même de simple borne haute (« upper bound ») : je ne la reprends pas ici, périmètres géographiques non homogènes. C’est le seul énoncé du document sur la répartition des gains, et il n’est pas compatible avec la lecture que le rapport de dix suggère. Je ne peux pas les départager : il faudrait pour cela les percentiles que le papier ne publie pas.
Quatre éléments vont dans le même sens et méritent d’être portés au crédit du papier. La moyenne est tronquée à 500 dollars, le montant le plus élevé proposé, et les auteurs reconnaissent page 6 qu’autoriser des valorisations au-delà augmenterait l’estimation [1]. Page 10, ils indiquent que 12 % des répondants refusent même cette offre maximale [1]. Page 9, ils préviennent que renoncer à l’IA générative pendant un an pourrait coûter plus de douze fois le montant mensuel, ce qui rend leur multiplication par douze possiblement conservatrice, selon leurs propres termes [1]. Sur la même page, ils nomment la limite la plus classique de ce type de protocole, celle que je n’ai pas à leur apprendre : « hypothetical bias remains a concern », l’écart documenté entre ce qu’on déclare accepter et ce qu’on accepte quand l’argent est réellement en jeu [1]. Un résultat voisin mérite d’être cité, à condition de ne pas lui faire dire plus qu’il ne dit. Page 2 de leur document de travail, Horowitz et McConnell relèvent que sur leur corpus, le rapport entre les deux consentements n’est pas significativement plus faible en expérience réelle qu’en expérience hypothétique, et qu’il monte quand le protocole est compatible avec les incitations [2]. Leur résultat porte sur ce rapport, pas sur le niveau absolu d’un consentement à recevoir déclaré : il ne dit donc rien du biais que les auteurs de Stanford nomment. Ce papier publie sa formule, numérote son équation et nomme chacun de ses paramètres. Le recalcul que je fais plus haut n’est possible que pour cette raison.
Ce que je maintiens malgré ça tient en une phrase. La transparence de construction et la stabilité en diffusion sont deux propriétés différentes, et la première ne protège pas de la seconde. Tout ce qu’il faut pour construire ce rapport se trouve dans une seule colonne d’un seul tableau public. Le papier ne l’a pas fait. Et la médiane n’est pas escamotée par les reprises : le rapport AI Index de Stanford publie les deux mesures côte à côte, 3,4 puis 11,4 dollars pour la médiane, 98 puis 125 pour la moyenne [4] ; l’infolettre que je cite écrit que la médiane a triplé en un an [3]. Ce qu’aucune des reprises que j’ai lues ne fait, c’est la porter dans la multiplication d’agrégat : l’AI Index en publie la progression, +235,29 %, jamais un total [4]. Ce n’est donc pas la médiane qui manque à la diffusion du chiffre, c’est la multiplication qu’elle autorise.
Mes réserves
- Un document que rien n’identifie, et qu’aucune revue n’a encore lu. Le papier ne porte ni numéro de série, ni revue de destination, ni mention de relecture par les pairs. Ce qui le classe comme travail en cours lui est extérieur : c’est la page de publication du laboratoire qui le libelle « Working Paper » [1]. Je ne traite donc pas les 172,3 milliards de dollars comme un résultat stabilisé. Si ce papier paraît en revue à comité de lecture, cette réserve tombe et ce texte doit être repris.
- Une source partie prenante de ce qu’elle mesure. Les auteurs conçoivent l’enquête, produisent le chiffre et le diffusent eux-mêmes. Je les classe [P], comme je le ferais des données d’un gérant, et j’applique à cette page le plafond de preuve qui va avec. Le statut académique ne change rien à ce classement.
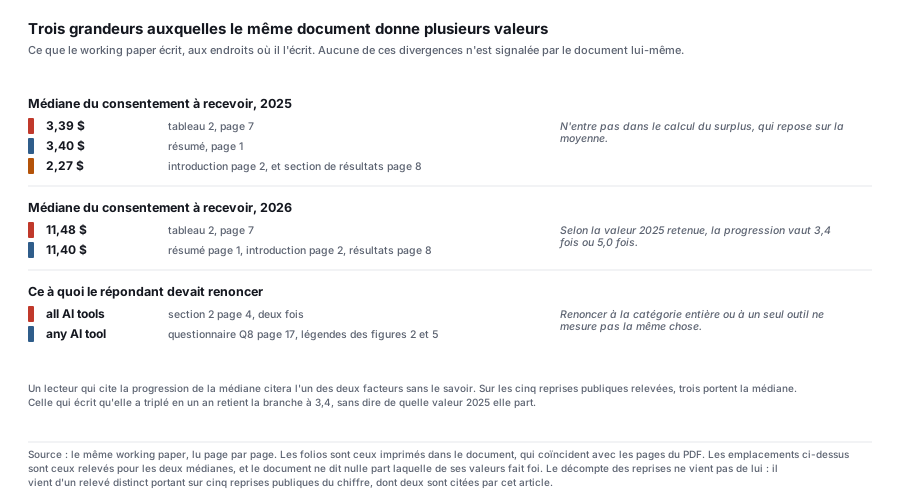
- Deux valeurs pour la même médiane 2025, et rien ne dit laquelle fait foi. Selon celle qu’on retient, la progression jusqu’à 2026 vaut un facteur 3,4 ou un facteur 5,0, et qui cite cette progression cite l’une des deux branches sans le savoir [1]. Ces valeurs n’entrent pas dans mon calcul, qui ne mobilise que la moyenne et la médiane de 2026. Elles disent en revanche ce qu’il faut attendre de la précision du reste.
- La question qui produit tout le reste est posée deux fois, en deux termes différents. Renoncer à tous les outils d’IA, ou à un seul d’entre eux, ne mesure pas la même valeur [1]. Je ne sais pas lequel des deux libellés les répondants ont eu sous les yeux.
- Un rapport entre une moyenne et une médiane ne mesure pas une concentration. Il établit que la distribution est asymétrique, il ne dit pas quelle part du total vient de quelle tranche d’utilisateurs. Les données individuelles ne sont pas publiées, et le papier ne donne ni percentile ni intervalle de confiance [1]. Toute lecture qui conclurait qu’une minorité porte l’essentiel de la valeur va au-delà de ce que je peux montrer, et je m’en suis moi-même approché de trop près.
- Deux facteurs de l’équation que je ne mets pas en cause, et qui portent leur propre incertitude. Les 115,33 millions d’utilisateurs ne sont pas mesurés par l’étude : ils viennent d’un taux d’adoption emprunté à un autre travail, appliqué à la tranche des 18 à 64 ans et non à la population adulte. L’annualisation par douze est une convention, pas un résultat [1]. Mon rapport y est insensible, puisqu’il compare deux totaux construits sur les mêmes facteurs. Le niveau des 172,3 milliards, lui, en dépend entièrement.
- Le chiffre de comparaison de 2025 diverge dès le premier relais. Le papier écrit 116,2 milliards de dollars et 98,78 millions d’utilisateurs ; le rapport AI Index de la même université publie 112 milliards et 95 millions, sans signaler l’écart [1][4]. La progression annoncée n’est donc pas la même selon la source qu’on ouvre, et cette divergence-là ne naît pas dans la presse.
- Les chiffres que j’emprunte à Horowitz et McConnell viennent d’une version de travail. L’article publié en revue ne m’a pas été accessible, et rien ne me permet d’affirmer que ses tableaux sont identiques à ceux de la version que j’ai lue [2]. Leur nomenclature ne comporte par ailleurs aucune catégorie de bien numérique : leurs rapports situent un ordre de grandeur, ils ne fournissent aucun coefficient applicable ici.
Ce que j’en retire pour lire le prochain agrégat de valeur perçue construit de cette façon. Chercher la médiane dans le même tableau que la moyenne. Refaire la multiplication avec elle. Regarder le rapport des deux totaux. Si la formule n’est pas publiée, le chiffre n’est pas lisible. Si elle l’est et que le rapport est grand, le total dit d’abord quelque chose sur la forme de la distribution, et seulement ensuite sur ce que vaut l’accès pour un utilisateur ordinaire.
Concrètement, quiconque veut se servir de ce chiffre pour dimensionner un marché ou fixer un prix gagne à refaire d’abord cette division, parce que ce que ces données montrent le plus clairement, c’est l’écart entre le total et l’utilisateur qu’il est censé décrire.
Retour au dossier Surplus consommateur de l’IA gratuite · Lire la Décision possible du dossier.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Consentement à recevoir (WTA)· Willingness to accept↗
- Montant minimal qu'un individu accepterait en échange de la privation d'un bien qu'il possède déjà ; distinct du consentement à payer (willingness to pay, WTP), utilisé pour un bien qu'il ne possède pas encore. La littérature établit que les deux mesures divergent structurellement pour un même bien.
- Expérience de choix en ligne↗
- Méthode d'enquête qui propose à chaque répondant un montant de compensation tiré aléatoirement, afin de reconstituer une courbe de demande à partir des taux d'acceptation observés à chaque prix, sans qu'aucun répondant ne réponde à toutes les valeurs testées.
Modification apportée · mis à jour le 31 août 2026
- Reprise du 31 août 2026, sur les sources rouvertes et relues en entier.
- Correction la plus lourde : j'écrivais qu'une seule des cinq reprises publiques que j'avais lues mentionnait la médiane. Trois la mentionnent, et le rapport AI Index de Stanford publie même la médiane et la moyenne par utilisateur côte à côte. Ma phrase suggérait que la médiane était escamotée en diffusion ; elle est reprise, simplement jamais portée dans la multiplication. Le fait exact est plus intéressant que celui que j'avançais.
- Le libellé « Working Paper » retiré du document : il est sur la page de publication du laboratoire, pas sur le papier, qui ne porte aucun identifiant.
Voir les 6 autres
- « Le document n'a pas été relu de bout en bout » retiré : deux passages seulement l'attestent, et je le dis désormais ainsi.
- « Une minorité porte l'essentiel de la valeur mesurée » retiré : un rapport entre une moyenne et une médiane ne permet pas de l'écrire, comme un autre paragraphe de cette page le reconnaissait déjà.
- Trois ajouts que la relecture a rendus : le papier énonce sa question centrale de deux manières, le rapport de 7,17 emprunté à Horowitz et McConnell est lui-même une moyenne dont ils publient la médiane à côté (2,60), et le chiffre de comparaison de 2025 diverge entre le papier et son relais le plus lu, 116,2 milliards contre 112.
- Deux liens internes retirés : ils pointaient vers des textes qui n'existent pas.
- Réserves réécrites en liste, une entrée par limite, pour qu'elles se lisent sans être déduites du raisonnement qui les précède.
- Indice de solidité de la preuve du dossier : 32 à 23. Je ne l'ai pas fait baisser en corrigeant le texte, je l'avais surévalué. Deux vagues d'enquête menées par la même équipe sur le même protocole ne sont pas une réplication, et 3 399 répondants ne font pas un échantillon large. Une note plus basse sur une pièce mieux étayée est le résultat normal de ce travail.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus