Que coûte un LLM de raisonnement par requête ?
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
Environ treize fois plus d'énergie quand la sortie passe de 300 à 5 000 tokens médians, selon une estimation publiée dans Joule (Oviedo et al., Microsoft, 2026) qui associe ce régime long aux modèles de raisonnement comme aux longs flux agentiques : pour un panel de trois modèles à poids ouverts de plus de 200 milliards de paramètres sur nœuds H100, 0,31 Wh en médiane contre 3,91 Wh. Cette sous-famille de LLM insère une longue étape de calcul intermédiaire avant de répondre ; le facteur est une estimation ascendante construite sur des hypothèses de matériel et de charge, pas une mesure au compteur.
- Le modèle écrit d'abord un brouillon, masqué chez OpenAI. Un LLM de raisonnement ajoute une étape avant de répondre : il produit d'abord une longue chaîne de raisonnement intermédiaire, qu'OpenAI a choisi de ne pas montrer à l'utilisateur. DeepSeek décrit celle de sa variante R1-Zero comme des réponses plus longues qui incorporent vérification, réflexion et exploration d'autres approches.
- Une estimation multiplie par environ 13 l'énergie médiane quand la sortie médiane passe de 300 à 5 000 tokens. Les auteurs décrivent ce scénario comme quinze fois plus long que la requête type ; le rapport des deux médianes de sortie, 5 000 sur 300, fait environ 17 par mon calcul. Oviedo et al. (2026) situent un panel de trois modèles à poids ouverts de plus de 200 milliards de paramètres (DeepSeek-R1, Llama 3.1 405B, Llama 3.1 Nemotron Ultra 253B) à 0,31 Wh en médiane pour une sortie de 300 tokens médians, contre 3,91 Wh pour une sortie de 5 000 tokens médians. Les auteurs jugent eux-mêmes probable une sous-estimation pour les très longues générations.
- Par bonne réponse, le seuil se calcule sans tarif. Sur l'examen AIME 2024, sous trois hypothèses (réponse vérifiable, essais indépendants, taux homogène d'un problème à l'autre) et avec les taux publiés par OpenAI en annexe (9,3 % pour GPT-4o, 44,6 % pour o1-preview), il faut dans mon calcul en moyenne 10,75 essais au premier contre 2,24 au second. Sous ces hypothèses, o1-preview ne revient moins cher par bonne réponse que si une tentative lui coûte moins d'environ 4,8 fois une tentative de GPT-4o.
Depuis 2024, une sous-famille de LLM se distingue des autres. Popularisée par o1 d’OpenAI, prolongée par DeepSeek-R1 de l’entreprise chinoise DeepSeek puis par o3, elle intercale une étape de calcul intermédiaire avant de livrer sa réponse finale. On l’appelle un LLM “de raisonnement”. Ce que la méthode interprète : le nom est trompeur s’il laisse penser à une forme de réflexion humaine ; rien dans les données disponibles n’établit qu’il s’agisse d’une nouvelle faculté cognitive plutôt que d’un choix d’ingénierie qui a un coût.
Ce qu’un LLM standard fait, et ce que la sous-famille “raisonnement” ajoute
Un LLM standard génère directement sa réponse, sans étape préalable. L’estimation énergétique citée plus bas pose la requête « traditionnelle », courante en conversation sans calcul intensif au moment du test, à 300 tokens de sortie médians.
Ce que le rapport écrit. Un LLM de raisonnement ajoute une étape avant cette génération : il produit d’abord une chaîne de raisonnement intermédiaire, et la réponse finale n’arrive qu’après. OpenAI écrit avoir « decided not to show the raw chains of thought to users », et sa documentation développeur précise que ces tokens de raisonnement ne sont pas visibles via l’API, mais facturés comme tokens de sortie. DeepSeek décrit le contenu de cette chaîne pour sa variante R1-Zero, entraînée par apprentissage par renforcement à partir de DeepSeek-V3-Base, sans phase d’affinage supervisé préalable : des réponses plus longues, qui incorporent selon le papier « verification, reflection, and the exploration of alternative approaches ». DeepSeek-R1 ajoute une étape de constitution de données d’affinage supervisé, que le papier chiffre à 5 000 heures-GPU.
Ce que la méthode interprète. Le mot “raisonnement” décrit le comportement que DeepSeek rapporte pour R1-Zero (vérification, réflexion, exploration d’autres approches), alors que chez OpenAI la chaîne brute n’est pas montrée à l’utilisateur ; il ne dit rien sur ce qui se passe réellement à l’intérieur du modèle. C’est une description fonctionnelle d’un calcul, pas la preuve d’un mécanisme cognitif comparable à un raisonnement humain.
Un calcul mobilisé au moment de répondre, pas pendant l’entraînement
Ce que la méthode interprète. J’appelle ce calcul supplémentaire le test-time compute, ou calcul au moment du test : l’expression figure chez Oviedo et al. (2026), qui nomment « test-time scaling » le régime de requêtes longues qu’ils simulent. Il se distingue du calcul d’entraînement, qui façonne les paramètres du modèle une fois pour toutes avant sa mise en service. Le test-time compute, lui, est dépensé à chaque nouvelle requête, à chaque fois qu’un utilisateur pose une question. C’est un déplacement de curseur : plutôt que d’investir uniquement dans un entraînement plus long ou plus coûteux, on investit dans un calcul répété à chaque usage. Je détaille ce principe dans la fiche dédiée : voir Test-time compute : pourquoi certains modèles “réfléchissent”.
Ce que ça coûte, chiffré
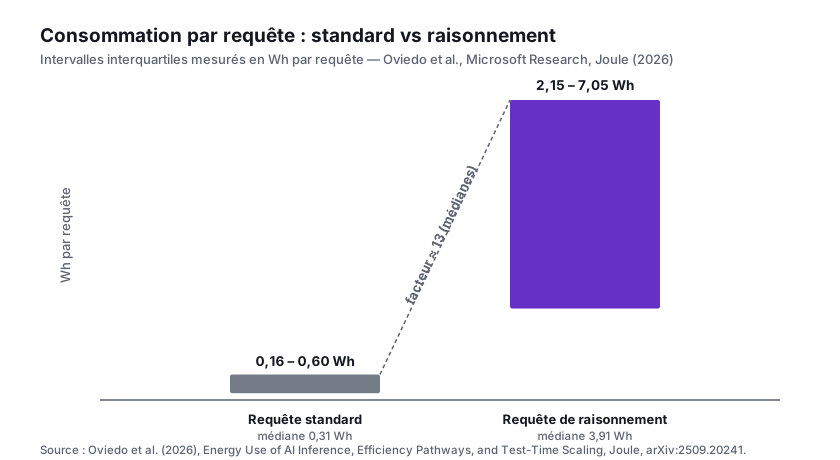
Ce que le rapport écrit. Ce calcul supplémentaire n’est pas gratuit. Une estimation publiée en 2026 dans la revue Joule par huit chercheurs de Microsoft (Oviedo et al., arXiv:2509.20241 pour le texte intégral consulté ; le type éditorial précis de l’article, au-delà de sa publication effective, n’est pas confirmé par la source elle-même) est une estimation ascendante, construite à partir d’hypothèses de matériel et de charge à l’échelle de production, pas une mesure physique directe requête par requête. Elle situe un panel de trois modèles à poids ouverts de plus de 200 milliards de paramètres (DeepSeek-R1, Llama 3.1 405B, Llama 3.1 Nemotron Ultra 253B), sur nœuds H100, à 0,31 Wh en médiane pour une sortie de 300 tokens médians, contre 3,91 Wh en médiane pour une sortie de 5 000 tokens médians, soit un facteur d’environ 13. Les auteurs posent ce scénario long comme une requête quinze fois plus longue que la requête type, et l’associent aux modèles de raisonnement comme o3 ou DeepSeek-R1 comme aux longs flux agentiques. Ce n’est pas le chiffre le plus élevé qu’ils donnent : ils estiment DeepSeek-R1 seul à 10,6 Wh en médiane (écart interquartile de 4,29 à 21,7), qu’ils jugent cohérent avec une mesure tierce, celle de ML.ENERGY, de 20,9 Wh en médiane pour une requête moyenne de 11 287 tokens de sortie ; le passage qui donne ces 10,6 Wh ne précise pas la longueur de sortie retenue, ce chiffre n’est donc pas comparable terme à terme au facteur 13. Ce que la méthode interprète de cet écart, non formulée en ces termes par Oviedo et al. eux-mêmes (leur modèle porte sur le débit de tokens, pas sur une narration causale du raisonnement) : chaque étape de raisonnement intermédiaire explorée avant la réponse finale ajoute des tokens à générer, et donc du calcul et de l’énergie. Le facteur d’environ 13 reste inférieur au rapport des longueurs de sortie médianes, 5 000 sur 300, soit environ 17 par mon calcul (les auteurs parlent, eux, d’une requête quinze fois plus longue) : il chiffre le coût d’une sortie plus longue, pas une propriété observée du raisonnement lui-même. Le détail de cette estimation, ses limites et ses implications pour un usage à grande échelle sont traités dans la fiche dédiée : voir Le coût énergétique d’une requête LLM.
Pour quelle tâche, concrètement
Ce que le rapport écrit. Sur des examens de mathématiques et de programmation compétitive, les éditeurs rapportent des gains nets pour leurs propres modèles. Dans l’annexe de l’annonce d’OpenAI, o1-preview résout 44,6 % des problèmes de l’examen AIME 2024 en un seul essai, contre 9,3 % pour GPT-4o. DeepSeek donne DeepSeek-R1 à 79,8 sur ce même examen contre 39,2 pour DeepSeek-V3, et à 2029 contre 1134 en classement Codeforces. Sur le génie logiciel, le même papier écrit en revanche que R1 « has not demonstrated a huge improvement over DeepSeek-V3 on software engineering benchmarks », et range l’usage d’outils parmi les limites du modèle. Il reconnaît aussi que sa méthode de décontamination par n-grammes « cannot prevent the paraphrase of testset », de sorte que les bancs publiés avant 2024 peuvent, selon lui, souffrir de contamination. Aucune de ces évaluations n’a été ré-exécutée par un tiers dans les sources réunies pour cette fiche.
Ce que la méthode interprète, à partir des éléments disponibles. Ce surcoût n’a de sens que rapporté à la tâche. Les LLM de raisonnement ciblent surtout les tâches à contrainte stricte, comme une démonstration mathématique ou un problème de code avec une seule solution correcte. Pour la conversation générale, la rédaction, le résumé ou l’assistance courante, un LLM standard suffit probablement et consomme moins d’énergie par requête ; je n’ai identifié, dans les sources réunies pour cette fiche, aucune étude mesurant une éventuelle perte de qualité perçue par l’utilisateur sur ces usages, dans un sens ou dans l’autre. Router toute requête vers un modèle de raisonnement par défaut a un coût énergétique : Oviedo et al. (2026) estiment que les modèles qui permettent d’activer ou de désactiver explicitement le raisonnement peuvent réduire l’énergie par requête d’un facteur 5 ou plus, du fait de requêtes plus courtes. À l’échelle, ils chiffrent un milliard de requêtes par jour à 0,7 GWh, à 1,7 GWh si 10 % sont des requêtes longues, ramenés à 0,8 GWh avec des interventions d’efficacité ; en jouant sur les modèles, les systèmes de service et le matériel, ils estiment à portée des réductions d’énergie d’un facteur 8 à 20. Leur conclusion ajoute que beaucoup de tâches ne requièrent pas les modèles les plus énergivores, les performances montrant souvent des rendements décroissants au-delà d’une certaine quantité de test-time compute. À ce coût énergétique s’ajoute, de mon interprétation, un temps de réponse plus long (le calcul intermédiaire s’exécute avant que la réponse ne commence à s’afficher).
Quand router vers un modèle de raisonnement : un calcul, pas une intuition
Ce que le rapport écrit. Dans son annonce d’o1, datée du 12 septembre 2024, OpenAI a publié, sur son propre modèle et sans réplication indépendante identifiée à ce jour, une comparaison avec GPT-4o sur l’examen AIME 2024, un concours de mathématiques. Dans le corps du texte, GPT-4o résout en moyenne 12 % des problèmes, et o1 74 % en un seul essai. L’annexe A du même document donne, dans un tableau distinct pour le même examen en pass@1, GPT-4o à 9,3 %, o1-preview à 44,6 % et o1 à 74,4 % ; le document ne réconcilie pas le 12 % et le 9,3 % attribués à GPT-4o, ni n’explique la méthode de chacun des deux tableaux.
Ce que la méthode interprète, calcul original. Pour comparer deux modèles sur la même mesure, je retiens les deux chiffres du même tableau de l’annexe, 9,3 % pour GPT-4o et 44,6 % pour o1-preview, plutôt que de mélanger les deux tableaux de la source. Mon calcul repose sur trois hypothèses : la tâche a une réponse vérifiable automatiquement, les essais successifs sont indépendants, et le taux de réussite est le même d’un problème à l’autre. Sous ces hypothèses, le nombre moyen d’essais nécessaires pour obtenir une bonne réponse est l’inverse du taux de réussite : environ 10,75 essais pour GPT-4o (1 / 0,093), contre environ 2,24 pour o1-preview (1 / 0,446), soit un rapport d’environ 4,8 (10,75 / 2,24). o1-preview revient donc moins cher par bonne réponse tant qu’une tentative lui coûte moins de 4,8 fois une tentative de GPT-4o, et plus cher au-delà. Ce coût par tentative ne se lit pas sur le tarif au token : chez OpenAI, la chaîne de raisonnement est facturée comme des tokens de sortie, et sa longueur varie d’une requête à l’autre (voir mes réserves).
Le seuil de décision qui en découle est transposable dans sa logique, pas dans ses chiffres : sous les mêmes hypothèses, router vers un modèle de raisonnement devient avantageux quand le rapport des taux de réussite dépasse le rapport des coûts par tentative, tokens de raisonnement compris. Ce rapport des taux ne peut pas dépasser l’inverse du taux du modèle standard : si celui-ci réussit déjà 80 % du temps, il plafonne à 1,25 (1 / 0,8), et le modèle de raisonnement n’a presque plus de marge.
Mes réserves
- Frontière mouvante. La distinction entre “LLM standard” et “LLM de raisonnement” évolue vite. Oviedo et al. (2026) évoquent déjà des modèles qui permettent d’activer ou de désactiver explicitement le raisonnement, ce qui rend approximative la distinction binaire présentée ici.
- Noms datés. Les noms de produits cités ici (o1, o3, DeepSeek-R1) datent de la rédaction de cet article et changeront. Ce qui compte pour comprendre le principe n’est pas le nom du modèle en cours à une date donnée, mais le mécanisme sous-jacent : un calcul étendu mobilisé au moment de répondre, pas pendant l’entraînement. Un lecteur qui retrouve cet article après la sortie de nouveaux modèles devrait pouvoir transposer directement.
- Une estimation, pas une constante. Les chiffres énergétiques cités (0,31 Wh contre 3,91 Wh) viennent d’une estimation publiée en 2026. Ses auteurs, tous salariés de Microsoft, jugent surestimées d’un facteur 4 à 20 des estimations et mesures tierces de la consommation par requête faites dans des déploiements non optimisés ; ce facteur rapporte ces valeurs à la sortie de leur propre modèle, pas à une consommation de production observée.
- Sous-estimation probable des requêtes longues. Les auteurs écrivent que leur modèle de débit suppose un plateau pour les très longues générations, alors que les systèmes réels déclinent souvent, ce qui conduit probablement, selon eux, à sous-estimer l’énergie dans ces cas. Ce passage ne chiffre pas ce qu’est une très longue génération : c’est un biais qui pourrait toucher la queue du scénario long.
- Pas un plafond. Le facteur d’environ 13 est un rapport de médianes entre deux longueurs de sortie pour un panel de trois modèles. Les auteurs écrivent qu’une part importante des requêtes du scénario long dépasse 10 Wh, et ils estiment DeepSeek-R1 seul à 10,6 Wh en médiane, sur une longueur de sortie que le passage ne précise pas.
- Tâche vérifiable seulement. Le calcul par bonne réponse ne vaut que pour une tâche à réponse vérifiable automatiquement (un résultat numérique, un test qui passe) : il ne s’applique pas à une tâche de rédaction ou d’analyse ouverte, où “relancer jusqu’à réussite” n’a pas de sens.
- Essais indépendants et taux homogène. Le modèle “essais ≈ 1 / taux de réussite” suppose des essais indépendants. Si les échecs sont corrélés d’un essai à l’autre (même angle mort, même mécompréhension de l’énoncé qui se répète), le nombre réel d’essais nécessaires est plus élevé que ce calcul simplifié ne le prédit. Il suppose aussi un taux de réussite homogène : un taux moyen de 9,3 % peut recouvrir des problèmes toujours résolus et d’autres jamais, sur lesquels relancer n’aide pas.
- Coût par tentative inconnu. En septembre 2026, o3 est affiché par OpenRouter, qui transmet ses requêtes à OpenAI, à 2 $/M tokens en entrée et 8 $/M en sortie. OpenAI écrit que les tokens de raisonnement sont facturés comme tokens de sortie, et sa documentation évoque de quelques centaines à des dizaines de milliers de tokens de raisonnement, sans publier de rapport entre tokens de raisonnement et tokens visibles. Le coût par tentative d’un modèle de raisonnement ne se déduit donc pas de son tarif au token : il se mesure sur la tâche, modèle par modèle.
Retour au dossier « Comprendre les modèles post-LLM ». Voir aussi les fiches sœurs : Test-time compute : pourquoi certains modèles “réfléchissent” et Le coût énergétique d’une requête LLM.
ISP-IA16/100· 0-30 % · Preuves très limitées · Cinq entrées. Le facteur d'environ 13 vient d'une seule d'entre elles, Oviedo et ses coauteurs, dont les huit signatures portent la même adresse Microsoft : c'est un cadre ascendant qui échantillonne 10 000 configurations de longueur de sortie, de puissance de nœud et de rendement d'infrastructure, jamais un relevé de compteur, et il situe la médiane à 0,31 Wh par requête, écart interquartile de 0,16 à 0,60, pour un panel de trois modèles à poids ouverts de plus de 200 milliards de paramètres sur des nœuds H100, contre 3,91 Wh, écart interquartile de 2,15 à 7,05, dans un scénario de sortie longue, 5 000 tokens médians contre 300, que les auteurs décrivent comme quinze fois plus long que la requête type. Aucune des quatre autres entrées ne chiffre une consommation d'énergie : sur ce point, la source est unique. Deux entrées chiffrent en revanche le même objet, le taux de réussite en un seul essai sur l'examen AIME 2024 : l'annonce d'OpenAI et le papier de DeepSeek donnent tous deux GPT-4o à 9,3 %, et chacun chiffre une version d'o1 sur cet examen. DeepSeek reprend les scores d'o1-1217 des rapports officiels d'OpenAI, faute d'accès à son API ; pour GPT-4o, le dossier ne dit pas si le 9,3 % de DeepSeek est une reprise ou une ré-exécution, et les deux versions d'o1 chiffrées ne sont pas le même modèle : la convergence ne se mesure pas davantage ici. OpenRouter reprend le tarif d'OpenAI et n'en est pas indépendante ; la documentation développeur d'OpenAI décrit sa propre facturation. Les deux valeurs non réconciliées de l'annonce d'OpenAI pour GPT-4o sur la même mesure nominale, 12 % au corps du texte et 9,3 % en annexe, sont un écart interne à une source unique, pas un désaccord entre deux sources. Le type de preuve est celui de la transposition : un cadre d'estimation assemblé à partir d'hypothèses de matériel et de charge, qui n'est pas une mesure physique, et un calcul de seuil par bonne réponse qui est le mien. La réplication est nulle : ni l'estimation énergétique ni les taux de réussite publiés par OpenAI et DeepSeek n'ont été ré-exécutés par un tiers dans ce dossier. L'axe puissance se note sur les unités observées, et l'examen qui porte les taux de réussite compte quinze problèmes.
L'Indice de solidité des preuves évalue la base empirique de cette analyse sur quatre critères pondérés : type de preuve (40 %), convergence (30 %), réplication (20 %), puissance (10 %). L'axe type de preuve est calibré par champ : 100 y désigne le meilleur dispositif que l'échelle ISP-IA sache produire, et non une preuve absolue.
Cinq entrées. Le facteur d'environ 13 vient d'une seule d'entre elles, Oviedo et ses coauteurs, dont les huit signatures portent la même adresse Microsoft : c'est un cadre ascendant qui échantillonne 10 000 configurations de longueur de sortie, de puissance de nœud et de rendement d'infrastructure, jamais un relevé de compteur, et il situe la médiane à 0,31 Wh par requête, écart interquartile de 0,16 à 0,60, pour un panel de trois modèles à poids ouverts de plus de 200 milliards de paramètres sur des nœuds H100, contre 3,91 Wh, écart interquartile de 2,15 à 7,05, dans un scénario de sortie longue, 5 000 tokens médians contre 300, que les auteurs décrivent comme quinze fois plus long que la requête type. Aucune des quatre autres entrées ne chiffre une consommation d'énergie : sur ce point, la source est unique. Deux entrées chiffrent en revanche le même objet, le taux de réussite en un seul essai sur l'examen AIME 2024 : l'annonce d'OpenAI et le papier de DeepSeek donnent tous deux GPT-4o à 9,3 %, et chacun chiffre une version d'o1 sur cet examen. DeepSeek reprend les scores d'o1-1217 des rapports officiels d'OpenAI, faute d'accès à son API ; pour GPT-4o, le dossier ne dit pas si le 9,3 % de DeepSeek est une reprise ou une ré-exécution, et les deux versions d'o1 chiffrées ne sont pas le même modèle : la convergence ne se mesure pas davantage ici. OpenRouter reprend le tarif d'OpenAI et n'en est pas indépendante ; la documentation développeur d'OpenAI décrit sa propre facturation. Les deux valeurs non réconciliées de l'annonce d'OpenAI pour GPT-4o sur la même mesure nominale, 12 % au corps du texte et 9,3 % en annexe, sont un écart interne à une source unique, pas un désaccord entre deux sources. Le type de preuve est celui de la transposition : un cadre d'estimation assemblé à partir d'hypothèses de matériel et de charge, qui n'est pas une mesure physique, et un calcul de seuil par bonne réponse qui est le mien. La réplication est nulle : ni l'estimation énergétique ni les taux de réussite publiés par OpenAI et DeepSeek n'ont été ré-exécutés par un tiers dans ce dossier. L'axe puissance se note sur les unités observées, et l'examen qui porte les taux de réussite compte quinze problèmes.
- L'énergie par requête serait relevée au compteur sur des requêtes réelles, avec une sortie courte puis une sortie longue, avec le protocole et le code publiés, plusieurs exécutions et un intervalle, au lieu d'un échantillonnage de configurations de longueur de sortie, de puissance de nœud et de rendement d'infrastructure.Un opérateur d'inférence, ou une équipe académique disposant d'un banc instrumenté · personne ne l’a produit
- Les taux de réussite comparés sur l'examen AIME 2024 seraient ré-exécutés par une équipe sans intérêt dans les modèles comparés, avec plusieurs graines et un intervalle, de sorte que la comparaison ne repose plus sur des chiffres publiés par le fournisseur de l'un des deux modèles.Une équipe d'évaluation sans intérêt dans les modèles comparés · personne ne l’a produit
- Le rapport entre tokens de raisonnement, facturés comme tokens de sortie, et tokens visibles serait publié par tâche : la documentation développeur décrit la règle de facturation et une fourchette de volume, sans ce rapport.OpenAI · existe, mais n’est pas consultable
Ce dispositif porterait l'indice à 22 sur 100, dans le palier « Preuves très limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Score de 16/100 (0-30 %) établi le 18 septembre 2026.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- LLM· Grand modèle de langage↗
- Modèle d'intelligence artificielle entraîné sur de vastes corpus de texte pour prédire et générer du langage, capable de tâches d'analyse, de synthèse et de génération de texte en langage naturel sans avoir été explicitement programmé pour la tâche demandée.
Modification apportée · mis à jour le 24 septembre 2026
Relecture du 2026-09-24. J'ai retiré le calcul « coût par bonne réponse » fondé sur un tarif d'o1-preview six fois supérieur à celui de GPT-4o : ce tarif ne figurait dans aucune des sources réunies, la page d'annonce citée n'en donnant aucun, et la phrase écrivait en outre « facteur 6, soit 600 % plus cher », alors qu'un facteur 6 fait 500 %. Le résultat « environ 25 % plus cher par bonne réponse » disparaît avec lui ; je le remplace par un seuil qui ne dépend d'aucun tarif (environ 4,8 fois le coût d'une tentative de GPT-4o), sous trois hypothèses désormais nommées au lieu d'une seule. J'écrivais que les auteurs de l'estimation énergétique « mesurent » : ils estiment, par simulation. J'écrivais « l'estimation la plus récente disponible » sans source qui classe la littérature par date, et « modèles de frontière » là où l'étude simule trois modèles à poids ouverts. Les libellés « régime de raisonnement étendu », dans le texte comme dans la figure, deviennent des longueurs de sortie (300 contre 5 000 tokens médians), parce que le scénario long de l'étude couvre aussi les longs flux agentiques. J'ai retiré, faute de source : une étude de mai 2025 donnant un facteur supérieur à 70, mon estimation d'un surcoût de 3 à 10 fois le tarif affiché, l'idée qu'un LLM standard suffit à « la grande majorité des usages », celle d'un nom imposé « pour sa force commerciale » et celle de « plusieurs autres fournisseurs ». Le brouillon masqué est désormais attribué à OpenAI seule. Les étiquettes de niveau de preuve des deux premières sections annonçaient des données là où le texte décrit ou interprète. J'ai ajouté ce que les sources portaient et que la pièce ne disait pas : les scores publiés par DeepSeek sur AIME 2024 et Codeforces, sa propre réserve sur le génie logiciel, la sous-estimation probable que les auteurs de l'estimation énergétique reconnaissent pour les très longues générations. La note de convergence reconnaît maintenant que l'annonce d'OpenAI et le papier de DeepSeek chiffrent le même taux de réussite, sans être indépendants sur ce point. Dans la même relecture, j'ai corrigé cinq glissements. Le sous-titre répondait au titre par « environ treize fois plus d'énergie par requête », comme si ce facteur caractérisait les LLM de raisonnement : l'estimation compare deux longueurs de sortie pour un panel de trois modèles, dans un régime long que ses auteurs associent aux modèles de raisonnement comme aux longs flux agentiques. La description disait que o1, o3 et DeepSeek-R1 coûtent « nettement plus cher en énergie » : aucun modèle propriétaire n'est simulé dans cette estimation. Le résumé, l'encadré et le corps prêtaient à toute chaîne de raisonnement, y compris celle qu'OpenAI ne montre pas, l'exploration de pistes et les retours en arrière que DeepSeek décrit pour sa seule variante R1-Zero. J'écrivais « une requête environ quinze fois plus longue » et que le facteur 13 « suit de près » ce rapport : quinze est la formule des auteurs, alors que les médianes de sortie qu'ils publient, 5 000 et 300 tokens, donnent par mon calcul environ 16,7, et le facteur 13 reste en dessous. Je rattachais enfin la sous-estimation que les auteurs reconnaissent pour les très longues générations au scénario à 5 000 tokens médians, ce que leur texte ne fait pas. J'ai retiré, faute de source, la description du fonctionnement de GPT-4o et l'idée qu'un LLM standard est « rapide et peu coûteux ». J'ai ajouté ce que les sources portaient : la réserve de DeepSeek sur la contamination possible des bancs publiés avant 2024, le chiffrage des auteurs de l'estimation à un milliard de requêtes par jour et les réductions de 8 à 20 fois qu'ils jugent à portée. L'indice ne change pas. L'encadré sur le coût d'une bonne réponse partait du tarif affiché, que le reste de la fiche écarte : il part maintenant du coût d'une tentative. Je ne présente plus la reprise des scores d'o1-1217 par DeepSeek comme valant pour GPT-4o. Le « un seul essai » ne s'applique qu'à o1, comme dans l'annonce d'OpenAI. L'écart de 4 à 20 vise aussi des mesures faites dans des déploiements non optimisés, et plus seulement des estimations. J'ai retiré un gain de fiabilité que je prêtais aux modèles de raisonnement sur des tâches où aucune source ne le mesure.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus