Jamba remplace-t-il l'attention par Mamba ?
 Axel Morel · Fondateur & analyste, Probans
L'essentiel
Un modèle hybride n'élimine pas l'attention : il la combine avec des composants à espace d'états : blocs Mamba en alternance chez Jamba, module d'attention partagé chez Zamba, agencement non détaillé pour Bamba, têtes SSM en parallèle dans une même couche chez Hymba. AI21 Labs présente Jamba comme le premier modèle de ce type prêt pour la production.
- Un hybride n'élimine pas l'attention : Jamba l'alterne avec Mamba. Jamba, présenté par AI21 Labs en mars 2024, alterne dans le même réseau des blocs Mamba et des blocs d'attention classique. Le modèle publié compte 52 milliards de paramètres au total, dont 12 milliards actifs à l'inférence grâce à un mélange d'experts, une fenêtre de contexte de 256 000 tokens, et des poids publiés sous licence Apache 2.0.
- Le x3 vient du fabricant, pas d'un tiers. Selon la mesure publiée par AI21 Labs elle-même, Jamba affiche un débit environ trois fois supérieur sur les contextes longs face à Mixtral 8x7B, un modèle Transformer à mixture d'experts de taille comparable, pas à un Transformer générique non identifié, un chiffre qu'aucune des sources réunies ici ne reproduit.
- AI21 (Jamba), Zyphra (Zamba) et NVIDIA avec Hymba combinent les deux mécanismes différemment. Zyphra (Zamba) partage un seul bloc d'attention entre plusieurs couches du réseau plutôt que d'en dédier un à chacune, pour obtenir les bénéfices de l'attention à un coût minimal en paramètres. Dans Hymba, des têtes d'attention et des têtes SSM tournent en parallèle dans la même couche, plutôt qu'en couches alternées comme chez Jamba, ou qu'en un module d'attention unique partagé comme chez Zamba.
Non : Jamba alterne des blocs Mamba et des blocs d’attention dans le même réseau, et le débit supérieur qu’on lui associe est un chiffre publié par AI21 Labs sur son propre modèle. Un article précédent de ce dossier explique ce qu’est Mamba : une architecture qui remplace le mécanisme d’attention par un état interne de taille fixe, pour garder un coût de calcul linéaire plutôt que quadratique sur les contextes longs. Pour mémoire en une phrase : un bloc d’attention relit tout le texte déjà généré à chaque nouveau mot, un bloc Mamba se contente de mettre à jour un état interne de taille fixe, sans relire. Je ne reviens pas plus loin sur cette mécanique : je réponds ici à une autre question, plus concrète. À quoi ressemble un modèle qui combine Mamba et attention, et qu’est-ce que ça change par rapport à un remplacement pur et simple du Transformer ?
Hybride ne veut pas dire “à la place de”
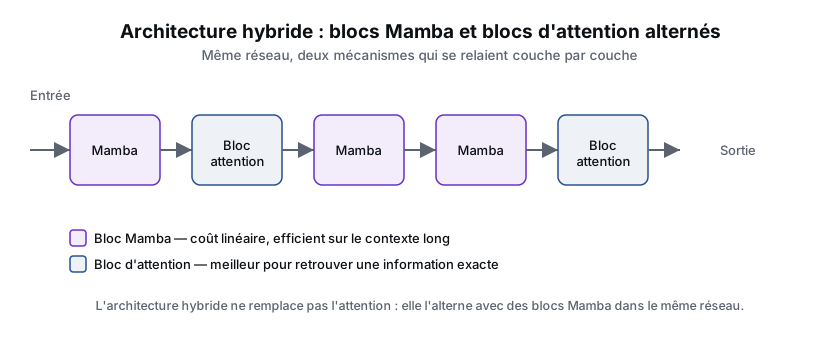
Ce que le fabricant écrit. Jamba, présenté par AI21 Labs en mars 2024, alterne dans le même réseau des blocs Mamba et des blocs d’attention classique. Certaines couches du modèle traitent le texte avec le balayage séquentiel de Mamba, d’autres continuent d’utiliser l’attention traditionnelle. Le modèle publié compte 52 milliards de paramètres au total, dont 12 milliards actifs à l’inférence grâce à un mélange d’experts, une fenêtre de contexte de 256 000 tokens, et des poids publiés sous licence Apache 2.0.
Ce que la méthode interprète. AI21 Labs revendique elle-même explicitement, dans son annonce, que Jamba est « the world’s first production-grade Mamba based model » : ce n’est donc pas une inférence prudente tirée des dates de publication, mais une auto-revendication directe du fabricant, pas un fait établi par un tiers indépendant. Le papier fondateur de Jamba date de mars 2024 ; les autres architectures hybrides mentionnées plus loin dans cette fiche (Bamba, Granite 4.0, Zamba, Hymba, Nemotron-H) sont toutes documentées par des publications postérieures, ce qui est cohérent avec cette antériorité sans la démontrer par une source tierce. Si un hybride antérieur destiné à la production existe hors de cette cartographie, l’antériorité revendiquée par AI21 tomberait. Ce choix d’architecture a par ailleurs une logique simple une fois qu’on la regarde en face : les deux mécanismes n’ont pas les mêmes forces. Mamba est efficient sur le contexte long, avec un coût de calcul qui reste linéaire quand le texte s’allonge. Dans Hymba, NVIDIA attribue à l’attention un rappel « haute résolution » ; AI21 dit viser les avantages des deux familles sans les détailler. Un modèle purement Transformer resterait coûteux sur le contexte long. L’architecture hybride est un compromis d’ingénierie assumé, pas une demi-mesure : elle vise à cumuler les deux avantages plutôt qu’à trancher entre eux.
Le chiffre qui rend ce compromis concret
Ce que le fournisseur revendique. Selon la mesure publiée par AI21 Labs elle-même, Jamba affiche un débit environ trois fois supérieur sur les contextes longs face à Mixtral 8x7B, un modèle Transformer à mixture d’experts de taille comparable, pas à un Transformer générique non identifié, un chiffre qu’aucune des sources réunies ici ne reproduit. Le billet d’AI21 ne précise pas la longueur de contexte de cette mesure ; Mixtral 8x7B, le comparateur, a été entraîné avec un contexte de 32 000 tokens. C’est un gain revendiqué par AI21, sans méthodologie de benchmark détaillée dans son billet d’annonce, sur un modèle dont les poids sont publiés sous licence Apache 2.0, et que son éditeur présente comme prêt pour la production : cette présentation reste, comme plus haut, une revendication du fabricant.
Ce que la méthode interprète. Ce x3 mérite d’être resitué à côté d’un autre chiffre : le papier fondateur de Mamba, signé Gu et Dao, annonce pour sa part 4 à 5 fois le débit d’inférence d’un Transformer de taille comparable, face à l’implémentation Transformer standard de Hugging Face, sur des prompts de 2 048 tokens, et l’un des deux modèles Mamba servant à ce calcul n’était pas entraîné. Les deux chiffres ne se comparent pas : comparateurs et configurations diffèrent.
Ce qui entoure ce chiffre, sans le recouper. Le x3 reste une mesure publiée par AI21 Labs elle-même. Deux éléments extérieurs permettent de le resituer sans le prendre pour acquis. Artificial Analysis, cabinet de benchmarking tiers sans lien commercial déclaré avec AI21, a chronométré le débit de sortie de Jamba 1.5 Mini sur 10 000 tokens de contexte, mais sans classement comparatif publié face à d’autres modèles : cette page ne mesure qu’un hébergeur, Amazon Bedrock, et ne compare pas Jamba à un Transformer. NVIDIA revendique de son côté pour sa propre famille hybride Nemotron-H un gain « jusqu’à 3 fois » à l’inférence face à des Transformers comparables.
Ce que la méthode interprète. Ni l’un ni l’autre ne réplique le chiffre précis de Jamba : Artificial Analysis ne teste pas le multiplicateur x3, et Nemotron-H est un modèle différent mesuré par son propre éditeur. Le premier élément montre seulement qu’un tiers a chronométré Jamba 1.5 Mini, un modèle ultérieur de la même famille, sans le comparer à un concurrent. Le second dit qu’un autre laboratoire, sur une autre architecture hybride, revendique un gain d’inférence pouvant aller jusqu’à 3 fois, un plafond et non une valeur comparable au x3 d’AI21. Il faut le prendre pour ce qu’il est : NVIDIA mesure son propre modèle et vend par ailleurs du matériel d’inférence, elle a donc un intérêt direct à ce que le chiffre soit élevé. Ce n’est pas un recoupement tiers, c’est une seconde revendication d’acteur intéressé, sur une architecture voisine. Ce chiffre porte sur un autre modèle, face à d’autres comparateurs : comme celui de Gu et Dao, il ne se compare pas au x3 d’AI21, qu’il ne soutient ni ne contredit. Le x3 reste une revendication de fabricant, qu’aucune mesure tierce de la même grandeur ne vient étayer.
Jamba n’est pas un cas isolé, en une phrase
D’autres organisations ont elles aussi combiné modèles à espace d’états et attention, selon d’autres agencements. IBM Research (Bamba, précurseur direct de Granite 4.0) combine attention et Mamba2 ; Granite 4.0 H-Small, dérivé de Bamba, compte 4 couches d’attention pour 36 couches Mamba2, le ratio de Bamba lui-même n’est pas documenté dans le billet d’IBM, et l’agencement de ces couches dans le réseau n’est décrit par aucune des deux sources. Zyphra (Zamba) partage un seul bloc d’attention entre plusieurs couches du réseau plutôt que d’en dédier un à chacune, pour obtenir les bénéfices de l’attention à un coût minimal en paramètres. NVIDIA (Hymba) va plus loin : dans Hymba, des têtes d’attention et des têtes SSM tournent en parallèle dans la même couche, chaque type de tête gardant son rôle propre (rappel précis pour l’attention, résumé de contexte pour les têtes SSM), plutôt qu’en couches alternées comme chez Jamba, ou qu’en un module d’attention unique partagé comme chez Zamba. Le détail complet de chacune dépasse le cadre de cette fiche.
Ce que l’utilisateur final ne voit généralement pas
Ce que la méthode interprète. L’architecture n’apparaît généralement pas dans l’interface d’un produit. Ce qui change, c’est ce qui se passe en coulisses : le coût de calcul pour faire tourner le modèle sur un contexte long, et éventuellement la vitesse de réponse.
Une architecture hybride n’est pas un compromis bancal entre deux logiques : c’est un choix d’ingénierie que plusieurs laboratoires ont fait, mesurable dans son coût de calcul.
Mes réserves
- Le gain de débit n’est pas universel. Une étude de reclassement de documents (arXiv:2412.14354) trouve Mamba pur, sans blocs d’attention, moins efficace à l’entraînement et à l’inférence qu’un Transformer avec flash attention, sur cette tâche précise. Sur la qualité, les mêmes auteurs trouvent Mamba compétitif face à des Transformers de taille comparable, et ils attribuent l’écart d’inférence principalement au fait que le reclassement ne demande qu’une seule passe avant, là où la génération autorégressive en demande plusieurs. Ce résultat porte sur Mamba seul, pas sur une architecture hybride : rien n’indique s’il tient encore une fois des blocs d’attention réintroduits, comme chez Jamba. Il rappelle en tout cas que le gain de débit ne se transpose pas automatiquement à toute tâche ou toute configuration.
- À l’entraînement, NVIDIA mesure un taux d’utilisation du GPU, pas une vitesse. Une étude empirique de NVIDIA (arXiv:2406.07887) mesure la MFU (utilisation du GPU à l’entraînement) sur un hybride Mamba-2/Transformer de 8 milliards de paramètres : 29,9 %, contre 30,7 % pour un Transformer comparable. L’écart est faible, moins d’un point. Sur deux autres résultats de son résumé, cette même étude est favorable à l’hybride : il dépasse le Transformer de 8 milliards de paramètres sur les douze tâches standard évaluées, de 2,65 points en moyenne, et ses auteurs prédisent une génération jusqu’à huit fois plus rapide à l’inférence, une prédiction et non une mesure.
- Le x3 de Jamba provient de la publication d’AI21 Labs elle-même. Il n’a pas été reproduit tel quel par un tiers qui aurait directement chronométré Jamba face à Mixtral 8x7B dans les mêmes conditions ; ce dont je dispose, c’est d’une mesure du débit de Jamba 1.5 Mini par un tiers sans lien commercial déclaré avec AI21 (Artificial Analysis, sans classement comparatif) et d’une revendication de NVIDIA, pour son propre modèle Nemotron-H face à d’autres Transformers, d’une inférence jusqu’à 3 fois plus rapide ; NVIDIA vend par ailleurs du matériel d’inférence. Un lecteur qui a besoin du chiffre exact pour un dimensionnement d’infrastructure doit le vérifier sur son propre cas d’usage plutôt que retenir le x3 comme une constante.
Ce qu’il faut demander à un fournisseur de LLM, concrètement
La question “utilisez-vous Mamba” n’est pas la bonne. Quatre questions le sont davantage.
- Le gain annoncé porte-t-il sur l’entraînement ou sur l’inférence ?
- Sur quelle tâche et quelle longueur de contexte le gain a été mesuré ? Un gain revendiqué sur les contextes longs ne se transpose pas automatiquement à toute tâche : une étude indépendante de reclassement de documents trouve Mamba pur moins efficace à l’entraînement et à l’inférence sur cette tâche (voir plus haut).
- Quel est le coût par token et l’empreinte mémoire du cache d’état à la longueur de contexte visée ? Ces deux métriques se demandent directement au fournisseur qui héberge le modèle, pas au multiplicateur de débit affiché en communication.
- Le gain de débit ou de coût s’accompagne-t-il d’une perte de qualité mesurable sur des bancs d’essai standards ? Le résumé du papier d’AI21 revendique pour Jamba des performances « state-of-the-art » sur les bancs standards et en contexte long, sans chiffre à cet endroit ; aucune autre source citée ici ne documente ce compromis pour Jamba : à demander directement au fournisseur, sur ses propres résultats de qualité, pas seulement sur son débit.
Un gain annoncé pour une architecture hybride se vérifie à la longueur de contexte et sur la tâche visées ; aucune source citée ici ne mesure le gain de débit d’un hybride tâche par tâche.
Retour au dossier « Comprendre les modèles post-LLM ». Voir aussi Qu’est-ce que Mamba ?.
ISP-IA16/100· 0-30 % · Preuves très limitées · Le fait central de cette page est un rapport de débit, environ trois fois, entre Jamba et Mixtral 8x7B sur contexte long. Il est publié par AI21 Labs sur son propre modèle, dans un billet d'annonce qui ne précise pas la longueur de contexte de la mesure et ne l'accompagne d'aucune méthodologie de benchmark détaillée : c'est une démonstration de fabricant, et le type de preuve retenu est celui du cas unique documenté. Le plafond de partie prenante joue ici en plus du reste, puisque dix des douze entrées de la bibliographie sont des laboratoires qui décrivent leurs propres modèles. La convergence n'est pas mesurable, et c'est le troisième cas du barème : les mesures disponibles ne portent pas sur le même objet. AI21 chronomètre Jamba contre Mixtral 8x7B ; NVIDIA revendique « jusqu'à 3 fois » pour Nemotron-H, un autre modèle, contre des Transformers qu'elle choisit, et vend par ailleurs du matériel d'inférence ; Artificial Analysis mesure bien Jamba 1.5 Mini sans lien commercial déclaré avec AI21, mais ne mesure qu'un hébergeur, Amazon Bedrock, et ne publie aucun rapport à un Transformer. Deux revendications voisines sur deux produits différents font un air de famille, pas un recoupement, et la seule mesure tierce ne mesure pas la grandeur revendiquée. La réplication est nulle : aucune source citée ne rejoue la comparaison Jamba contre Mixtral 8x7B ; une étude indépendante trouve Mamba pur moins efficient que des Transformers avec flash attention en reclassement de textes, à qualité comparable, sans que rien n'indique que ce résultat vaille pour un hybride. La puissance d'échantillon n'a pas d'objet : les unités de ce dossier sont une dizaine de publications et de fiches de modèle nommées, pas une population d'observations.
L'Indice de solidité des preuves évalue la base empirique de cette analyse sur quatre critères pondérés : type de preuve (40 %), convergence (30 %), réplication (20 %), puissance (10 %). L'axe type de preuve est calibré par champ : 100 y désigne le meilleur dispositif que l'échelle ISP-IA sache produire, et non une preuve absolue.
Le fait central de cette page est un rapport de débit, environ trois fois, entre Jamba et Mixtral 8x7B sur contexte long. Il est publié par AI21 Labs sur son propre modèle, dans un billet d'annonce qui ne précise pas la longueur de contexte de la mesure et ne l'accompagne d'aucune méthodologie de benchmark détaillée : c'est une démonstration de fabricant, et le type de preuve retenu est celui du cas unique documenté. Le plafond de partie prenante joue ici en plus du reste, puisque dix des douze entrées de la bibliographie sont des laboratoires qui décrivent leurs propres modèles. La convergence n'est pas mesurable, et c'est le troisième cas du barème : les mesures disponibles ne portent pas sur le même objet. AI21 chronomètre Jamba contre Mixtral 8x7B ; NVIDIA revendique « jusqu'à 3 fois » pour Nemotron-H, un autre modèle, contre des Transformers qu'elle choisit, et vend par ailleurs du matériel d'inférence ; Artificial Analysis mesure bien Jamba 1.5 Mini sans lien commercial déclaré avec AI21, mais ne mesure qu'un hébergeur, Amazon Bedrock, et ne publie aucun rapport à un Transformer. Deux revendications voisines sur deux produits différents font un air de famille, pas un recoupement, et la seule mesure tierce ne mesure pas la grandeur revendiquée. La réplication est nulle : aucune source citée ne rejoue la comparaison Jamba contre Mixtral 8x7B ; une étude indépendante trouve Mamba pur moins efficient que des Transformers avec flash attention en reclassement de textes, à qualité comparable, sans que rien n'indique que ce résultat vaille pour un hybride. La puissance d'échantillon n'a pas d'objet : les unités de ce dossier sont une dizaine de publications et de fiches de modèle nommées, pas une population d'observations.
- Le débit de Jamba et celui de Mixtral 8x7B seraient chronométrés côte à côte, sur le même matériel et la même longueur de contexte, par une équipe sans lien avec AI21 ni avec un vendeur de matériel d'inférence, avec plusieurs graines et un intervalle publié.Un cabinet d'évaluation ou une équipe académique disposant des deux modèles et d'un banc identique · un dispositif approchant existe, sans remplir la condition
- Une ablation indépendante isolerait ce qui, dans le gain de débit revendiqué, tient à l'alternance Mamba/attention plutôt qu'au mélange d'experts, en rejouant l'architecture à partir des poids publiés sous licence Apache 2.0.Une équipe sans lien avec AI21, à partir des poids publiés · un dispositif approchant existe, sans remplir la condition
- Le compromis de qualité associé à ce gain serait mesuré sur des bancs d'essai administrés par un tiers.Un évaluateur tiers disposant d'un jeu de test hors entraînement · personne ne l’a produit
Ce dispositif porterait l'indice à 36 sur 100, dans le palier « Preuves limitées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Effectif observé : L'effectif observé n'a pas d'objet ici : les unités sont une dizaine de publications et de fiches de modèle nommées, pas une population d'observations. Cet axe ne bougerait que si la question posée cessait d'être ce que les laboratoires annoncent de leurs architectures pour devenir ce que ces architectures produisent, mesuré sur une série de déploiements.
Score de 16/100 (0-30 %) établi le 18 septembre 2026.
I source primaire indépendante · S secondaire spécialisée · P partie prenante ayant un intérêt commercial sur le sujet traité.
Lexique
- Transformer↗
- Architecture de réseau de neurones fondée sur le mécanisme d'attention, à la base des grands modèles de langage actuels.
Modification apportée · mis à jour le 24 septembre 2026
Le chiffre x3 de Jamba est maintenant attribué explicitement à AI21 Labs plutôt que présenté comme donnée établie, le recoupement AI21/NVIDIA distingue un plafond revendiqué d'une mesure représentative, l'attribution du ratio 4/36 d'IBM est corrigée vers Granite 4.0 H-Small plutôt que le papier Bamba, l'étude arXiv:2412.14354 est recadrée sur Mamba pur et non sur l'architecture hybride, une contradiction interne sur l'alternance chez Hymba est corrigée, une fiche signalétique de Jamba (paramètres, contexte, licence) et une quatrième question sur le compromis qualité sont ajoutées. J'ai ajouté deux encadrés de vulgarisation qui expliquent en langue courante le mécanisme de deux sections, sans rien changer au corps de l'analyse. La légende du schéma donnait le ratio de couches comme « une couche d'attention pour huit couches Mamba » : AI21 écrit une couche d'attention sur huit couches au total, soit sept couches Mamba, et la légende dit désormais ce que la source écrit. Le schéma lui-même, qui circule seul dès qu'il est partagé, ne portait aucune réserve sur ses proportions : il la porte maintenant. Un indice de niveau de preuve est posé sur cette page : il est bas, et il l'est parce que le chiffre central vient du fabricant du modèle et n'a été reproduit par personne. Une phrase présentait le gain de débit comme mesuré sur un modèle déployé en production, par opposition à un prototype de laboratoire : elle revenait à reprendre pour argent comptant la formule « production-grade » que la page traite ailleurs comme une revendication de l'éditeur. Elle dit maintenant ce que la source écrit, des poids publiés sous licence Apache 2.0 et une présentation que le fabricant assume. Le chiffre plus élevé associé à Mamba seul était évoqué sans être attribué ni chiffré : il l'est désormais, avec sa référence ajoutée à la bibliographie. Le titre pose une question et le chapô y répond dès sa première phrase. L'agencement des couches est ramené à ce que chaque source documente : seule AI21 décrit une alternance de blocs dédiés pour Jamba ; la fiche Granite 4.0 H-Small ne donne qu'un compte de couches sans dire comment elles se répartissent ; et Zyphra qualifie elle-même Zamba d'architecture distincte de l'alternance de Jamba, un bloc d'attention unique partagé. Le sous-titre, le résumé et le corps rangeaient ces trois modèles sous la même alternance : les trois disent maintenant la même chose. La note d'indice comptait neuf entrées de bibliographie sur onze issues de laboratoires décrivant leurs propres modèles, alors que la bibliographie en compte douze, dont dix : le décompte est rectifié. Enfin, l'étude de NVIDIA n'était citée que pour sa mesure défavorable à l'hybride à l'entraînement, alors qu'elle rapporte aussi un avantage de 2,65 points en moyenne sur douze tâches et une prédiction de génération jusqu'à huit fois plus rapide : les trois grandeurs figurent désormais ensemble. La phrase de synthèse de la section sur les autres laboratoires rangeait Bamba et Zamba sous l'alternance de couches, alors que le même paragraphe écrit que l'agencement des couches de Bamba n'est décrit par aucune de mes sources et que Zamba partage un module d'attention unique plutôt que d'en dédier un par couche. Elle ne dit plus que ce que ces sources portent. Le 24 septembre 2026, j'ai relu la page contre ses sources, et plusieurs phrases disaient plus qu'elles. Les 12 milliards de paramètres actifs étaient comptés « par requête », alors qu'AI21 écrit seulement qu'ils sont mobilisés à l'inférence. Le sous-titre prêtait à Bamba un principe d'agencement que le billet d'IBM ne décrit pas, et faisait de Jamba un choix « arbitré, pas une hypothèse de recherche », ce qu'aucune source ne dit ; la citation en exergue répétait ce second point. Une phrase prêtait à Bamba un ratio favorable à Mamba que le billet d'IBM ne donne pas : seul Granite 4.0 H-Small a un compte de couches documenté. Le partage du module d'attention de Zamba servait à « limiter le surcoût mémoire », alors que Zyphra écrit « à un coût minimal en paramètres ». La mesure d'Artificial Analysis était rapportée à Jamba alors qu'elle porte sur Jamba 1.5 Mini, un modèle ultérieur, et décrite comme une comparaison entre hébergeurs alors qu'un seul est mesuré. L'écart entre le x3 d'AI21 et le 4 à 5 fois de Gu et Dao était imputé à l'hybridation, alors que comparateurs et configurations diffèrent, et une phrase en tirait un signal « plus transposable à un usage réel » : elle est retirée. La MFU, un taux d'utilisation du GPU, était opposée à un gain de débit. Une question présentait comme « démontré » un gain que la page traite ailleurs comme revendiqué, une autre affirmait qu'aucun laboratoire ne publie de métrique de mémoire comparable, alors que Hymba publie une réduction de cache face à Llama-3.2-3B : cette affirmation est retirée. La phrase selon laquelle un modèle purement Mamba sacrifierait la précision n'était portée par aucune source : elle est retirée, du corps comme de l'encadré. L'étiquette « Ce que les données établissent » coiffait des spécifications du fabricant, et l'étiquette « Ce qui recoupe ce chiffre » un passage qui conclut que rien ne le recoupe : elles disent maintenant ce qu'elles coiffent. Le schéma disait que les deux mécanismes se relaient couche par couche, alors que sa propre légende compte une couche d'attention sur huit, et que l'attention est meilleure pour retrouver une information exacte : il ne montre plus que l'agencement et le coût de chaque bloc. Dans la note d'indice, l'absence de graines, d'intervalle et de protocole est ramenée à ce que le billet d'annonce établit, le matériel sur lequel NVIDIA constaterait ses gains n'est plus affirmé, faute d'un passage qui le nomme dans ce que j'ai lu, et la MFU n'est plus présentée comme la seule mesure contraire. Deux titres de la bibliographie sont rectifiés. J'ai ajouté ce que les sources portaient et que la page taisait : la qualité compétitive de Mamba et la cause que les auteurs de l'étude de reclassement donnent à sa lenteur, le contexte d'entraînement de 32 000 tokens de Mixtral 8x7B, et la revendication de qualité d'AI21 pour Jamba. L'indice ne bouge pas. J'ai ensuite relu la page une seconde fois contre ses sources. La MFU, un taux d'utilisation du GPU, servait encore de versant « entraînement » du gain de débit dans une réserve, dans une question et dans la note d'indice, alors que la page écrit elle-même qu'elle ne mesure pas une vitesse : aucun de ces passages ne la présente plus ainsi. Deux phrases disaient que le x3 d'AI21 porte sur l'inférence, ce que les passages du billet que j'ai relevés ne précisent pas : l'une est retirée, l'autre dit ce qui manque. Une phrase laissait entendre qu'AI21 avait été imitée, alors que la page écrit plus haut que les dates ne démontrent pas son antériorité : elle dit maintenant seulement que d'autres organisations ont aussi combiné les deux mécanismes. Le résumé et un encadré attribuaient à NVIDIA en général l'agencement en parallèle de Hymba, alors qu'un autre hybride de NVIDIA cité ici est construit par couches : ils nomment Hymba. La supériorité de l'attention pour retrouver une information exacte renvoyait à une autre page du site plutôt qu'à une source : elle est ramenée à ce que NVIDIA écrit de ses propres têtes d'attention dans Hymba, et retirée de l'encadré. La section sur l'interface affirmait que l'architecture n'est jamais visible, alors qu'AI21 l'affiche dans le titre de son annonce : elle dit maintenant qu'elle n'apparaît généralement pas. La présentation ne rapproche plus le x3 d'AI21 de la revendication de NVIDIA. L'indice ne bouge pas. Le sous-titre décrit Hymba comme son papier le fait, avec des têtes SSM en parallèle dans une même couche. Le gain de débit de Jamba est un gain revendiqué par AI21, sans méthodologie de benchmark détaillée dans son billet. La conclusion ne prête plus aux hybrides une dépendance à la tâche qu'aucune source citée ne teste sur eux. Le x3 n'est reproduit par aucune des sources réunies ici, ce que je dis désormais sans l'étendre à tout tiers. Le résultat sur le reclassement porte sur Mamba pur et je ne le présente plus comme une borne du gain d'un hybride. Le rappel « haute résolution » est rattaché à Hymba, dont il vient, et non à Jamba. Je rapprochais le chiffre de Nemotron-H du x3 d'AI21 comme deux signaux convergents ; il porte sur un autre modèle face à d'autres comparateurs, et, comme celui de Gu et Dao, il ne soutient ni ne contredit le x3. Le sous-titre nomme les composants de chaque modèle hybride comme ses sources le font. L'étude sur le reclassement trouve Mamba pur moins efficient, à qualité comparable, et non défavorable en tout ; le « jusqu'à 3 fois » de NVIDIA est un plafond, que je ne rapproche plus du x3 d'AI21.
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plus