Intelligence artificielle · 11 juin 2026 · mis à jour le 4 septembre 2026
LLM en finance : près de 90 % sur la réaction, 58 % sur la dérive
Sur des données postérieures à sa date de coupure, GPT-4 oriente correctement un portefeuille quotidien près de 90 % du temps, mais sur une réaction de marché qui n'est pas directement exploitable. Avant cette date, impossible de distinguer un vrai signal d'un simple effet de mémoire.
 Axel Morel · Fondateur & analyste, Probans
Décision concernée
Peut-on faire confiance à un outil de prévision financière fondé sur un LLM ?
Seulement après une évaluation temporelle strictement hors entraînement, réalisée sur une version figée du modèle, avec traçabilité de toutes les sources d'information accessibles au système (corpus d'entraînement, ajustement fin, récupération documentaire, outils connectés) et des résultats annoncés nets de coûts de transaction. La seule date de coupure des connaissances déclarée est une première condition nécessaire, pas une preuve suffisante. Pour une institution qui intègre cet outil à ses décisions de trading ou de scoring, l'enjeu est critique et l'engagement rarement pleinement réversible une fois le modèle en place : ne passez pas en production décisionnelle tant que cette validation temporelle et économique indépendante n'a pas été obtenue, l'expérimentation en environnement isolé pouvant en revanche commencer bien plus tôt. L'enjeu reste plus faible pour un usage individuel non automatisé, comme le détaille le tableau par profil plus loin dans l'article. Sinon, rien ne permet de distinguer une capacité de prévision d'un effet de mémorisation : les deux produisent exactement la même sortie. Un modèle plus récent et plus volumineux n'est pas automatiquement plus fiable pour ce type de tâche, la taille étant associée à la fois à un signal réel plus fort et à une capacité de mémorisation contaminante plus forte. Cette taille n'est mesurée dans aucune des deux études : elle est déclarée non divulguée par le fournisseur dans l'une, déduite du prix d'appel de l'interface dans l'autre. Étendez votre gouvernance de risque modèle existante (test hors échantillon strict, contrôle du nombre de configurations testées, coûts de transaction) à ces outils : elle fournit le socle du contrôle, à compléter par des vérifications propres aux modèles génératifs (version figée, traçabilité des données accessibles, non-déterminisme, mises à jour silencieuses du fournisseur).
L'essentiel en 3 points
- Le seul résultat solide tient à une précaution de test. Le résultat le plus solide en faveur d'un vrai signal (celui de Lopez-Lira et Tang) montre que GPT-4 classe assez bien l'impact de titres d'actualité inédits pour orienter correctement un portefeuille quotidien près de 90 % du temps sur la réaction initiale du marché. Cette réaction initiale n'est pas directement exploitable, et le signal sur la dérive de prix qui suit est nettement plus faible (58 % et 55 %). Ce résultat n'est solide que parce que les auteurs ne testent le modèle que sur des titres d'actualité postérieurs à sa date de coupure de connaissances : une précaution qui réduit fortement le risque de mémorisation sans l'annuler, et dont un travail ultérieur donne une borne inférieure quand elle manque (Didisheim, Fraschini et Somoza).
- Sans cette précaution, c'est souvent de la mémorisation. Quand cette précaution manque, ce qui ressemble à une capacité de prévision est souvent un effet de mémorisation : un phénomène dont les mêmes auteurs établissent en 2025 qu'il rend la capacité de prévision non identifiable, et dont toute mesure ne donne qu'une borne inférieure. Ce phénomène rejoint le surajustement de backtest, que la finance quantitative documente depuis 2014, bien avant l'apparition des LLM. Les causes ne sont pas les mêmes, la signature observable se ressemble.
- Le signal existe, mais il s'érode. Le signal qui survit à la seule précaution disponible, le test strictement postérieur à la date de coupure, existe, mais il s'érode dans le temps. Ce déclin est compatible avec l'hypothèse d'un marché qui absorbe plus vite l'information, sans suffire à l'établir. Et une fois les coûts de transaction et le mode de pondération pris en compte, les auteurs réservent son exploitation aux acteurs dont les coûts d'exécution sont assez bas, en nommant les teneurs de marché.
Mon idée maîtresse : le signal existe, mais il est plus étroit, plus fragile et plus vite arbitré que ne le laisse penser la présentation médiatique du sujet, tandis que le bruit qu’il faut soustraire pour l’isoler (la mémorisation) s’est révélé plus large, plus difficile à neutraliser par simple consigne de prompt, et surtout apparenté au surajustement de backtest, que la finance quantitative documente depuis plus de dix ans, sans s’y réduire.
À chaque nouvelle génération de modèle, la même question revient chez les gérants, les départements risques et les régulateurs : un grand modèle de langage lit-il vraiment l’information financière, ou se contente-t-il de la reformuler avec assurance ? La littérature académique la plus récente donne une réponse à deux étages, et non un verdict binaire. Il existe un signal réel, mesuré avec une rigueur méthodologique inhabituelle pour le champ. Il existe aussi une source de faux signal identifiée avec une précision croissante : la mémorisation, c’est-à-dire la capacité du modèle à restituer des faits qu’il a vus pendant son entraînement en les faisant passer pour une inférence.
Ce que le signal établit vraiment
L’étude de référence sur le sujet est celle d’Alejandro Lopez-Lira et Yuehua Tang, de l’université de Floride. Elle paraît au Journal of Financial Economics (vol. 184, article 104335). La version que j’ai lue est le préprint arXiv v6 du 28 octobre 2025, qui porte l’annexe en ligne dont viennent les chiffres de coûts. Sa force méthodologique tient à un choix précis : les auteurs ne testent le modèle que sur des titres d’actualité postérieurs à sa date de coupure de connaissances. Cette précaution réduit fortement le risque que le modèle restitue une réaction de marché qu’il aurait déjà vue. Elle ne l’annule pas : une date de coupure déclarée n’est pas une preuve mathématique d’absence de contamination, et les auteurs eux-mêmes ne la présentent pas comme telle.
Dans cette version, le portefeuille construit sur les scores de GPT-4 est correctement orienté 93,3 % des journées pour les nouvelles publiées de nuit et 88,8 % des journées pour celles publiées en cours de séance, soit près de 90 % du temps sur la réaction initiale du marché. Les auteurs le définissent comme un taux de réussite quotidien de portefeuille, la proportion de journées où le rendement du portefeuille long-short agrégé est positif, et disent avoir volontairement préféré cette métrique à l’exactitude titre par titre. 93,3 % ne signifie donc pas 93,3 % de prédictions individuelles correctes. L’article qualifie par ailleurs cette réaction initiale de réaction non directement exploitable, dans son résumé comme dans la légende de son tableau principal. Le signal réellement négociable, une fois l’information diffusée, est nettement plus faible : la dérive de prix des un à deux jours suivants n’est correctement anticipée que 58 % du temps pour les nouvelles de nuit et 55 % en séance, avec un effet plus marqué sur les petites capitalisations et les nouvelles négatives. Les auteurs observent aussi une hiérarchie entre modèles : le ratio de Sharpe sur la dérive tombe de 2,97 pour GPT-4 à 1,66 pour GPT-3.5, 1,26 pour DistilBart-MNLI et 0,97 pour Llama2-70b, et la plupart des modèles simples affichent un Sharpe négatif. Ils y voient l’indice que le raisonnement financier serait une capacité émergente des modèles complexes, plutôt qu’un simple effet d’analyse de sentiment classique. Ils notent eux-mêmes la limite de cette comparaison : la date de coupure de Llama 2, en septembre 2022, chevauche une partie de leur échantillon, et leurs résultats entre familles de modèles peuvent en être surévalués.
Ce papier ne teste pas la mémorisation. Il faut le dire nettement, parce que c’est là que se joue la solidité de tout l’édifice : le seul appui du caractère hors échantillon est la date de coupure déclarée du modèle. Les auteurs proposent en annexe en ligne une comparaison indirecte entre GPT-4 et GPT-3.5, dont les dates de coupure sont proches, et en tirent un indice plutôt qu’une preuve. Le test lui-même, ils le renvoient à un travail ultérieur, celui de la section suivante. Une inquiétude subsiste et ils l’écrivent : GPT-4 a pu, en théorie, être exposé à des données supplémentaires lors d’un ajustement fin ou par d’autres canaux.
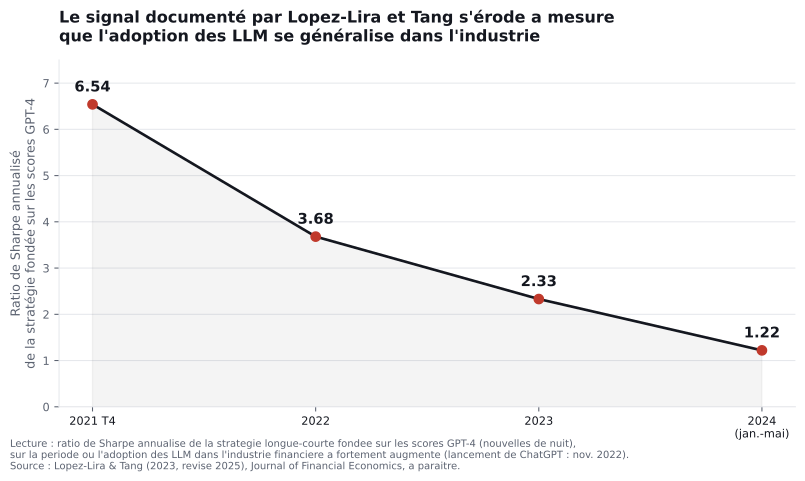
Source : Lopez-Lira et Tang, section 8.2 et annexe en ligne F.
Le point le plus intéressant pour un décideur n’est peut-être pas le taux de succès lui-même, mais ce que les auteurs observent ensuite : le rendement de la stratégie de trading construite sur ces scores décline au fil de la période, sur une fenêtre où l’adoption des LLM se généralise dans l’industrie. Le ratio de Sharpe annualisé de la stratégie fondée sur les nouvelles de nuit passe de 6,54 au quatrième trimestre 2021 à 3,68 en 2022, 2,33 en 2023, puis 1,22 sur janvier-mai 2024, une période qui coïncide avec le lancement public de ChatGPT en novembre 2022 et l’explosion de son adoption. Ce déclin est compatible avec l’hypothèse d’un marché qui incorpore plus vite l’information à mesure que les LLM se diffusent. Il ne suffit pas à l’établir. Les auteurs le disent eux-mêmes : tester directement cette hypothèse est difficile, et d’autres évolutions des conditions de marché peuvent contribuer au déclin. Ce papier ne prétend en tout cas pas avoir trouvé une martingale permanente.
Un élément change l’ordre de grandeur de la conclusion pratique, et il est enterré dans l’annexe en ligne F, absente du corps du texte. Les auteurs y font varier le coût d’exécution de la stratégie. Ce sont des niveaux de coût posés en hypothèse, pas des coûts de marché mesurés. Le portefeuille de nuit tourne à environ 190 % par jour en rééquilibrage complet, mesuré à sens unique. Avec 20 points de base de coûts aller-retour, son ratio de Sharpe passe de 2,97 à -0,39 et le rendement quotidien moyen devient négatif. Même à 10 points de base, il retombe autour de 1,29. La performance est en outre très concentrée sur les petites capitalisations : en pondération par capitalisation plutôt qu’en équipondération, le Sharpe de nuit tombe de 2,97 à 0,56 avant tout coût, et devient négatif dès 5 points de base. Un cas résiste pourtant dans la même annexe, et il serait malhonnête de le taire : la stratégie intraday équipondérée garde un ratio de Sharpe de 0,79 à 20 points de base. C’est le portefeuille de nuit qui s’effondre, pas la totalité du dispositif. Les auteurs ne concluent d’ailleurs pas que ce signal est incapturable. Ils écrivent qu’il n’est exploitable en pratique que pour les acteurs de marché dont les coûts de transaction sont suffisamment bas, et ils nomment les teneurs de marché. C’est plus intéressant qu’une généralisation : le signal existe, il n’est pas nul, et il appartient à ceux qui exécutent au meilleur coût. C’est la distinction que je retiens en priorité pour un comité d’investissement : un signal statistiquement significatif n’est pas un alpha que n’importe quelle institution peut capturer.
Lopez-Lira et Tang, annexe en ligne F, tableau OA7. Ces ratios portent sur toute la période d'échantillon, pas sur les sous-périodes citées plus haut : le papier ne publie aucun ratio net par sous-période. La performance est très concentrée sur les petites capitalisations. Les auteurs réservent l'exploitation de ce signal aux acteurs dont les coûts de transaction sont assez bas, en nommant les teneurs de marché.
Le piège de la mémorisation : quand la prévision est un souvenir
Le développement le plus significatif de ces deux dernières années vient des mêmes auteurs. Lopez-Lira, Tang et Zhu publient en 2025 un article au titre volontairement inconfortable pour leur propre travail antérieur : The Memorization Problem : Can We Trust LLMs’ Economic Forecasts ? Sur le plan théorique, ils établissent que lorsqu’un modèle a mémorisé la valeur réalisée d’une variable, sa capacité de prévision devient non identifiable : toute sortie du modèle est compatible à la fois avec une véritable compétence analytique et avec un simple rappel de mémoire, sans qu’aucun test de sortie ne permette de trancher entre les deux. Sur le plan empirique, ils montrent que les grands modèles rappellent les valeurs numériques d’indicateurs économiques majeurs, de titres de presse, de rendements boursiers et de transcriptions de conférences téléphoniques pour les périodes antérieures à leur date de coupure. Pour les quatre indicateurs macroéconomiques testés (croissance du PIB, inflation, taux de chômage, taux à 10 ans), l’erreur relative moyenne de rappel va de 0,03 % à 0,15 %, et le modèle retrouve le sens de variation dans plus de 96 % des cas. La précision est nettement plus inégale ailleurs : sur les niveaux d’indices quotidiens, l’exactitude directionnelle descend entre 69 et 81 % selon l’indice, et les indices non américains sont moins bien restitués. Après la date de coupure, la performance s’effondre. Les auteurs se gardent d’y voir un test : leurs échantillons post-coupure comptent parfois 6 à 17 observations, et ils écrivent que ce résultat est descriptivement compatible avec une absence de contamination, sans en constituer une démonstration statistique.
Deux tentatives de neutralisation échouent, et ce sont les résultats les plus dérangeants du papier. Demander explicitement au modèle de respecter les limites temporelles historiques ne l’empêche pas de rappeler, du moins quand la consigne est donnée au seul niveau système. Le masquage échoue aussi : sur des transcriptions anonymisées, le modèle identifie correctement l’entreprise dans 100 % des cas pour Apple, Meta et Microsoft, alors que le texte fourni ne contenait plus aucun nom, chiffre ni date en clair. Un détail vaut d’être gardé, parce qu’il borne le résultat : retrouver le trimestre et l’année exacts ne marche vraiment que pour Apple, à 93,2 %. Sur Meta, Microsoft et Tesla, ce taux tombe entre 1 et 4 %. Le modèle reconnaît l’entreprise beaucoup mieux qu’il ne date le document.
Lopez-Lira, Tang et Zhu (2025). Ces valeurs portent sur les périodes antérieures à la date de coupure du modèle ; après cette date, la performance s'effondre, sur des échantillons que les auteurs jugent trop petits pour constituer un test. Les 96 % sont une exactitude de sens de variation sur les quatre indicateurs macroéconomiques, pas sur l'ensemble des données testées. Les 93,2 % ne valent que pour Apple : sur Meta, Microsoft et Tesla, le modèle ne retrouve la date que dans 1 à 4 % des cas.
Le résumé que je retiens de ce papier : les grands modèles de langage ne peuvent pas être considérés comme fiables pour des prévisions économiques portant sur des périodes couvertes par leurs données d’entraînement. C’est une conclusion dure, et elle vient des mêmes auteurs qui avaient produit, deux ans plus tôt, le résultat le plus solide en faveur d’un signal réel. Cela se lit dans les deux sens, et il faut tenir les deux. D’un côté, la même équipe pose la condition qui rend un signal lisible, puis établit que hors de cette condition plus rien n’est lisible : c’est de la cohérence méthodologique. De l’autre, les deux piliers de cette analyse reposent sur les mêmes auteurs, et une convergence interne à une équipe n’est pas une réplication indépendante.
Un problème plus ancien que les LLM : l’overfitting de backtest
Ce phénomène est-il propre aux LLM, ou la finance quantitative l’a-t-elle déjà rencontré sous une autre forme ? Elle l’a rencontré, et le précédent est instructif. En 2014, David Bailey, Jonathan Borwein, Marcos López de Prado et Qiji Jim Zhu publient, dans les Notices of the American Mathematical Society, un article au titre délibérément provocateur : Pseudo-Mathematics and Financial Charlatanism. Par souci d’appliquer partout le même critère que j’applique aux autres sources de cette analyse : l’un des quatre auteurs exerçait alors dans la gestion d’actifs, ce que la notice du document indique. Ils y formalisent l’« overfitting de backtest » : une performance simulée impressionnante est facile à obtenir dès lors que l’on teste un nombre suffisant de configurations alternatives d’une même stratégie sur les mêmes données historiques, et plus ce nombre de configurations testées est élevé, plus la probabilité que le backtest soit surajusté augmente. Leur résultat le plus dur : quand la série de performance est autocorrélée, le surajustement ne ramène pas la performance hors échantillon à zéro, il peut la rendre significativement négative. Les auteurs y voient une explication possible de l’échec de fonds quantitatifs dotés d’un excellent historique de test. Ils la posent comme un soupçon, pas comme un taux mesuré, et leur démonstration porte sur des marches aléatoires simulées, jamais sur des données de marché réelles.
Un mot mérite qu’on s’y arrête, parce qu’il piège la lecture. La « mémoire » dont parlent Bailey et ses coauteurs est l’autocorrélation de la série de performance simulée. Elle n’a rien à voir avec la mémorisation d’un corpus par un modèle de langage. Le rapprochement que je fais entre les deux problèmes porte sur leur signature observable, jamais sur leur mécanisme. Le même mot, dans les deux littératures, ne désigne pas la même chose.
La mémorisation décrite par Lopez-Lira, Tang et Zhu une décennie plus tard rejoint cette famille de problèmes sans se confondre avec elle, et la nuance a des conséquences pratiques. Le surajustement de backtest est un problème de tests multiples et de sélection : on essaie assez de configurations pour en trouver une exceptionnelle par hasard. La mémorisation est un problème de fuite d’information dans le temps : le modèle a potentiellement vu le résultat qu’on lui demande de prévoir. Les causes diffèrent, mais la signature observable se ressemble. Un modèle, qu’il s’agisse d’une stratégie de trading choisie parmi des milliers de configurations testées ou d’un modèle de langage ayant mémorisé des valeurs historiques, paraît compétent sur des données qu’il a déjà « vues », et cette compétence apparente se dégrade, voire s’inverse, hors de cet échantillon. Le contrôle qui neutralise l’un ne neutralise pas automatiquement l’autre : compter les configurations testées ne dit rien sur ce que le modèle a lu, et vérifier une date de coupure ne dit rien sur le nombre d’essais.
Surajustement de backtest
- On essaie assez de configurations pour en trouver une exceptionnelle par hasard
- Le contrôle correspondant est de compter les configurations testées, ce qui ne dit rien sur ce que le modèle a lu
Mémorisation
- Le modèle a potentiellement vu le résultat qu'on lui demande de prévoir
- Le contrôle correspondant est de vérifier une date de coupure, ce qui ne dit rien sur le nombre d'essais
Un second précédent s’impose à l’esprit, celui du travail de McLean et Pontiff, publié dans sa version finale au Journal of Finance en 2016, sur le déclin de la prédictibilité des anomalies de rendement après leur publication académique. La version lue ici est une version de travail de 2012 : sur 82 caractéristiques testées, le déclin hors échantillon dû au biais statistique est d’environ 10 % (non significatif), tandis que le déclin après publication académique atteint environ 35 % (significatif), attribué à ce même biais et à une pression sur les prix exercée par des investisseurs informés qui arbitrent l’anomalie. Des résumés secondaires de la version finale de 2016, non vérifiés ici en texte intégral, évoquent des chiffres plus élevés (97 caractéristiques, déclins de 26 % et 58 %). Le mécanisme, lui, rejoint celui du surajustement de backtest : une performance mesurée décline une fois qu’elle devient connue, ici par arbitrage informé plutôt que par sélection de configurations testées.
Ma lecture : le problème de mémorisation des LLM n’est pas un risque né avec l’intelligence artificielle. C’est un instrument nouveau qui a hérité d’une famille de maladies anciennes de la finance quantitative, sans en être une simple répétition. Un département des risques qui dispose déjà d’une gouvernance pour auditer les backtests de stratégies quantitatives (longueur minimale de backtest, ratio de Sharpe déflaté, test hors échantillon strict, coûts de transaction, validation indépendante) tient le socle du contrôle. Il ne tient pas l’ensemble. Un système fondé sur un LLM ajoute des questions que la gouvernance quantitative classique n’a jamais eu à poser : corpus d’entraînement opaque, date de coupure parfois mal documentée, ajustement fin et post-entraînement, mises à jour silencieuses du modèle par le fournisseur, non-déterminisme des sorties, sensibilité à la formulation du prompt, contamination possible par la récupération documentaire ou les outils connectés, dépendance à un prestataire externe, reproductibilité des résultats. Le socle existant se complète de ces contrôles propres aux modèles génératifs, il ne les remplace pas.
Mesurer l’ampleur du bruit, et ce qu’on ne peut pas mesurer
Un troisième travail circule sur ce sujet, celui de Chuan Liang sur le biais d’antériorité dans les prévisions financières produites par un modèle de langage. Je l’ai retiré de cette analyse, et l’exercice mérite d’être raconté parce qu’il est instructif. Ses trois chiffres tiennent en une phrase, et ils portent sur trois exercices distincts : l’erreur de prévision de GPT-4 serait de 18 % plus faible avant sa date de coupure sur les niveaux d’indices quotidiens, de 16 % sur les cours mensuels, de 11 % sur les bénéfices trimestriels. Ces chiffres ne viennent pas du document. Ils viennent de la notice que l’auteur a lui-même déposée sur SSRN en mai 2026 pour décrire son travail. Le document, lui, est sous mur payant sur SSRN, et aucune version libre n’existe ailleurs. On ignore donc la population, la période, la taille de l’échantillon, la définition exacte de la métrique et les valeurs de test. Un chiffre repris d’un résumé n’est pas un chiffre vérifié, et j’ai préféré retirer le graphique qui le portait plutôt que de laisser trois nombres prendre l’apparence d’une mesure. Ils ne sont d’ailleurs pas encore repris : au moment où je consulte la notice, le document compte 75 téléchargements et n’a été discuté nulle part.
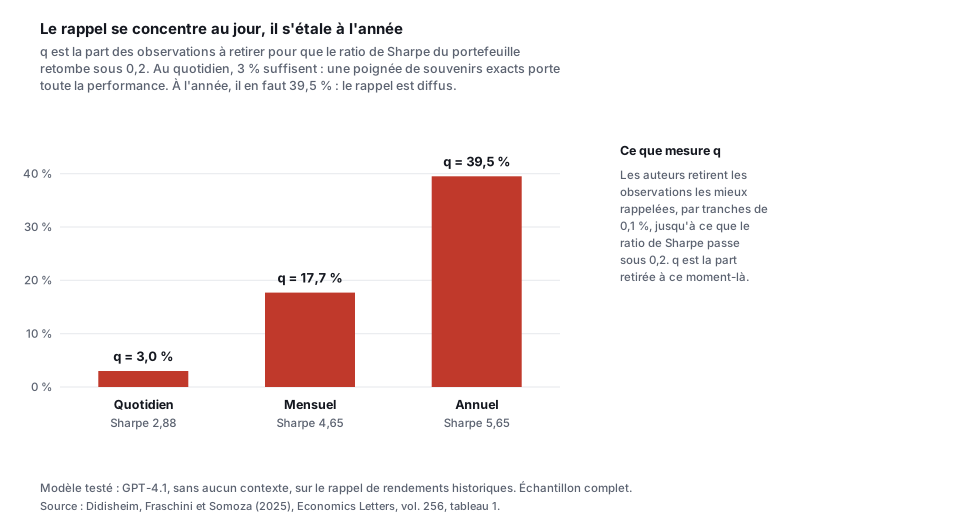
Source : Didisheim, Fraschini et Somoza (2025), tableau 1.
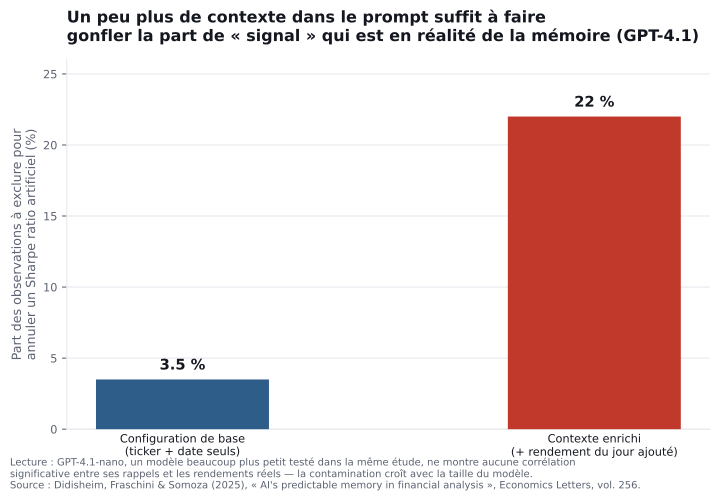
Source : Didisheim, Fraschini & Somoza (2025).
Antoine Didisheim, Martina Fraschini et Luciano Somoza, dans Economics Letters, demandent au modèle de rappeler des rendements historiques sans aucun contexte, pour isoler la part de mémorisation pure. Leur mesure s’appelle q : la part des observations qu’il faut retirer, en commençant par celles dont l’erreur de rappel est la plus faible, pour que le ratio de Sharpe du portefeuille construit sur ces rappels retombe sous 0,2. C’est une mesure de concentration de la performance fallacieuse, et les auteurs la présentent comme une borne inférieure du biais réel, pas comme sa mesure.
Deux résultats comptent. Le premier est une affaire d’horizon. Sur données quotidiennes, un Sharpe de 2,88 ne tient qu’à 3 % des observations : c’est une poignée de souvenirs exacts, et les auteurs le formulent ainsi. Sur données mensuelles, il faut en retirer 17,7 % pour ramener le Sharpe sous 0,2 ; sur données annuelles, 39,5 %. Ce n’est plus une poignée, c’est un rappel étendu à une part importante de l’échantillon. Le mécanisme change de nature avec l’horizon, il ne s’aggrave pas simplement. Une troisième coupe mérite d’être citée, parce qu’elle borne la portée du résultat : sur données mensuelles, le Sharpe de rappel passe de 4,65 sur 2017-2023 à 0,66 sur 2000-2017, et le q de 17,7 % à 9,2 %. Les auteurs l’attribuent à la composition du corpus d’entraînement. La contamination mesurée est donc un phénomène de période récente, pas une propriété stable du modèle. Le second est une affaire de contexte. Avec GPT-4.1, q passe de 3,5 % dans la configuration la plus sobre du prompt à 21,4 % dès qu’on ajoute le rendement du jour même, une information de faible valeur en apparence. Les auteurs arrondissent eux-mêmes cette valeur à 22 % dans leur introduction.
Point notable : cet effet varie avec la capacité du modèle. GPT-4.1-nano, une version plus compacte testée dans la même étude, tombe à un q de 0,0 % avec le contexte enrichi, contre 0,6 % en configuration de base, et les auteurs parlent d’un biais d’antériorité négligeable dans toutes les configurations. Les modèles de plus grande capacité apparaissent donc associés à la fois à de meilleures performances sémantiques chez Lopez-Lira et Tang et à davantage de rappel chez Didisheim et ses coauteurs. La taille n’est pas pour autant isolée expérimentalement comme le mécanisme causal. Ces comparaisons portent aussi sur des architectures, des entraînements et des générations différents, et Lopez-Lira et Tang notent eux-mêmes que la date de coupure de Llama 2, en septembre 2022, chevauche une partie de leur échantillon et peut biaiser certaines comparaisons entre modèles. La corrélation suffit toutefois à compliquer sérieusement l’idée reçue selon laquelle un modèle plus gros et plus récent serait mécaniquement plus fiable pour ce type de tâche.
Une phrase de leur conclusion mérite d’être citée, parce qu’elle contredit la lecture pessimiste qu’on serait tenté de tirer de leur travail : un backtest fiable avec un modèle de langage reste faisable, à condition d’un montage approprié et de l’usage de leur méthode de détection. Ils ne concluent pas au renoncement, ils concluent à l’instrumentation.
| Étude | Ce qu’elle établit | Chiffre clé |
|---|---|---|
| Lopez-Lira & Tang, Journal of Financial Economics, vol. 184 | Signal réel sur données post-cutoff, exploitable après coûts pour les seuls acteurs à coûts très bas | 93,3 % / 88,8 % de journées de portefeuille correctement orientées sur la réaction initiale (58 % / 55 % sur la dérive) ; Sharpe brut de 6,54 à 1,22 entre T4 2021 et mai 2024 ; sur toute la période, Sharpe de 2,97 à −0,39 entre 0 et 20 points de base de coûts |
| Bailey, Borwein, López de Prado & Zhu (2014), Notices AMS | Précédent pré-LLM : surajustement de backtest, sur séries simulées | Le rendement hors échantillon peut devenir significativement négatif quand la série de performance est autocorrélée |
| Lopez-Lira, Tang & Zhu (2025), préprint arXiv | La mémorisation rend la prévision pré-cutoff non identifiable | Rappel des valeurs pré-coupure ; après la coupure, effondrement que les auteurs refusent de traiter comme un test |
| Didisheim, Fraschini & Somoza (2025), Economics Letters | La part de rappel croît avec l’horizon et avec la richesse du contexte | q de 3 % (quotidien) à 39,5 % (annuel) ; de 3,5 % à 21,4 % en ajoutant le rendement du jour. Borne inférieure |
| Zhang, Fu, Warrier et al. (2025), FAITH, ACM ICAIF | Fiabilité numérique de base, hors prévision | 95,6 % (Claude Sonnet 4) et 91,9 % (Gemini 2.5 Pro) sur le lot principal, 80 % et 90 % sur les dix cas de calcul multivarié |
| Hansen & Lee (2025), préprint arXiv | Comportement grégaire d’agents en laboratoire | Les agents suivent moins les tendances individuellement ; les implications de stabilité financière sont qualifiées de spéculatives par les auteurs |
La fiabilité numérique de base : un problème antérieur à la prévision
Avant même la question de la mémorisation, il existe un problème plus élémentaire : la capacité d’un modèle à lire correctement un tableau financier et à en tirer un calcul juste. C’est ce que mesure FAITH, un cadre d’évaluation présenté à la sixième conférence ACM sur l’IA en finance, construit à partir de rapports annuels réels de sociétés du S&P 500. La tâche consiste à masquer un passage numérique du rapport de gestion et à demander au modèle de le reconstituer à partir du document, en classant chaque cas selon qu’il s’agit d’une lecture directe, d’un calcul comparatif, d’un calcul à deux variables ou d’un calcul multivarié. Sur le lot principal, les deux modèles propriétaires en tête, Claude Sonnet 4 et Gemini 2.5 Pro, affichent une exactitude élevée, respectivement 95,6 % et 91,9 %, soit un taux d’erreur de 4 à 8 %. Sur la catégorie la plus exigeante, le calcul multivarié, qui demande de raisonner sur trois métriques ou plus, ou sur une suite d’opérations arithmétiques, l’exactitude tombe à 80 % pour Claude Sonnet 4 et reste à 90 % pour Gemini 2.5 Pro. C’est de là que vient le taux d’erreur de 10 à 20 % que les auteurs mettent en avant pour les modèles les plus avancés.
Deux précautions avant d’en tirer quoi que ce soit. La première est un effectif : cette catégorie compte dix cas dans le lot principal, contre 1 606 pour la simple lecture de cellule. Un cas de plus ou de moins déplace le chiffre de dix points, et aucun intervalle n’accompagne ces taux. La seconde est le protocole lui-même, qui est tolérant : les passages les plus ambigus ont été écartés du corpus, l’arrondi est accepté, et le modèle a droit à trois tentatives en cas de sortie mal formée. Les taux publiés sont donc des bornes hautes de fidélité, pas des taux de production.
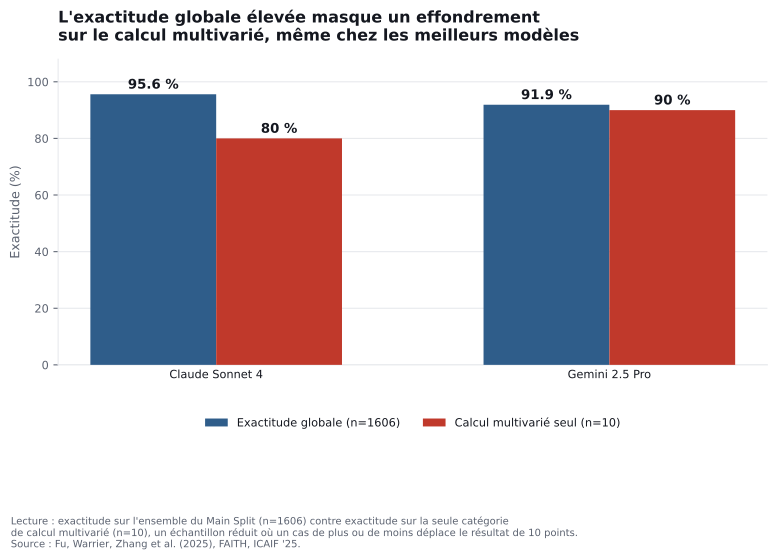
Source : Zhang, Fu, Warrier et al. (2025), ICAIF ‘25, tableau 3.
Ce ne sont pas Claude Sonnet 4 ou Gemini 2.5 Pro qui s’effondrent vers 0 % sur les cas les plus complexes. Les scores proches de 0 % sur le calcul multivarié appartiennent à d’autres modèles, et pas nécessairement aux plus petits : les auteurs nomment Llama-3.3-70B et Mistral-small-24B, en soulignant que plusieurs d’entre eux comptent pourtant relativement plus de paramètres. Le mode d’erreur dominant est d’ailleurs banal et corrigible : le modèle lit la bonne valeur mais se trompe d’ordre de grandeur, en rapportant 150 dollars là où le document dit 150 millions. Ce chiffre ne dit rien sur la capacité prédictive du marché. Il dit simplement qu’un modèle, même parmi les meilleurs, peut se tromper sur une marge brute qui demande d’enchaîner plusieurs opérations à partir d’un document qu’il a sous les yeux.
L’angle systémique : et si le vrai risque n’était pas individuel ?
Un travail récent déplace utilement la question. Anne Lundgaard Hansen et Seung Jung Lee, deux économistes du système de Réserve fédérale, reproduisent en laboratoire des expériences classiques sur le comportement grégaire en salle de marché, avec des agents fondés sur des LLM à la place de sujets humains. Une précision d’attribution avant tout le reste, parce qu’elle change ce que ce travail pèse : c’est un préprint non revu par les pairs, et ses auteurs écrivent que leurs conclusions n’engagent ni le Board of Governors ni la Fed de Richmond. Ce n’est pas une position de la Réserve fédérale.
Leur constat initial va à contre-courant du discours sur le risque systémique de l’IA : les agents prennent des décisions plus rationnelles que les humains, parce qu’ils s’appuient sur leur information privée plutôt que sur la tendance observée. Les auteurs n’y voient pas une vertu : une explication qu’ils avancent est que ces agents n’arrivent pas à intégrer l’historique des échanges. Ce défaut leur coûte cher, et particulièrement dans un de leurs traitements, où les agents de base gagnent 3,8 lires contre 15 aux agents optimisés. Selon les paramétrages testés, ils décident rationnellement entre 61 % et 97 % du temps, et les cascades d’information ne surviennent que dans 0 à 9 % de leurs décisions. Le point de comparaison humain n’est pas de leur main : il vient d’une expérience de Cipriani et Guarino conduite en 2009 auprès de 32 professionnels de marché à Londres, où le taux de décision rationnelle est de 46 à 51 % et celui des cascades d’environ 20 %. Les auteurs relèvent aussi que lorsque leurs agents entrent malgré tout en cascade, ils prennent le contrepied de la tendance plutôt que de la suivre.
Mais ces mêmes agents adoptent un comportement grégaire dès qu’on les guide explicitement vers la maximisation du profit, et avec une efficacité variable selon le dispositif : dans un traitement, ils saisissent 44,4 des 50,9 % d’occasions où suivre le troupeau était optimal ; dans un autre, ils ne suivent que 47,4 % du temps là où c’était optimal dans 81,5 % des cas, avec du suivisme mal placé. Les auteurs en tirent des implications de stabilité financière qu’ils qualifient eux-mêmes de spéculatives, et écartent explicitement de leur périmètre la question de la monoculture de modèle.
Un test de robustesse, deux sections plus loin dans le même papier, retire beaucoup à la rationalité qu’on vient de leur prêter. Il suffit d’inverser l’association entre la couleur et le signal pour que les modèles vendent sur un bon signal et achètent sur un mauvais, dans un quart des décisions et dans les deux traitements. Sur un des modèles testés, toutes les décisions deviennent erronées sous ce codage. La conclusion des auteurs est sans ambiguïté : ces agents ne sont pas des décideurs purement rationnels qui traiteraient l’information de façon objective, ils sont sensibles à des idées préconçues. C’est le résultat que je retiens le plus volontiers, parce qu’il contredit celui que j’avais envie de retenir.
Hansen et Lee (2025), préprint arXiv dont les auteurs précisent qu'il n'engage pas leurs institutions : reproduction en laboratoire d'expériences classiques sur le comportement grégaire, avec des agents fondés sur des LLM à la place de sujets humains. Les valeurs humaines de comparaison viennent de Cipriani et Guarino (2009), sur 32 professionnels de marché. Les agents adoptent un comportement grégaire dès qu'on les guide vers la maximisation du profit, et les auteurs qualifient de spéculatives leurs implications de stabilité financière.
Quatre usages, quatre niveaux de preuve
Opposer un « camp du signal » à un « camp du bruit » serait commode, et faux. Les travaux cités ici ne portent pas sur la même tâche : ce ne sont pas des réplications d’un même phénomène, mais des familles de risques distinctes. Une conclusion valable pour l’une ne se transpose pas mécaniquement aux autres.
Prévision de marché. C’est l’usage le plus documenté et le plus contradictoire. Un signal post-cutoff existe et il est statistiquement significatif. Je n’ai trouvé aucun travail qui l’annule, ce qui n’est pas la même chose que de dire qu’il n’en existe pas. Sa validation économique est en revanche beaucoup plus difficile que ne le suggèrent les backtests standards : coûts de transaction, turnover, mode de pondération du portefeuille, déclin dans le temps. Et dès que le test porte sur une période couverte par l’entraînement, la mémorisation rend l’interprétation non identifiable (Lopez-Lira, Tang & Zhu et Didisheim, Fraschini & Somoza convergent sur ce point précis).
Calcul numérique sur documents. Risque différent, mesuré différemment. FAITH ne teste aucune prévision : il mesure si le modèle retrouve une valeur masquée dans un rapport annuel qu’il a sous les yeux, et s’il enchaîne juste les opérations. Le taux d’erreur y est faible en moyenne et nettement plus élevé sur les calculs multivariés. Un modèle peut donc être fiable en prévision de sentiment et faux sur une marge brute, ou l’inverse.
Recherche documentaire. C’est l’usage que je croyais le moins exposé, parce qu’on ne demande au modèle ni de deviner l’avenir ni de restituer une valeur de mémoire : il localise et reformule un texte qui existe déjà, sous contrôle humain en aval. Lopez-Lira, Tang et Zhu m’obligent à nuancer, et l’objection est sérieuse. Ils écrivent que beaucoup de tâches qui ressemblent à de la simple extraction sont en réalité chargées de jugement : décider qu’un élément est pertinent ou important, identifier un risque, classer un sentiment, formuler une attente. Toutes peuvent être influencées par la connaissance de ce qui s’est passé ensuite. Or juger de la pertinence d’un document et identifier des risques sont exactement ce que fait l’outil décrit ci-dessous. L’avantage structurel de cet usage est donc plus étroit que je ne le pensais, et je n’ai pas de preuve indépendante à mettre derrière. La seule source dont je dispose est une méthodologie de recherche augmentée par récupération documentaire publiée par une équipe de gestion des risques de la banque TD, appliquée à 94 lignes directrices du régulateur bancaire canadien couvrant 1991 à 2024. Elle mesure un classement de documents, jamais la qualité des réponses produites : aucun taux d’hallucination, aucune exactitude de réponse. L’asymétrie de preuve compte ici. Les travaux sur la contamination temporelle viennent d’équipes académiques distinctes n’ayant rien à vendre, quand ce cas repose sur une source unique, produite par l’équipe qui a construit l’outil qu’elle documente.
Un point que je dois ajouter, parce qu’il ne relève pas du même risque et qu’il n’apparaît nulle part ailleurs dans cette analyse : cet usage consiste à faire lire à un prestataire externe des contrats, des factures et de la documentation interne. Le risque n’est plus celui d’une réponse fausse, il est celui de ce que devient le document une fois transmis. Rétention côté fournisseur, réutilisation pour l’entraînement, localisation des traitements, secret des affaires : ces questions se posent avant la question de la fiabilité, et elles ne se règlent pas par un test hors échantillon.
Décision multi-agents. Le travail de Hansen et Lee ne mesure ni un signal de prévision ni une erreur de calcul, mais un comportement collectif en laboratoire. Ses agents sont plus rationnels et moins grégaires que les humains dans la configuration de base, et cette rationalité ne survit pas à une simple inversion du codage des signaux. Le risque qu’il soulève est systémique, pas individuel, il est qualifié de spéculatif par ses propres auteurs, et il ne dit rien sur la qualité prédictive d’un outil pris isolément.
Ce que je retire de ce découpage : il n’existe pas de verdict unique sur « les LLM en finance ». Des signaux existent dans certaines tâches, mais leur validation économique est beaucoup plus difficile que ne le suggèrent les backtests standards. Et le classement de ces quatre usages par niveau de preuve donne un résultat inconfortable : l’usage le plus documenté est celui dont la valeur économique tient le moins, et celui que je recommanderais le plus volontiers est celui dont je peux le moins prouver la valeur.
Application concrète selon le profil de décision
| Profil | Usage à éviter | Usage à privilégier | Point de vigilance | Enjeu | Réversibilité |
|---|---|---|---|---|---|
| Particulier | Pronostic ponctuel sur une action et action directe | Résumer un rapport annuel, vulgariser un concept, en vérifiant les chiffres | Un ton confiant n’est pas une preuve de fiabilité | Faible | Réversible |
| TPE | Prévision de trésorerie sans vérification humaine | Recherche dans ses propres contrats et factures | Privilégier les usages à faible enjeu, vérifiables | Modéré | Réversible |
| PME | Scoring fournisseur sans traçabilité de la méthode | Veille réglementaire, synthèse de documentation interne validée | Exiger la méthodologie de test (post-cutoff ou non) | Modéré | Partiellement réversible |
| Grande entreprise / banque | Passage en production décisionnelle sans validation temporelle ni chiffrage des coûts d’exécution | Backtest déflaté et test hors échantillon strict, complétés par des contrôles propres aux modèles génératifs (version figée, traçabilité des données accessibles) | Surveiller le risque de corrélation systémique entre institutions | Critique | Partiellement réversible |
Ce que j’en retiens pour un décideur
Un directeur des risques ou un gérant qui évalue un outil de prévision fondé sur un LLM ne devrait pas s’arrêter à la question « est-ce mesuré post-cutoff ? ». C’est la bonne première question, ce n’est pas la seule, et une date de coupure déclarée par un fournisseur ne se vérifie pas depuis l’extérieur. Ce que j’exigerais d’un fournisseur, dans cet ordre :
- quelle version exacte du modèle a été figée pour l’évaluation, et à quelle date ;
- quelles données étaient accessibles au système pendant le pré-entraînement, le post-entraînement, l’ajustement fin, la récupération documentaire et les outils connectés ;
- si le test est réellement en avant seulement, sans que la période d’évaluation ait servi à régler quoi que ce soit ;
- si les performances annoncées incluent les coûts de transaction, le turnover et les contraintes d’exécution ;
- combien de configurations ont été essayées avant de retenir celle qui est présentée.
Une question manque encore à cette liste, et c’est celle qui vieillit le plus vite. Toute la garantie décrite ici repose sur une date de coupure : le modèle ne peut pas avoir vu ce qui s’est passé après. Cette garantie ne tient que si le modèle est seul avec ses poids. Or, dès qu’un système fondé sur un LLM va chercher de l’information au moment où il répond, et c’est ce que font la récupération documentaire, l’appel à une source de marché ou un outil connecté à un fournisseur de données, cette condition ne tient plus. À partir de là, la date de coupure ne dit plus rien sur ce que le système avait sous les yeux quand il a produit sa réponse. Le résultat de Didisheim et ses coauteurs prend ici toute sa portée : ajouter au contexte le seul rendement du jour fait passer la part de rappel de 3,5 % à 21,4 %. L’information qu’on injecte à l’exécution ne se contente pas de s’ajouter, elle réveille ce que le modèle avait mémorisé. Un dispositif d’évaluation qui certifie un modèle nu ne certifie donc pas le produit qui l’embarque. Ma lecture, que je pose comme telle faute de source sur l’état du marché : c’est cette configuration, et non le modèle nu, qu’un acheteur a le plus de chances de se voir proposer.
Cette exigence ne se confond pas avec un refus d’expérimenter. Entre « acheter et laisser trader » et « ne rien adopter », il existe une gradation entière : bac à sable, portefeuille fictif, trading sur papier, aide à l’analyste, classement de nouvelles, double validation humaine, limites de risque très basses, comparaison avec un modèle de référence déjà en place. Le seuil qui compte n’est pas l’expérimentation, c’est le passage en production décisionnelle. Un décideur devrait aussi se méfier d’une heuristique intuitive mais trompeuse : un modèle plus récent et plus volumineux n’est pas automatiquement plus fiable pour ce type de tâche, puisque la même caractéristique (la taille) est corrélée à la fois à l’émergence d’un signal réel et à une capacité de mémorisation contaminante plus forte. Avec cette réserve, qui n’est pas mince : ni l’une ni l’autre des deux études ne mesure la taille des modèles qu’elle compare. L’une note que les fournisseurs ne la publient pas, l’autre la déduit du prix d’appel de l’interface. Le réflexe le plus utile, pour une organisation qui dispose déjà d’une gouvernance de risque modèle sur ses stratégies quantitatives classiques, est d’étendre cette gouvernance existante plutôt que d’en construire une nouvelle : un test hors échantillon strict et un contrôle du nombre de configurations essayées valent, pour un outil LLM, ce qu’ils valaient déjà pour un backtest de stratégie quantitative en 2014. À condition d’y ajouter ce qu’un backtest classique n’avait jamais à contrôler : la version du modèle et sa date de gel, l’opacité du corpus d’entraînement, les mises à jour décidées par le fournisseur, le non-déterminisme des sorties et la sensibilité à la formulation du prompt.
Implications à trois horizons
À court terme (0 à 12 mois), la priorité est d’auditer toute solution de prévision fondée sur un LLM déjà en place ou en cours d’évaluation, en demandant explicitement la méthodologie de séparation entre données d’entraînement et données de test. À moyen terme (1 à 3 ans), l’enjeu porte sur la ségrégation des cas d’usage internes entre tâches de récupération documentaire supervisée, où l’adoption peut s’accélérer avec un risque maîtrisé, et tâches de prévision ou de calcul autonome, où la vérification humaine devrait rester la norme tant que les taux d’erreur documentés par des benchmarks indépendants n’auront pas structurellement baissé. À long terme (au-delà de 3 ans), la question qui mérite d’être suivie est celle que le travail de Hansen et Lee ouvre sans la trancher : si l’industrie converge vers un petit nombre de modèles fondamentaux largement partagés pour le conseil de trading, la réduction du comportement moutonnier irrationnel à l’échelle individuelle pourrait se payer d’une corrélation accrue des comportements à l’échelle du marché. Ni ce travail ni aucune des sources de cette analyse ne le mesure, et les auteurs eux-mêmes écartent cette question de leur périmètre : c’est une piste à surveiller, pas un risque documenté.
Une dernière conjecture, que je pose comme telle parce qu’aucune source de cette analyse ne l’étaye : le coût de calcul des modèles de raisonnement pourrait pousser à un désassemblage progressif de l’IA généraliste en briques spécialisées, chaque tâche routée vers l’architecture la plus efficiente. Mon analyse sur les alternatives aux LLM (TRM, Mamba, JEPA) détaille ce à quoi ça ressemblerait.
Analyse indépendante à visée informative. Elle ne constitue ni un conseil en investissement, ni une recommandation personnalisée. Les performances citées sont issues de travaux académiques, brutes de frais sauf mention contraire, et ne préjugent pas des performances futures.
Lopez-Lira, A., Tang, Y. « Can ChatGPT Forecast Stock Price Movements ? Return Predictability and Large Language Models ». Journal of Financial Economics, vol. 184, article 104335. Version lue : préprint arXiv v6 du 28 octobre 2025. Les analyses de rotation et de sensibilité aux coûts de transaction citées ici viennent de son annexe en ligne F, absente du corps du texte. https://arxiv.org/abs/2304.07619
Lopez-Lira, A., Tang, Y., Zhu, M. (première version 15 avril 2025, version lue déposée le 15 décembre 2025). « The Memorization Problem : Can We Trust LLMs’ Economic Forecasts ? ». Préprint arXiv:2504.14765, non revu par les pairs. https://arxiv.org/abs/2504.14765
Bailey, D. H., Borwein, J. M., López de Prado, M., Zhu, Q. J. (2014). « Pseudo-Mathematics and Financial Charlatanism : The Effects of Backtest Overfitting on Out-of-Sample Performance ». Notices of the American Mathematical Society, 61(5), 458-471. https://ssrn.com/abstract=2308659
McLean, R. D., Pontiff, J. (2016). « Does Academic Research Destroy Stock Return Predictability ? ». The Journal of Finance, 71(1), 5-32. Version de travail du 23 octobre 2012 lue en entier : https://www.hec.ca/finance/Fichier/McLean.pdf 82 caractéristiques testées, déclin hors échantillon d’environ 10 % (non significatif) et déclin post-publication d’environ 35 % (significatif). La version finale de 2016 n’est pas vérifiée en texte intégral ; des résumés secondaires lui attribuent 97 caractéristiques et des déclins de 26 % et 58 %.
Liang, C. (déposé le 22 mai 2026, révisé le 9 juin 2026). « Look-Ahead Bias in Financial Forecasts Generated by Large Language Models ». SSRN. Document sous mur payant (accès direct refusé) : les trois chiffres qui en circulent (18 %, 16 %, 11 %) viennent de la notice déposée par l’auteur, pas du texte, et ne sont pas repris ici comme preuve. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6772819
Didisheim, A., Fraschini, M., Somoza, L. (2025). « AI’s predictable memory in financial analysis ». Economics Letters, vol. 256. DOI 10.1016/j.econlet.2025.112602. https://www.sciencedirect.com/science/article/pii/S0165176525004392
Zhang, M., Fu, J., Warrier, T., Tan, T., Wang, Y., Huang, K.-W. (2025). « FAITH : A Framework for Assessing Intrinsic Tabular Hallucinations in Finance ». ICAIF ‘25, 6th ACM International Conference on AI in Finance, Singapour. https://arxiv.org/abs/2508.05201
Hansen, A. L., Lee, S. J. (2025). « Financial Stability Implications of Generative AI : Taming the Animal Spirits ». Préprint arXiv. Les auteurs appartiennent au Board of Governors of the Federal Reserve System et à la Federal Reserve Bank of Richmond, et précisent que leurs conclusions n’engagent pas ces institutions. https://arxiv.org/pdf/2510.01451
Haeri, A., Vitrano, J., Ghelichi, M. (2025). « Generative AI Enhanced Financial Risk Management Information Retrieval ». TD Bank, Model Development Innovation, Risk Management. Source practitioner interne à une banque, à lire avec ce biais de perspective en tête. https://arxiv.org/pdf/2504.06293
Mes réserves
Ce qui invaliderait cette lecture
- Le parallèle établi dans le corps de l'article avec McLean et Pontiff s'appuie sur une version de travail de 2012, antérieure de quatre ans à la publication finale au Journal of Finance (2016). Ses chiffres propres (82 caractéristiques testées, déclins de 10 % et 35 %) diffèrent de ceux généralement rapportés pour la version publiée (97 caractéristiques, déclins de 26 % et 58 % selon des résumés secondaires non vérifiés ici) : le parallèle porte sur la version effectivement lue, pas sur les chiffres définitifs de 2016.
- Le travail de Chuan Liang est sous mur payant sur SSRN (accès direct refusé), et aucune version libre n'existe ailleurs. Les trois pourcentages qui en sont tirés (18 %, 16 %, 11 %) viennent de la notice que l'auteur a lui-même déposée, pas du document. Ils ne sont pas utilisés comme preuve, et le graphique qu'ils portaient a été retiré. Ils sont mentionnés encore, en disant d'où ils viennent.
- Les ratios de Sharpe rapportés par Lopez-Lira et Tang sont bruts, avant coûts d'exécution. Les chiffres de rotation et de sensibilité aux coûts que je reprends ici viennent de l'annexe en ligne F de leur article, absente du corps du texte : ils suffisent à faire disparaître la performance de la stratégie de nuit, ce qui déplace la question du signal statistique vers celle de sa capturabilité réelle. Ces niveaux de coût sont posés par les auteurs comme hypothèses de sensibilité, ce n'est pas une mesure de coût de marché.
- Les 22 % d'observations à exclure chez Didisheim, Fraschini et Somoza viennent d'une configuration expérimentale précise, l'ajout du seul rendement du jour même au contexte. Ce n'est pas une mesure générale et stable de la contamination mémorielle, et dans leur table détaillée la valeur exacte est 21,4 %, que leur propre résumé arrondit à 22 %.
- Le travail de Hansen et Lee sur le comportement grégaire est un travail de laboratoire, pas une observation de marché réel à grande échelle. C'est aussi un préprint non revu par les pairs, et ses auteurs précisent que leurs conclusions n'engagent ni le Board of Governors ni la Fed de Richmond. Ils qualifient eux-mêmes de spéculatives leurs implications de stabilité financière, et écartent la question de la monoculture de modèle de leur périmètre.
- Ma source sur l'usage de récupération documentaire en gestion des risques vient d'une équipe interne à une banque commerciale, qui documente et valorise son propre outil. C'est un résultat auto-rapporté, et je n'ai identifié aucune réplication indépendante.
Biais cognitifs que cette situation peut déclencher
- Heuristique de représentativité : un taux de succès impressionnant, comme les 93,3 % rapportés par Lopez-Lira et Tang, se lit spontanément comme une précision de prévision titre par titre et comme une preuve de compétence. C'est en réalité la proportion de journées où un portefeuille agrégé est correctement orienté, et son interprétation dépend d'une condition méthodologique, le test strictement post-cutoff.
- Biais de surconfiance : une performance chiffrée avec précision, un ratio de Sharpe brut de 6,54 par exemple, inspire une confiance disproportionnée à la robustesse réelle de la méthode qui l'a produite et au coût de sa mise en œuvre.
- Biais des coûts irrécupérables : une fois un outil de prévision fondé sur un LLM intégré aux processus de décision, l'abandonner malgré des signaux de contamination mémorielle devient plus coûteux à assumer, ce qui peut retarder la révision du dispositif.
Lexique
- LLM· Grand modèle de langage↗
- Modèle d'intelligence artificielle entraîné sur de vastes corpus de texte pour prédire et générer du langage, capable de tâches d'analyse, de synthèse et de génération de texte en langage naturel sans avoir été explicitement programmé pour la tâche demandée.
- Date de coupure· knowledge cutoff↗
- Date au-delà de laquelle les données d'entraînement d'un modèle ne contiennent plus d'information. Tout ce qui s'est produit après cette date est, en principe, inconnu du modèle sous sa forme figée : sauf à avoir été introduit via le contexte du prompt.
- Biais de rétrospection· look-ahead bias↗
- Biais qui survient lorsqu'une méthode de prévision est testée sur une période pour laquelle l'issue était déjà connue au moment de la construction ou de l'entraînement du modèle, ce qui gonfle artificiellement sa performance apparente.
- Mémorisation↗
- Capacité d'un modèle à restituer, sous forme de réponse apparemment analytique, une information factuelle qu'il a rencontrée telle quelle pendant son entraînement, plutôt que d'en inférer la valeur par un raisonnement généralisable. Rend la prévision sur données pré-cutoff statistiquement non identifiable.
- Overfitting de backtest↗
- Pratique consistant à tester un grand nombre de configurations d'une même stratégie sur les mêmes données historiques jusqu'à en trouver une qui affiche une performance simulée élevée, sans que cette performance se maintienne hors échantillon. Précédent pré-LLM du problème de mémorisation, documenté dès 2014 par Bailey, Borwein, López de Prado et Zhu.
- Non-identifiabilité↗
- Situation où deux mécanismes distincts (compétence prédictive réelle et mémorisation) produisent des résultats observables strictement indiscernables, rendant impossible de déterminer lequel est à l'œuvre à partir des seules sorties du modèle.
- Ratio de Sharpe· Sharpe ratio↗
- Mesure de la performance d'une stratégie d'investissement rapportée au risque pris, calculée comme le rendement excédentaire divisé par l'écart-type des rendements. Sa version « déflatée » corrige ce ratio pour le biais de sélection et l'overfitting de backtest lorsque de nombreuses configurations ont été testées.
- Hallucination↗
- Production par un modèle d'une information fausse ou inventée, présentée avec la même assurance qu'une information correcte, sans signal explicite d'incertitude.
- RAG· Retrieval-Augmented Generation↗
- Architecture dans laquelle un modèle de langage ne répond pas uniquement à partir de sa mémoire d'entraînement, mais récupère d'abord des passages pertinents dans une base documentaire externe avant de formuler sa réponse. Cela lui fournit une source externe vérifiable et peut réduire sa dépendance à la mémoire paramétrique, sans supprimer la mémorisation acquise pendant l'entraînement ni le risque d'hallucination.
- Comportement grégaire· herding↗
- Tendance d'acteurs de marché à aligner leurs décisions sur celles des autres plutôt que sur leur propre analyse, indépendamment de la pertinence de cette convergence, et qui peut amplifier les mouvements de prix. Identifié par la Fed comme un risque systémique si de nombreux acteurs convergent vers les mêmes modèles fondamentaux.
Indice de solidité des preuves · le détail
56 / 100 · Preuves modérées · fourchette 56-75 %
Score établi le 30 août 2026. Une révision ultérieure est une réévaluation datée, pas une correction masquée.
- Un évaluateur détiendrait un jeu d'items de prévision jamais rendu public, construit après la date de coupure du modèle évalué, et n'en publierait ni les items ni les réponses, de sorte que la garantie contre la mémorisation cesse de reposer sur la seule antériorité de titres d'actualité qui, eux, circulent.Un opérateur d'évaluation tierce exécutant lui-même les soumissions, du type HELM (Stanford CRFM) ou MLCommons · un dispositif approchant existe, sans remplir la condition
- Les soumissions seraient exécutées par cet évaluateur sur une version figée du modèle, sous protocole et budget de calcul arrêtés avant la collecte, plutôt que sur une version que le fournisseur peut mettre à jour sans préavis pendant la période de test.Le même évaluateur tiers, avec un accès à version figée obtenu du fournisseur du modèle · un dispositif approchant existe, sans remplir la condition
- Plusieurs graines et un intervalle seraient rapportés pour le taux de bonne orientation quotidienne du portefeuille, de sorte que le non-déterminisme du modèle apparaisse dans le chiffre publié au lieu d'être absorbé par une exécution unique.L'évaluateur tiers qui exécute les soumissions · un dispositif approchant existe, sans remplir la condition
- Le modèle n'accéderait aux items par aucun autre canal que l'épreuve elle-même, la récupération documentaire et les outils connectés étant coupés ou journalisés pendant le test, de sorte que la date de coupure cesse d'être contournable par une source ouverte au moment de la réponse.L'évaluateur tiers, qui contrôle l'environnement d'exécution · un dispositif approchant existe, sans remplir la condition
Ce dispositif porterait l'indice à 62 sur 100, dans le palier « Preuves modérées ». Les trois autres axes restent à leur valeur actuelle : un dispositif ne fait monter ni la convergence d'une littérature ni sa réplication.
Modification apportée · mis à jour le 4 septembre 2026
- J'ajoute trois encadrés « En clair » qui expliquent en langue courante les mécanismes des trois sections porteuses : ce qui sépare deviner une réaction de gagner dessus, la fuite d'information par mémorisation, et pourquoi une régularité s'use une fois publiée.
- Reprise sur les formulations qui racontaient ma propre démarche de lecture plutôt que ce que les sources établissent. Chaque occurrence, en citations, dans le corps de texte et en bibliographie, est reformulée pour énoncer un fait sur l'état de publication du document, jamais un aveu sur ce que j'en ai lu.
- Le travail de McLean et Pontiff, jusqu'ici laissé de côté faute de lecture, a été retrouvé sous une version de travail de 2012 et lu en entier. Son mécanisme est intégré au texte : sur 82 caractéristiques testées, un déclin hors échantillon d'environ 10 % (non significatif) et un déclin post-publication académique d'environ 35 % (significatif), attribué à un biais statistique et à l'arbitrage d'investisseurs informés. La réserve que cette version diffère de la publication finale de 2016 (dont des résumés secondaires rapportent des chiffres plus élevés) est explicite.
Voir les 11 autres
- Sa citation en bibliographie, jusqu'ici sans adresse, reçoit l'adresse de cette version de travail.
- Provenance des sources. Les chiffres de coûts viennent de l'annexe en ligne F de Lopez-Lira et Tang, version du 28 octobre 2025. J'avais écrit qu'ils venaient d'une révision d'août 2026 : cette version n'existe pas. L'article est par ailleurs paru au Journal of Financial Economics, vol. 184, article 104335.
- Deux sources retirées. Les trois pourcentages de Chuan Liang venaient du résumé déposé par l'auteur, pas de son document, qui n'est pas consultable. Ils sont retirés avec leur graphique. Le parallèle avec McLean et Pontiff est retiré pour la même raison : je n'ai pas lu ce travail.
- Un homonyme corrigé. La « mémoire » de Bailey et coauteurs est l'autocorrélation d'une série simulée, pas la mémorisation d'un corpus. Le rapprochement porte désormais sur la signature observable, jamais sur le mécanisme.
- Attributions resserrées. Hansen et Lee n'est pas un travail de la Réserve fédérale mais un préprint dont les auteurs précisent qu'il n'engage pas leurs institutions. L'ordre des auteurs de FAITH est rétabli.
- Deux erreurs que j'avais introduites en corrigeant : le ratio de Sharpe de 1,26 appartient à DistilBart-MNLI et non à Llama 2, qui vaut 0,97 ; et une part de 39,5 % d'observations à retirer ne veut pas dire « une poignée de souvenirs », elle veut dire l'inverse, un rappel diffus.
- Chiffres recalés sur ce que les sources autorisent : erreur de rappel en relatif et non en points, rappel post-coupure sur 6 à 17 observations, datation qui ne marche que pour Apple, effectifs de FAITH, rotation à sens unique, niveaux de coûts posés en hypothèse.
- Résultats contraires ajoutés, parce qu'ils manquaient : Didisheim et coauteurs concluent qu'un backtest fiable reste faisable avec leur méthode ; Hansen et Lee montrent qu'en inversant le codage des signaux, un quart des décisions de leurs agents deviennent erronées ; Lopez-Lira et Tang réservent l'exploitation du signal aux acteurs à coûts très bas, teneurs de marché en tête.
- Trois sujets ajoutés : ce que la récupération documentaire fait à la garantie de la date de coupure, le risque de données de l'usage documentaire, et une mention de non-conseil en pied d'article.
- Les quatre figures sont refaites. Elles portaient encore des formulations retirées du texte.
- L'indice de solidité de la preuve passe de 59 à 56 : la puissance se lit désormais sur les quelques centaines d'observations qui portent le volet mémorisation, pas sur les 159 137 du volet signal.
Axel Morel · Fondateur & analyste, Probans
Développe une méthode d'analyse destinée à distinguer ce que les preuves établissent, ce qu'elles suggèrent et ce qu'elles ne permettent pas de conclure, puis à traduire cette distinction en décisions professionnelles.
Choix du sujet, direction de la rédaction, validation ou modification des sources, validation et retravail du texte et des illustrations : Axel Morel. Rédaction, choix des sources initiales et plan de rédaction initial : assistance IA.
Responsabilité éditoriale : Axel Morel. Recherche et rédaction assistées par IA selon la méthodologie Probans, sources vérifiées avant publication. Charte éditoriale.
En savoir plusNewsletter Probans
Recevoir les prochaines analyses
Choix par catégorie · Sans spam · Désabonnement en 1 clic