# Test-time compute : un calcul qui se paie à chaque réponse, pas une fois
> Un calcul supplémentaire mobilisé au moment de répondre, pas pendant l'entraînement : Snell et al. (2024) montrent qu'à budget de calcul égal, cette dépense peut battre un modèle plus gros, un principe qui dépasse le nom du modèle en cours à la date de lecture.
- Source : https://probans.org/ia/comprendre-modeles-post-llm/test-time-compute-pourquoi-modeles-reflechissent/
- Catégorie : Intelligence artificielle
- Auteur : Axel Morel
- Publié le : 2026-07-16
- Mis à jour le : 2026-09-03
## En résumé
- Le calcul se dépense au moment de répondre. Un modèle qui mobilise du test-time compute ne produit pas sa réponse d'un seul passage : il explore plusieurs pistes de raisonnement, révise des étapes intermédiaires, écarte des impasses, avant de livrer une réponse finale.
- Un seul écart de taille a été testé. Snell et al. (2024) testent un seul écart de taille, un facteur d'environ 14 entre le petit modèle et le grand. Sur les questions difficiles ou à forte charge d'inférence, les auteurs eux-mêmes écrivent qu'investir ce même budget dans l'entraînement d'un modèle plus gros reste probablement plus efficace.
- Cette dépense ne s'amortit pas. Un coût d'entraînement se paie une fois, s'amortit sur des millions de requêtes, et devient vite marginal à l'échelle. Un coût de test-time compute se répète à chaque requête, sans jamais s'amortir de la même façon : il ressemble davantage à une charge d'exploitation récurrente qu'à un investissement ponctuel.
Pendant longtemps, améliorer un modèle d'intelligence artificielle a voulu dire une seule chose : l'entraîner plus longtemps, sur plus de données, avec plus de paramètres. Une dépense unique, consentie une fois, avant la mise en service. Un principe distinct a pris de l'ampleur depuis 2024 : dépenser du calcul supplémentaire non plus à l'entraînement, mais au moment même de répondre à une question. Ce principe porte un nom précis, le **test-time compute**, et il ne décrit pas une nouvelle faculté de réflexion chez la machine : il déplace où et quand l'argent du calcul est dépensé.
## Une définition simple : calculer plus au moment de répondre
*Ce que les données établissent.* Le test-time compute désigne le calcul mobilisé au moment où un modèle traite une requête, le "moment du test", par opposition au calcul d'entraînement qui façonne ses paramètres une fois pour toutes en amont. Concrètement, un modèle qui mobilise du test-time compute ne produit pas sa réponse d'un seul passage : il explore plusieurs pistes de raisonnement, révise des étapes intermédiaires, écarte des impasses, avant de livrer une réponse finale. Ce travail préparatoire a un coût direct et mesurable : un temps de réponse plus long, et une consommation de calcul, donc d'énergie, plus élevée que pour une réponse produite d'un seul tenant.
## Deux illustrations déjà connues, pour ancrer le principe
Ce dossier documente déjà deux applications concrètes de ce principe, que je ne reprends pas ici en détail. Les **LLM de raisonnement** (o1, o3, DeepSeek-R1) génèrent une longue chaîne de raisonnement intermédiaire avant de répondre, ce qui augmente sensiblement leur consommation énergétique par requête par rapport à un LLM standard. Voir [Qu'est-ce qu'un LLM "de raisonnement" ?](/ia/comprendre-modeles-post-llm/quest-ce-quun-llm-de-raisonnement) pour la mesure chiffrée et ses limites. *Ce que les données établissent.* Le **TRM** (Tiny Recursive Model), de son côté, mobilise un usage agressif de calcul au moment du test comme l'un des facteurs qui expliquent la performance d'un checkpoint public sur le banc d'essai ARC-AGI-1, plutôt que d'un raisonnement interne arbitrairement profond. Voir [Qu'est-ce que le TRM ?](/ia/comprendre-modeles-post-llm/quest-ce-que-le-trm). Deux familles de modèles, deux mécanismes internes différents, un seul principe commun : le calcul se dépense après l'entraînement, à chaque requête, pas seulement avant.
## Le travail qui établit le principe : Snell et al. (2024)
*Ce que les données établissent.* Le fait que ce déplacement de calcul soit avantageux n'est pas une simple observation empirique sur tel ou tel modèle : c'est un résultat établi par Snell, Lee, Xu et Kumar (2024), dans "Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters" (arXiv:2408.03314). Leur travail montre que, pour un budget de calcul total donné, dépenser une part de ce budget au moment de répondre à une requête peut être plus efficace que d'investir ce même budget dans l'entraînement d'un modèle aux paramètres plus nombreux. Autrement dit, à ressources de calcul égales, un modèle plus petit qui "réfléchit" davantage avant de répondre peut surpasser un modèle plus gros qui répond directement.
*Ce que la méthode interprète.* Ce résultat ne dit pas que le test-time compute l'emporte toujours sur l'entraînement d'un plus gros modèle, dans toutes les conditions. Snell et al. (2024) testent un seul écart de taille, un facteur d'environ 14 entre le petit modèle et le grand. Sur les questions faciles à moyennes et à charge d'inférence modérée, le petit modèle qui mobilise du test-time compute peut y battre le plus grand qui répond directement. Sur les questions difficiles ou à forte charge d'inférence, les auteurs eux-mêmes écrivent qu'investir ce même budget dans l'entraînement d'un modèle plus gros reste probablement plus efficace. Aucun écart de taille supérieur à 14 n'a été testé : rien n'autorise à dire ce qui se passerait au-delà. C'est une nuance apportée à un réflexe d'ingénierie qui semblait acquis, pas son renversement complet.
## Le vrai changement : un nouvel arbitrage, pas une nouvelle faculté cognitive
**En clair.** Une dépense faite une fois avant la mise en service se répartit ensuite sur toutes les questions posées, et pèse de moins en moins par question à mesure qu'il y en a. Une dépense engagée à chaque question, elle, revient entière à chaque fois : elle ne se dilue jamais.
*Ce que la méthode interprète.* Le mot "réfléchir" prête à confusion s'il suggère une conscience ou un raisonnement comparable à celui d'un humain. Ce qui change est économique : le test-time compute déplace un arbitrage classique de l'IA. Avant, l'arbitrage se formulait ainsi : un modèle plus gros coûte plus cher à entraîner une fois, mais coûte relativement peu à faire tourner ensuite, requête après requête. Le test-time compute installe un second arbitrage, distinct du premier : un modèle plus petit, moins coûteux à entraîner, mais dont chaque réponse individuelle coûte plus cher à produire, parce qu'elle mobilise un calcul supplémentaire à chaque usage.
Cette bascule change la nature même du coût à surveiller. Un coût d'entraînement se paie une fois, s'amortit sur des millions de requêtes, et devient vite marginal à l'échelle. Un coût de test-time compute se répète à chaque requête, sans jamais s'amortir de la même façon : il ressemble davantage à une charge d'exploitation récurrente qu'à un investissement ponctuel. Pour qui évalue le coût réel d'un usage de l'IA à grande échelle, la question à poser change en conséquence : elle n'est plus seulement "quelle est la taille du modèle", mais "quelle part du coût de chaque réponse vient du calcul dépensé après l'entraînement, à cette occasion précise".
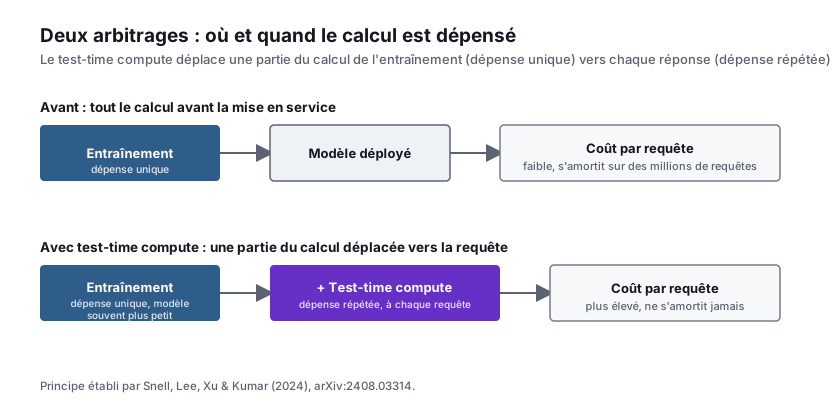
> Le test-time compute n'ajoute pas une faculté de réflexion aux modèles : il déplace où se paie le calcul, de l'entraînement (une dépense unique) vers chaque réponse individuelle (une dépense répétée), un arbitrage qui reste pertinent quel que soit le modèle en cours à la date de lecture.
## Le test du raisonnement recyclable : une question à se poser avant de payer
**En clair.** Quand la même suite d'étapes est refaite à l'identique d'une demande à l'autre, on la paie autant de fois qu'on la refait. La figer une bonne fois, dans une consigne ou une règle, la fait payer une seule fois. Rien à figer si chaque demande est vraiment nouvelle.
*Ce que la méthode interprète.* La lecture la plus courante de Snell et al. (2024) s'arrête à un seul niveau : "dépenser du calcul au moment de répondre peut battre un modèle plus gros". Elle ne dit rien de ce que doit surveiller celui qui paie effectivement ce calcul à chaque requête, une fois le choix d'architecture fait en amont par le laboratoire : continuer à payer du test-time compute est-il un choix rationnel pour cet usage précis, ou un réflexe ? Un critère simple permet de trancher, sans dépendre du nom du modèle en cours : pour une classe de requêtes donnée, le raisonnement que le modèle reconstruit à chaque fois est-il redit à l'identique d'une requête à l'autre, ou reconstruit-il à neuf un problème structurellement différent ?
Si le raisonnement est **recyclable** (le modèle redérive, requête après requête, une chaîne de déduction proche pour un même type de cas), le test-time compute n'est pas le bon candidat. La raison tient à l'arbitrage exposé plus haut : un coût de test-time compute ne s'amortit jamais, il se répète identique à chaque requête, alors qu'un coût figé une fois (un prompt travaillé, un cache, un modèle affiné) s'amortit sur toutes les requêtes suivantes de la même classe. Payer, à chaque nouvelle requête, pour reconstruire un raisonnement déjà tenu hier revient à refuser cet amortissement disponible. Exemple concret : un système qui rapproche des factures avec leurs bons de commande applique, requête après requête, une chaîne de vérification presque identique (mêmes champs comparés, mêmes règles de tolérance) ; router ce flux vers un modèle de raisonnement revient à repayer, à chaque facture, un raisonnement qui pourrait être figé une bonne fois dans un prompt ou une règle de validation.
Si le raisonnement est **jetable** (chaque requête pose un problème réellement nouveau), le test-time compute reste le bon choix : il n'y a rien à amortir sur de l'unique. Ce critère de recyclabilité est distinct de celui que posent Snell et al. (2024) sur la difficulté de la question : même un raisonnement jetable reste, sur une question difficile ou à charge d'inférence élevée, un cas où leurs résultats indiquent que le pré-entraînement d'un modèle plus gros reste probablement plus efficace (voir plus haut). Exemple concret : une équipe qui triage des tickets de support inédits, chacun avec son propre contexte, son propre historique client et sa propre combinaison de symptômes, n'a rien à mettre en cache d'un ticket à l'autre.
Ce critère est un guide de lecture, pas un résultat mesuré : aucune source citée ici ne quantifie le gain réel de l'amortissement, à vérifier au cas par cas.
Comment appliquer ce test sur son propre usage, sans nouvelle donnée à collecter : prendre un échantillon des dernières requêtes envoyées à un modèle de raisonnement, les regrouper par type de tâche, puis comparer à l'œil les chaînes de raisonnement produites (visibles ou reconstructibles) au sein d'un même groupe. Un groupe où ces chaînes se ressemblent fortement d'une requête à l'autre est un candidat à l'amortissement ; avant de généraliser, tester le remplacement (prompt figé, cache, modèle affiné) sur ce sous-ensemble précis et vérifier que la qualité de réponse ne se dégrade pas, plutôt que de basculer tout le flux d'un coup.
Ce critère ne remplace pas le calcul de coût par bonne réponse détaillé dans la fiche sœur sur les LLM de raisonnement : il se situe un cran au-dessus, sur une classe entière de requêtes plutôt que sur une tentative isolée, et reste applicable à tout modèle qui "réfléchit" avant de répondre.
## Mes réserves
- Le résultat de Snell et al. (2024) est mesuré sur un seul domaine de tâche (des problèmes de mathématiques du benchmark MATH) et un seul modèle de base (PaLM 2-S*) : il établit qu'un déplacement vers le test-time compute peut être plus efficace sur ce périmètre précis, pas qu'il l'est systématiquement, pour toute tâche et tout budget.
- Les deux illustrations mobilisées ici (LLM de raisonnement, TRM) appliquent ce même principe général à travers des mécanismes internes très différents l'un de l'autre. Le principe qui les relie est celui du déplacement de calcul vers le moment de la réponse, pas une architecture commune sous-jacente.
- Le surcoût énergétique des LLM de raisonnement dépend du scénario mesuré, pas d'une constante physique universelle : le chiffrage disponible et ses limites sont traités dans la fiche sœur sur les LLM de raisonnement, pas repris ici.
- Le test du raisonnement recyclable proposé ci-dessus est un critère de lecture, pas un résultat empirique mesuré : aucune source citée ici ne quantifie le gain réel obtenu en amortissant un raisonnement recyclable plutôt qu'en le repayant en test-time compute à chaque requête.
Le nom du modèle qui illustre ce principe aujourd'hui aura changé la prochaine fois que ce dossier sera relu. Le principe, lui, reste stable : un calcul dépensé au moment de répondre plutôt qu'à l'entraînement déplace un arbitrage économique de fond, pas seulement une performance sur un banc d'essai donné.
Retour au [dossier « Comprendre les modèles post-LLM »](/ia/comprendre-modeles-post-llm). Voir aussi les fiches sœurs : [Qu'est-ce qu'un LLM "de raisonnement" ?](/ia/comprendre-modeles-post-llm/quest-ce-quun-llm-de-raisonnement) et [Qu'est-ce que le TRM ?](/ia/comprendre-modeles-post-llm/quest-ce-que-le-trm).
## Sources
- [Snell, C., Lee, J., Xu, K., & Kumar, A. (2024). Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. arXiv:2408.03314.](https://arxiv.org/abs/2408.03314)
- [Note technique (2026). Tiny Recursive Models on ARC-AGI-1: Inductive Biases, Identity Conditioning, and Test-Time Compute. arXiv:2512.11847.](https://arxiv.org/abs/2512.11847)
---
Publié sur Probans : https://probans.org/ia/comprendre-modeles-post-llm/test-time-compute-pourquoi-modeles-reflechissent/