# DeepSeek R1 n'active que 37 de ses 671 milliards de paramètres
> Une architecture à mélange d'experts ne met en jeu, pour chaque token, qu'une fraction de ses paramètres, sélectionnée par un mécanisme de routage. C'est ce qui sépare les 671 milliards de paramètres affichés par DeepSeek R1 des 37 milliards que sa fiche donne pour activés.
- Source : https://probans.org/ia/comprendre-modeles-post-llm/mixture-of-experts-deepseek-r1/
- Catégorie : Intelligence artificielle
- Auteur : Axel Morel
- Publié le : 2026-07-13
- Mis à jour le : 2026-09-04
- Indice de solidité de la preuve (ISP-IA) : 41/100 (31-55 %, Preuves limitées), score établi le 2026-09-04
## En résumé
- Huit experts sur 256 travaillent à chaque token. Le rapport technique de V3 donne le décompte : un expert partagé et 256 experts routés, dont 8 sont activés pour chaque token. La fiche de modèle de R1, elle, donne les décomptes de paramètres sans expliquer la sélection.
- Les 37 milliards actifs sont moins que Llama-3.1-70B. Rapproché des 70 milliards de Llama-3.1-70B, il est du même ordre de grandeur, inférieur même. Ce que ce rapprochement ne fait pas, en revanche, c'est comparer deux calculs : il compare deux décomptes de paramètres, et aucune de mes sources ne mesure le calcul par token de l'un ou de l'autre.
- DeepSeek publie elle-même ce que son service lui coûte. Ramenés au coût horaire du nœud, ces débits donnent environ 0,06 dollar par million de tokens en entrée et 0,30 dollar en sortie. Facturé au tarif de R1 alors en vigueur, le coût d'infrastructure de 87 072 dollars sur cette fenêtre de 24 heures aurait généré 562 027 dollars de recettes, soit une marge théorique de 545 %.
671 milliards de paramètres, mais 37 milliards seulement mobilisés pour produire chaque mot d'une réponse. Ce chiffre surprend tant qu'on n'a pas vu le mécanisme qui le rend possible : une architecture, la **mixture of experts** (mélange d'experts, MoE), qui change la relation entre la taille affichée d'un modèle et le calcul qu'il exécute réellement.
## Ce que le mot « dense » désigne
*Définition, pas un résultat de mes sources.* On appelle dense une architecture de transformeur qui n'est pas découpée en experts. Le mot est celui de Meta, qui écrit avoir retenu pour Llama 3 « a standard dense Transformer model architecture […] rather than for a mixture-of-experts model », et qui donne pour motif la stabilité d'entraînement, pas le coût de calcul.
Cette même source situe elle-même le mélange d'experts comme une architecture alternative : elle nomme Mixtral et Arctic, dit les battre en performance (« Llama 3 outperforms these models »), tout en reconnaissant qu'« there remain numerous trade offs in terms of training and inference efficiency » entre les deux familles. L'arbitrage entre dense et mélange d'experts sur l'efficacité d'inférence n'est donc pas tranché, y compris par le producteur qui sert ici de repère de comparaison.
*Ce que la méthode interprète.* Je lis cette conception comme celle où la taille du modèle et le calcul par token varient ensemble, faute d'un mécanisme qui mette une partie du réseau au repos. Aucun des documents que j'ai relevés ne chiffre ce calcul, ni pour un modèle dense, ni pour un mélange d'experts : c'est une lecture de l'architecture, pas une mesure.
## Le routage : n'activer qu'une poignée d'experts
**En clair.** Le réseau est découpé en sous-réseaux spécialisés. À chaque fragment de texte produit, un aiguilleur en désigne quelques-uns, et eux seuls travaillent ; les autres restent au repos. Le modèle conserve donc l'ensemble de ses connaissances, tout en n'en mobilisant qu'une petite part pour répondre.
*Ce que les données établissent.* Une architecture à mélange d'experts rompt ce lien. Le réseau est découpé en sous-réseaux spécialisés, appelés experts, et un mécanisme de routage sélectionne, pour chaque token, ceux qui le traiteront. Le rapport technique de V3 donne le décompte : un expert partagé et 256 experts routés, dont 8 sont activés pour chaque token. La fiche de modèle de R1, elle, donne les décomptes de paramètres sans expliquer la sélection : le mécanisme de routage lui-même n'est détaillé dans aucune de mes sources.
## Le chiffre DeepSeek R1, remis en contexte
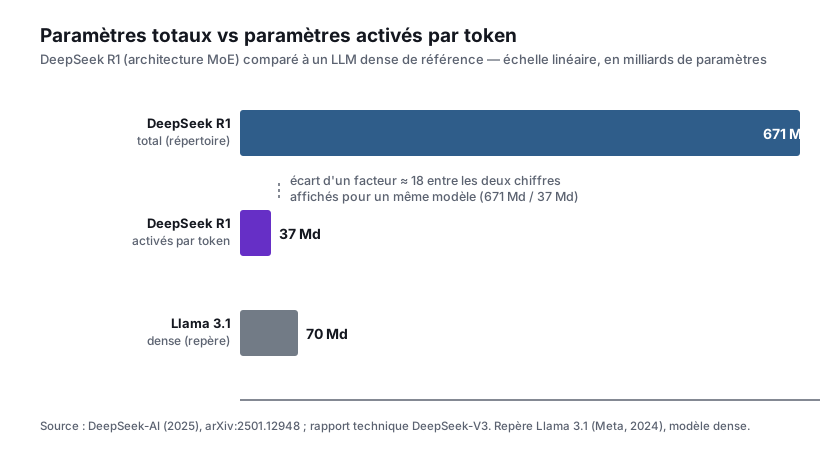
*Ce que les données établissent.* La fiche de modèle de DeepSeek-R1 donne 671 milliards de paramètres au total et 37 milliards activés, et précise que R1 est entraîné à partir de DeepSeek-V3-Base : les deux modèles partagent donc l'architecture à mélange d'experts détaillée dans le rapport technique de V3, où ces mêmes valeurs figurent. Une précision sur le premier chiffre : le papier R1 le donne deux fois, différemment, « # Total Params 671B » en table 8 et « 660B R1-Zero and R1 » en annexe B.4.4. Je retiens 671, qui est la valeur de la table et celle de la fiche de modèle ; l'écart n'est expliqué nulle part. Le rapport entre 671 et 37, un facteur d'environ 18, est un rapport entre le nombre de paramètres affiché et le nombre activé par token.
*Ce que la méthode interprète.* Ce chiffre de 37 milliards de paramètres actifs mérite d'être comparé à autre chose qu'au total de 671 milliards du même modèle, sans quoi il ne dit pas grand-chose. Rapproché des 70 milliards de Llama-3.1-70B, il est du même ordre de grandeur, inférieur même. Le repère tient : Meta écrit que « Llama 3 uses a standard, dense Transformer architecture » et donne les hyperparamètres des trois tailles, 8, 70 et 405 milliards, sous cette même description, la table 1 précisant que tous les résultats du papier portent sur les modèles 3.1. La variante à 70 milliards est donc un modèle dense au sens de son producteur. Je retiens cette taille plutôt que 8 ou 405 milliards parce qu'elle est la plus proche en ordre de grandeur des 37 milliards actifs de R1 ; les deux autres, très en dessous ou très au-dessus, auraient donné un rapprochement moins lisible. Ce que ce rapprochement ne fait pas, en revanche, c'est comparer deux calculs : il compare deux décomptes de paramètres, et aucune de mes sources ne mesure le calcul par token de l'un ou de l'autre.
## Pourquoi ce découplage compte économiquement
**En clair.** Ce qu'une réponse coûte à produire suit le calcul réellement exécuté, pas la taille annoncée du modèle. Deux modèles de même taille affichée peuvent donc mobiliser des quantités de calcul très différentes selon qu'ils réveillent tout leur réseau ou une fraction seulement. La taille affichée seule ne renseigne pas sur la facture.
*Ce que la méthode interprète.* Le coût d'inférence tient au calcul effectivement exécuté, et le mélange d'experts découple ce calcul du total affiché. C'est une lecture du mécanisme, pas un résultat de mes sources : aucun des documents relevés ici ne mesure la relation entre paramètres activés et coût de calcul, et le rapport d'inférence de DeepSeek ne dit rien de la mémoire nécessaire au chargement des poids ni de la précision employée.
Un modèle dense de 671 milliards mettrait en jeu, à chaque token, l'intégralité de ces paramètres. Un modèle à mélange d'experts de même taille totale n'en active que 37 milliards par token, à l'échelle du réseau entier : le rapport technique de V3 donne ce chiffre comme un total, sans le décomposer entre l'attention et les couches d'experts, et aucune de mes sources ne fait cette décomposition. Le répertoire de connaissances est là dans les deux cas ; le calcul, non.
> DeepSeek R1 n'est pas un modèle de 671 milliards de paramètres qui calcule avec 671 milliards de paramètres : c'est un modèle qui en contient 671 milliards et n'en active, par token, que 37, soit moins que les 70 milliards de Llama-3.1-70B, un rapprochement de deux décomptes de paramètres et non une mesure de calcul, le seul point de comparaison retenu ici.
## Ce que ça vaut en dollars, sur les chiffres que DeepSeek publie
*Ce que les données établissent.* DeepSeek a publié elle-même, fin février 2025, le coût d'infrastructure de son service d'inférence sur une fenêtre de 24 heures allant du 27 février à midi au 28 février à midi (UTC+8) : 226,75 nœuds en moyenne, chaque nœud regroupant 8 GPU H800. Le tarif de location, lui, n'est pas constaté mais posé : DeepSeek écrit « Assuming the leasing cost of one H800 GPU is $2 per hour », soit 16 dollars par heure et par nœud. Tout ce qui suit hérite de cette hypothèse. Sur cette fenêtre, chaque nœud traitait en moyenne environ 73 700 tokens par seconde en entrée, cache compris, et 14 800 en décodage (génération de la réponse) : sur les 608 milliards de tokens d'entrée de la journée, 342 milliards, soit 56,3 %, ont été servis par le cache sur disque, ce qui fait du chiffre d'entrée un débit de service et non un débit de calcul pur. Ramenés au coût horaire du nœud, ces débits donnent environ 0,06 dollar par million de tokens en entrée et 0,30 dollar en sortie. Ces deux chiffres sont une moyenne sur tout le trafic V3 et R1 de la journée, pas un chiffre isolé pour R1 seul, et un plancher d'infrastructure, pas une facture par requête ; celui d'entrée, en plus, n'est pas un coût de calcul pur puisqu'il inclut le cache.
Le calcul de marge repris plus bas figure dans le rapport lui-même : ce chiffrage en dollars le vérifie et le documente, il ne le découvre pas. Mon apport propre tient au coût par token. Le rapport publie des débits et un coût de nœud, il ne les ramène pas au million de tokens, et il ne rapproche nulle part le débit d'entrée du taux de cache qu'il publie pourtant dans le même document. C'est cette composition-là que le chiffre brut ne montre pas.
*Ce que la méthode interprète.* Ce chiffre traduit en dollars ce que signifie le facteur 18 (37 milliards de paramètres actifs sur 671 milliards). Un modèle dense de 671 milliards activant l'intégralité de ses paramètres à chaque token calculerait, au même tarif horaire supposé de 2 dollars par GPU, environ 18 fois plus en sortie : sur le même matériel, le débit de décodage chuterait d'autant, portant le coût vers environ 5 dollars par million de tokens en sortie. Le volet entrée ne se prête pas au même calcul direct : le débit mesuré de 73 700 tokens par seconde inclut le cache disque à hauteur de 56,3 %, un mécanisme qui n'a aucune raison de disparaître pour un modèle dense, et multiplier ce débit dans son ensemble par 18, comme si tout relevait du calcul, surestime probablement l'écart réel pour l'entrée. Une estimation plus prudente ne porterait le facteur que sur la part effectivement calculée du trafic, autour de 44 %, ce que le rapport de DeepSeek ne permet pas d'isoler avec précision. Ce chiffre "modèle dense équivalent" reste, pour l'entrée comme pour la sortie, une extrapolation par un facteur constant et non une mesure : aucun des modèles denses documentés dans ce dossier n'atteint cette taille.
Ce même rapport publie un autre chiffre, indépendant du précédent : facturé au tarif de R1 alors en vigueur, le coût d'infrastructure de 87 072 dollars sur cette fenêtre de 24 heures aurait généré 562 027 dollars de recettes, soit une marge théorique de 545 %. DeepSeek qualifie elle-même ce chiffre de théorique et écrit que sa recette réelle est « substantially lower » : la tarification de V3, les remises hors heures de pointe et l'usage gratuit du chatbot la réduisent en pratique. Ce chiffre-là ne dit rien de l'architecture ; il tient à un tarif et à un volume.
## Mes réserves
- Le facteur 18 entre paramètres totaux et paramètres actifs mesure un rapport de taille, pas une mesure directe de coût d'inférence en euros ou en énergie : ce chiffre-là dépend aussi du matériel utilisé, une donnée déjà intégrée au chiffrage en dollars ci-dessus, pas à ce facteur seul.
- La comparaison avec les 70 milliards de paramètres de Llama-3.1-70B rapproche deux ordres de grandeur ; elle ne signifie pas que les deux modèles délivrent une qualité de réponse équivalente sur toutes les tâches, une question distincte de celle traitée ici.
- Les coûts d'infrastructure calculés ici (0,06 $ / 0,30 $ par million de tokens) sont un plancher calculé par DeepSeek à partir d'un tarif de location qu'elle pose en hypothèse, non un coût constaté. Ce n'est ni le coût qu'obtiendrait un tiers louant du matériel comparable ailleurs, ni le prix facturé aux utilisateurs de l'API, qui inclut marge, R&D et amortissement de l'entraînement.
- Ce texte ne traite pas de la mémoire à réserver pour héberger le modèle. Le savoir demanderait la spécification exacte des cartes employées par DeepSeek : mes sources donnent bien une fiche de H800, mais rien ne me permet d'établir que c'est la variante qu'elle déploie, et la fiche en documente deux dont les capacités diffèrent.
- Le coût par token ne dit rien du coût par réponse complète pour un modèle de raisonnement : le papier R1 range lui-même l'efficacité en tokens parmi ses limites reconnues, et documente un doublement de la longueur de génération en cours d'entraînement (32 768 à 65 536 tokens). Un coût par token bas peut coexister avec un coût par réponse plus élevé si le modèle produit structurellement plus de tokens.
Concrètement, un chiffre de paramètres totaux affiché seul, sans préciser s'il s'agit d'une architecture dense ou d'un mélange d'experts, ne renseigne pas sur le coût de calcul réel d'une requête. Pour DeepSeek R1, c'est le chiffre de 37 milliards de paramètres actifs, pas celui de 671 milliards, qui se rapproche le plus de ce que le modèle mobilise pour répondre. Trois questions à poser avant de dimensionner une infrastructure autour d'un modèle MoE annoncé en paramètres totaux : combien de paramètres sont réellement activés par token, puisque le calcul en dépend ; sur combien de nœuds le producteur fait tourner son propre service, chiffre que DeepSeek publie ici ; et si le coût par token annoncé est mesuré en production ou estimé à partir d'une fiche technique.
Retour au [dossier Comprendre les modèles post-LLM](/ia/comprendre-modeles-post-llm). Voir aussi [Qu'est-ce qu'un LLM de raisonnement ?](/ia/comprendre-modeles-post-llm/quest-ce-quun-llm-de-raisonnement).
## Sources
- [DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948. La taille totale y est donnée deux fois, différemment : « # Total Params 671B » en table 8, « 660B R1-Zero and R1 » en annexe B.4.4. L'annexe I précise que les poids de R1 et de R1-Zero sont publiés sur HuggingFace.](https://arxiv.org/abs/2501.12948)
- [DeepSeek-AI (2024). DeepSeek-V3 Technical Report, l'architecture à mélange d'experts sous-jacente à DeepSeek-R1 (671 milliards de paramètres au total, 37 milliards activés par token). arXiv:2412.19437.](https://arxiv.org/abs/2412.19437)
- [DeepSeek-AI. DeepSeek-R1, fiche de modèle : « Total Parameters: 671B », « Activated Parameters: 37B », et « DeepSeek-R1-Zero and DeepSeek-R1 are trained based on DeepSeek-V3-Base ». Seule source du dossier qui porte ces deux décomptes pour R1 lui-même, et non pour V3.](https://huggingface.co/deepseek-ai/DeepSeek-R1)
- [Grattafiori, A. et al. (2024). The Llama 3 Herd of Models. arXiv:2407.21783 : « Llama 3 uses a standard, dense Transformer architecture », pour une série de trois modèles à 8, 70 et 405 milliards de paramètres dont la table 1 précise que tous les résultats du papier portent sur les variantes 3.1.](https://arxiv.org/abs/2407.21783)
- [Meta. Llama-3.1-70B, fiche de modèle : donne les 70 milliards de paramètres du repère de comparaison employé ici, et décrit « an auto-regressive language model that uses an optimized transformer architecture ».](https://huggingface.co/meta-llama/Llama-3.1-70B)
- [DeepSeek-AI (février 2025). Day 6, One More Thing: DeepSeek-V3/R1 Inference System Overview (Open Source Week). Fenêtre de mesure du 27 février 12h00 au 28 février 12h00 (UTC+8). Tarif de location posé en hypothèse par DeepSeek (« Assuming the leasing cost of one H800 GPU is $2 per hour »), 226,75 nœuds de 8 GPU en moyenne, débit moyen par nœud de 73 700 tokens/s en entrée « including cache hits » et 14 800 tokens/s en décodage, 342 des 608 milliards de tokens d'entrée (56,3 %) servis par le cache sur disque.](https://github.com/deepseek-ai/open-infra-index/blob/main/202502OpenSourceWeek/day_6_one_more_thing_deepseekV3R1_inference_system_overview.md)
---
Publié sur Probans : https://probans.org/ia/comprendre-modeles-post-llm/mixture-of-experts-deepseek-r1/