# Jamba remplace-t-il l'attention par Mamba ?
> Un modèle hybride n'élimine pas l'attention : il la combine avec des composants à espace d'états : blocs Mamba en alternance chez Jamba, module d'attention partagé chez Zamba, agencement non détaillé pour Bamba, têtes SSM en parallèle dans une même couche chez Hymba. AI21 Labs présente Jamba comme le premier modèle de ce type prêt pour la production.
- Source : https://probans.org/ia/comprendre-modeles-post-llm/jamba-architectures-hybrides-mamba-transformer/
- Catégorie : Intelligence artificielle
- Auteur : Axel Morel
- Publié le : 2026-07-13
- Mis à jour le : 2026-09-24
- Indice de solidité de la preuve (ISP-IA) : 16/100 (0-30 %, Preuves très limitées), score établi le 2026-09-18
## En résumé
- Un hybride n'élimine pas l'attention : Jamba l'alterne avec Mamba. Jamba, présenté par AI21 Labs en mars 2024, alterne dans le même réseau des blocs Mamba et des blocs d'attention classique. Le modèle publié compte 52 milliards de paramètres au total, dont 12 milliards actifs à l'inférence grâce à un mélange d'experts, une fenêtre de contexte de 256 000 tokens, et des poids publiés sous licence Apache 2.0.
- Le x3 vient du fabricant, pas d'un tiers. Selon la mesure publiée par AI21 Labs elle-même, Jamba affiche un débit environ trois fois supérieur sur les contextes longs face à Mixtral 8x7B, un modèle Transformer à mixture d'experts de taille comparable, pas à un Transformer générique non identifié, un chiffre qu'aucune des sources réunies ici ne reproduit.
- AI21 (Jamba), Zyphra (Zamba) et NVIDIA avec Hymba combinent les deux mécanismes différemment. Zyphra (Zamba) partage un seul bloc d'attention entre plusieurs couches du réseau plutôt que d'en dédier un à chacune, pour obtenir les bénéfices de l'attention à un coût minimal en paramètres. Dans Hymba, des têtes d'attention et des têtes SSM tournent en parallèle dans la même couche, plutôt qu'en couches alternées comme chez Jamba, ou qu'en un module d'attention unique partagé comme chez Zamba.
Non : Jamba alterne des blocs Mamba et des blocs d'attention dans le même réseau, et le débit supérieur qu'on lui associe est un chiffre publié par AI21 Labs sur son propre modèle. Un article précédent de ce dossier explique ce qu'est Mamba : une architecture qui remplace le mécanisme d'attention par un état interne de taille fixe, pour garder un coût de calcul linéaire plutôt que quadratique sur les contextes longs. Pour mémoire en une phrase : un bloc d'attention relit tout le texte déjà généré à chaque nouveau mot, un bloc Mamba se contente de mettre à jour un état interne de taille fixe, sans relire. Je ne reviens pas plus loin sur cette mécanique : je réponds ici à une autre question, plus concrète. À quoi ressemble un modèle qui combine Mamba et attention, et qu'est-ce que ça change par rapport à un remplacement pur et simple du Transformer ?
## Hybride ne veut pas dire "à la place de"
**En clair.** Les deux mécanismes n'ont pas le même coût. Celui qui relit tout le texte déjà écrit coûte de plus en plus cher à mesure que le texte s'allonge. Celui qui tient un résumé de taille fixe reste économe.
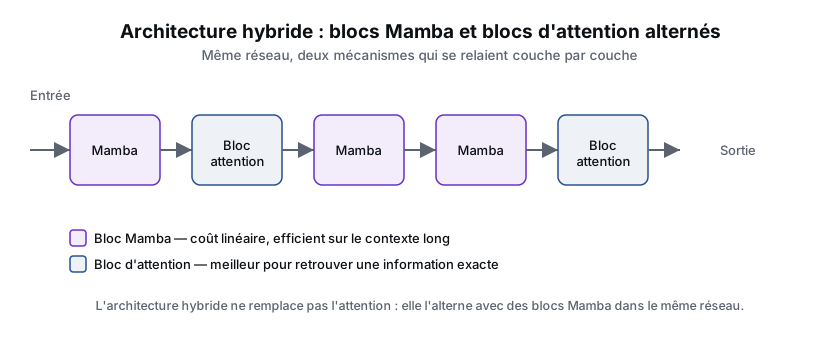
*Ce que le fabricant écrit.* Jamba, présenté par AI21 Labs en mars 2024, alterne dans le même réseau des blocs Mamba et des blocs d'attention classique. Certaines couches du modèle traitent le texte avec le balayage séquentiel de Mamba, d'autres continuent d'utiliser l'attention traditionnelle. Le modèle publié compte 52 milliards de paramètres au total, dont 12 milliards actifs à l'inférence grâce à un mélange d'experts, une fenêtre de contexte de 256 000 tokens, et des poids publiés sous licence Apache 2.0.
*Ce que la méthode interprète.* AI21 Labs revendique elle-même explicitement, dans son annonce, que Jamba est « the world's first production-grade Mamba based model » : ce n'est donc pas une inférence prudente tirée des dates de publication, mais une auto-revendication directe du fabricant, pas un fait établi par un tiers indépendant. Le papier fondateur de Jamba date de mars 2024 ; les autres architectures hybrides mentionnées plus loin dans cette fiche (Bamba, Granite 4.0, Zamba, Hymba, Nemotron-H) sont toutes documentées par des publications postérieures, ce qui est cohérent avec cette antériorité sans la démontrer par une source tierce. Si un hybride antérieur destiné à la production existe hors de cette cartographie, l'antériorité revendiquée par AI21 tomberait. Ce choix d'architecture a par ailleurs une logique simple une fois qu'on la regarde en face : les deux mécanismes n'ont pas les mêmes forces. Mamba est efficient sur le contexte long, avec un coût de calcul qui reste linéaire quand le texte s'allonge. Dans Hymba, NVIDIA attribue à l'attention un rappel « haute résolution » ; AI21 dit viser les avantages des deux familles sans les détailler. Un modèle purement Transformer resterait coûteux sur le contexte long. L'architecture hybride est un compromis d'ingénierie assumé, pas une demi-mesure : elle vise à cumuler les deux avantages plutôt qu'à trancher entre eux.
## Le chiffre qui rend ce compromis concret
*Ce que le fournisseur revendique.* Selon la mesure publiée par AI21 Labs elle-même, Jamba affiche un débit environ trois fois supérieur sur les contextes longs face à Mixtral 8x7B, un modèle Transformer à mixture d'experts de taille comparable, pas à un Transformer générique non identifié, un chiffre qu'aucune des sources réunies ici ne reproduit. Le billet d'AI21 ne précise pas la longueur de contexte de cette mesure ; Mixtral 8x7B, le comparateur, a été entraîné avec un contexte de 32 000 tokens. C'est un gain revendiqué par AI21, sans méthodologie de benchmark détaillée dans son billet d'annonce, sur un modèle dont les poids sont publiés sous licence Apache 2.0, et que son éditeur présente comme prêt pour la production : cette présentation reste, comme plus haut, une revendication du fabricant.
*Ce que la méthode interprète.* Ce x3 mérite d'être resitué à côté d'un autre chiffre : le papier fondateur de Mamba, signé Gu et Dao, annonce pour sa part 4 à 5 fois le débit d'inférence d'un Transformer de taille comparable, face à l'implémentation Transformer standard de Hugging Face, sur des prompts de 2 048 tokens, et l'un des deux modèles Mamba servant à ce calcul n'était pas entraîné. Les deux chiffres ne se comparent pas : comparateurs et configurations diffèrent.
*Ce qui entoure ce chiffre, sans le recouper.* Le x3 reste une mesure publiée par AI21 Labs elle-même. Deux éléments extérieurs permettent de le resituer sans le prendre pour acquis. Artificial Analysis, cabinet de benchmarking tiers sans lien commercial déclaré avec AI21, a chronométré le débit de sortie de Jamba 1.5 Mini sur 10 000 tokens de contexte, mais sans classement comparatif publié face à d'autres modèles : cette page ne mesure qu'un hébergeur, Amazon Bedrock, et ne compare pas Jamba à un Transformer. NVIDIA revendique de son côté pour sa propre famille hybride Nemotron-H un gain « jusqu'à 3 fois » à l'inférence face à des Transformers comparables.
*Ce que la méthode interprète.* Ni l'un ni l'autre ne réplique le chiffre précis de Jamba : Artificial Analysis ne teste pas le multiplicateur x3, et Nemotron-H est un modèle différent mesuré par son propre éditeur. Le premier élément montre seulement qu'un tiers a chronométré Jamba 1.5 Mini, un modèle ultérieur de la même famille, sans le comparer à un concurrent. Le second dit qu'un autre laboratoire, sur une autre architecture hybride, revendique un gain d'inférence pouvant aller jusqu'à 3 fois, un plafond et non une valeur comparable au x3 d'AI21. Il faut le prendre pour ce qu'il est : NVIDIA mesure son propre modèle et vend par ailleurs du matériel d'inférence, elle a donc un intérêt direct à ce que le chiffre soit élevé. Ce n'est pas un recoupement tiers, c'est une seconde revendication d'acteur intéressé, sur une architecture voisine. Ce chiffre porte sur un autre modèle, face à d'autres comparateurs : comme celui de Gu et Dao, il ne se compare pas au x3 d'AI21, qu'il ne soutient ni ne contredit. Le x3 reste une revendication de fabricant, qu'aucune mesure tierce de la même grandeur ne vient étayer.
## Jamba n'est pas un cas isolé, en une phrase
**En clair.** Alterner deux mécanismes laisse plusieurs réglages libres. On peut changer la proportion de couches accordée à chacun, faire servir un même bloc à plusieurs couches pour économiser des paramètres, ou faire tourner les deux côte à côte dans une seule couche. AI21 (Jamba), Zyphra (Zamba) et NVIDIA avec Hymba tranchent autrement.
D'autres organisations ont elles aussi combiné modèles à espace d'états et attention, selon d'autres agencements. IBM Research (Bamba, précurseur direct de Granite 4.0) combine attention et Mamba2 ; Granite 4.0 H-Small, dérivé de Bamba, compte 4 couches d'attention pour 36 couches Mamba2, le ratio de Bamba lui-même n'est pas documenté dans le billet d'IBM, et l'agencement de ces couches dans le réseau n'est décrit par aucune des deux sources. Zyphra (Zamba) partage un seul bloc d'attention entre plusieurs couches du réseau plutôt que d'en dédier un à chacune, pour obtenir les bénéfices de l'attention à un coût minimal en paramètres. NVIDIA (Hymba) va plus loin : dans Hymba, des têtes d'attention et des têtes SSM tournent en parallèle dans la même couche, chaque type de tête gardant son rôle propre (rappel précis pour l'attention, résumé de contexte pour les têtes SSM), plutôt qu'en couches alternées comme chez Jamba, ou qu'en un module d'attention unique partagé comme chez Zamba. Le détail complet de chacune dépasse le cadre de cette fiche.
## Ce que l'utilisateur final ne voit généralement pas
*Ce que la méthode interprète.* L'architecture n'apparaît généralement pas dans l'interface d'un produit. Ce qui change, c'est ce qui se passe en coulisses : le coût de calcul pour faire tourner le modèle sur un contexte long, et éventuellement la vitesse de réponse.
> Une architecture hybride n'est pas un compromis bancal entre deux logiques : c'est un choix d'ingénierie que plusieurs laboratoires ont fait, mesurable dans son coût de calcul.
## Mes réserves
- **Le gain de débit n'est pas universel.** Une étude de reclassement de documents (arXiv:2412.14354) trouve Mamba pur, sans blocs d'attention, moins efficace à l'entraînement et à l'inférence qu'un Transformer avec flash attention, sur cette tâche précise. Sur la qualité, les mêmes auteurs trouvent Mamba compétitif face à des Transformers de taille comparable, et ils attribuent l'écart d'inférence principalement au fait que le reclassement ne demande qu'une seule passe avant, là où la génération autorégressive en demande plusieurs. Ce résultat porte sur Mamba seul, pas sur une architecture hybride : rien n'indique s'il tient encore une fois des blocs d'attention réintroduits, comme chez Jamba. Il rappelle en tout cas que le gain de débit ne se transpose pas automatiquement à toute tâche ou toute configuration.
- **À l'entraînement, NVIDIA mesure un taux d'utilisation du GPU, pas une vitesse.** Une étude empirique de NVIDIA (arXiv:2406.07887) mesure la MFU (utilisation du GPU à l'entraînement) sur un hybride Mamba-2/Transformer de 8 milliards de paramètres : 29,9 %, contre 30,7 % pour un Transformer comparable. L'écart est faible, moins d'un point. Sur deux autres résultats de son résumé, cette même étude est favorable à l'hybride : il dépasse le Transformer de 8 milliards de paramètres sur les douze tâches standard évaluées, de 2,65 points en moyenne, et ses auteurs prédisent une génération jusqu'à huit fois plus rapide à l'inférence, une prédiction et non une mesure.
- **Le x3 de Jamba provient de la publication d'AI21 Labs elle-même.** Il n'a pas été reproduit tel quel par un tiers qui aurait directement chronométré Jamba face à Mixtral 8x7B dans les mêmes conditions ; ce dont je dispose, c'est d'une mesure du débit de Jamba 1.5 Mini par un tiers sans lien commercial déclaré avec AI21 (Artificial Analysis, sans classement comparatif) et d'une revendication de NVIDIA, pour son propre modèle Nemotron-H face à d'autres Transformers, d'une inférence jusqu'à 3 fois plus rapide ; NVIDIA vend par ailleurs du matériel d'inférence. Un lecteur qui a besoin du chiffre exact pour un dimensionnement d'infrastructure doit le vérifier sur son propre cas d'usage plutôt que retenir le x3 comme une constante.
**Ce qu'il faut demander à un fournisseur de LLM, concrètement**
La question "utilisez-vous Mamba" n'est pas la bonne. Quatre questions le sont davantage.
1. Le gain annoncé porte-t-il sur l'entraînement ou sur l'inférence ?
2. Sur quelle tâche et quelle longueur de contexte le gain a été mesuré ? Un gain revendiqué sur les contextes longs ne se transpose pas automatiquement à toute tâche : une étude indépendante de reclassement de documents trouve Mamba pur moins efficace à l'entraînement et à l'inférence sur cette tâche (voir plus haut).
3. Quel est le coût par token et l'empreinte mémoire du cache d'état à la longueur de contexte visée ? Ces deux métriques se demandent directement au fournisseur qui héberge le modèle, pas au multiplicateur de débit affiché en communication.
4. Le gain de débit ou de coût s'accompagne-t-il d'une perte de qualité mesurable sur des bancs d'essai standards ? Le résumé du papier d'AI21 revendique pour Jamba des performances « state-of-the-art » sur les bancs standards et en contexte long, sans chiffre à cet endroit ; aucune autre source citée ici ne documente ce compromis pour Jamba : à demander directement au fournisseur, sur ses propres résultats de qualité, pas seulement sur son débit.
Un gain annoncé pour une architecture hybride se vérifie à la longueur de contexte et sur la tâche visées ; aucune source citée ici ne mesure le gain de débit d'un hybride tâche par tâche.
Retour au [dossier « Comprendre les modèles post-LLM »](/ia/comprendre-modeles-post-llm). Voir aussi [Qu'est-ce que Mamba ?](/ia/comprendre-modeles-post-llm/quest-ce-que-mamba).
## Sources
- [Lieber et al. (2024). Jamba: A Hybrid Transformer-Mamba Language Model (AI21 Labs).](https://arxiv.org/abs/2403.19887)
- [AI21 Labs. Introducing Jamba: AI21's Groundbreaking SSM-Transformer Model (débit x3 sur contextes longs face à Mixtral 8x7B).](https://www.ai21.com/blog/announcing-jamba)
- [State Space Models are Strong Text Rerankers (quatre auteurs de l'University of Utah, 2024). arXiv:2412.14354.](https://arxiv.org/abs/2412.14354)
- [Artificial Analysis. Jamba 1.5 Mini, débit de sortie sur contextes de 10 000 tokens (mesure d'un cabinet de benchmarking tiers sans lien commercial déclaré avec AI21 ; la page ne mesure qu'un hébergeur, Amazon Bedrock, et ne classe pas Jamba face à d'autres modèles).](https://artificialanalysis.ai/models/jamba-1-5-mini/providers)
- [NVIDIA (2025). Nemotron-H: A Family of Accurate and Efficient Hybrid Mamba-Transformer Models. arXiv:2504.03624. NVIDIA mesure ici son propre modèle hybride et vend par ailleurs du matériel d'inférence : le gain « jusqu'à 3 fois » qu'elle revendique vient d'un acteur intéressé à ce qu'il soit large, ce n'est pas un recoupement tiers du chiffre d'AI21.](https://arxiv.org/abs/2504.03624)
- [IBM Research. Meet Bamba, IBM's new attention-state space model, développé avec Princeton, Carnegie Mellon et l'université de l'Illinois à Urbana-Champaign, précurseur direct d'IBM Granite 4.0.](https://research.ibm.com/blog/bamba-ssm-transformer-model)
- [IBM. Fiche modèle Granite 4.0 H-Small (architecture hybride Mamba2/Transformer, 4 couches d'attention pour 36 couches Mamba2).](https://huggingface.co/ibm-granite/granite-4.0-h-small)
- [Glorioso et al. (2024). Zamba: A Compact 7B SSM Hybrid Model (Zyphra). arXiv:2405.16712.](https://arxiv.org/abs/2405.16712)
- [Dong et al. (2024). Hymba: A Hybrid-head Architecture for Small Language Models (NVIDIA). arXiv:2411.13676.](https://arxiv.org/abs/2411.13676)
- [Waleffe et al. (2024). An Empirical Study of Mamba-based Language Models (NVIDIA), mesure de MFU comparée Mamba-2-Hybrid vs Transformer. arXiv:2406.07887.](https://arxiv.org/abs/2406.07887)
- [Jiang et al. (2024). Mixtral of Experts (Mistral AI). arXiv:2401.04088.](https://arxiv.org/abs/2401.04088)
- [Gu et Dao (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces. arXiv:2312.00752 (débit d'inférence 4 à 5 fois celui d'un Transformer de taille comparable).](https://arxiv.org/abs/2312.00752)
---
Publié sur Probans : https://probans.org/ia/comprendre-modeles-post-llm/jamba-architectures-hybrides-mamba-transformer/